carlosejimenez/seq2seq-sst2
收藏资源简介:
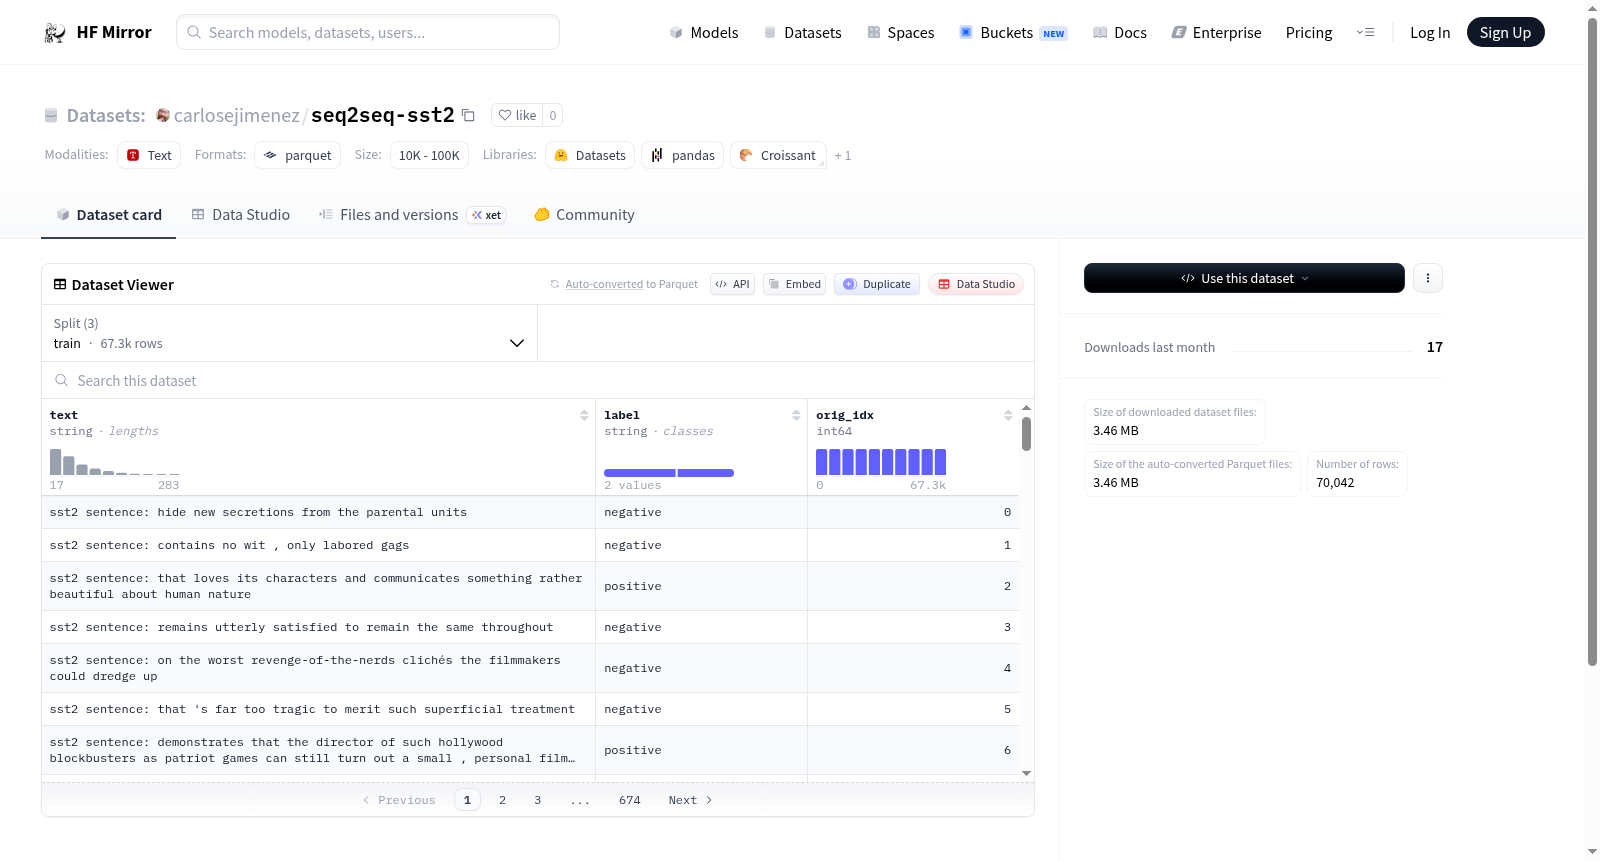
--- dataset_info: features: - name: text dtype: string - name: label dtype: string - name: orig_idx dtype: int64 splits: - name: train num_bytes: 6230630 num_examples: 67349 - name: validation num_bytes: 126308 num_examples: 872 - name: test num_bytes: 260344 num_examples: 1821 download_size: 0 dataset_size: 6617282 --- # Dataset Card for "seq2seq-sst2" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)
数据集信息: 数据特征: - 字段名:text,数据类型:字符串 - 字段名:label,数据类型:字符串 - 字段名:orig_idx,数据类型:64位整数 数据集划分: - 划分名:train(训练集),字节数:6230630,样本量:67349 - 划分名:validation(验证集),字节数:126308,样本量:872 - 划分名:test(测试集),字节数:260344,样本量:1821 下载大小:0 数据集总大小:6617282 # 「seq2seq-sst2」数据集卡片 [需补充更多信息](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)
数据集概述
数据集名称
seq2seq-sst2
数据集特征
- text: 数据类型为字符串。
- label: 数据类型为字符串。
- orig_idx: 数据类型为整数(int64)。
数据集分割
- train: 包含67349个样本,总大小为6230630字节。
- validation: 包含872个样本,总大小为126308字节。
- test: 包含1821个样本,总大小为260344字节。
数据集大小
- 下载大小: 0字节
- 数据集总大小: 6617282字节