
daven3/geobench
收藏官方服务:
资源简介:
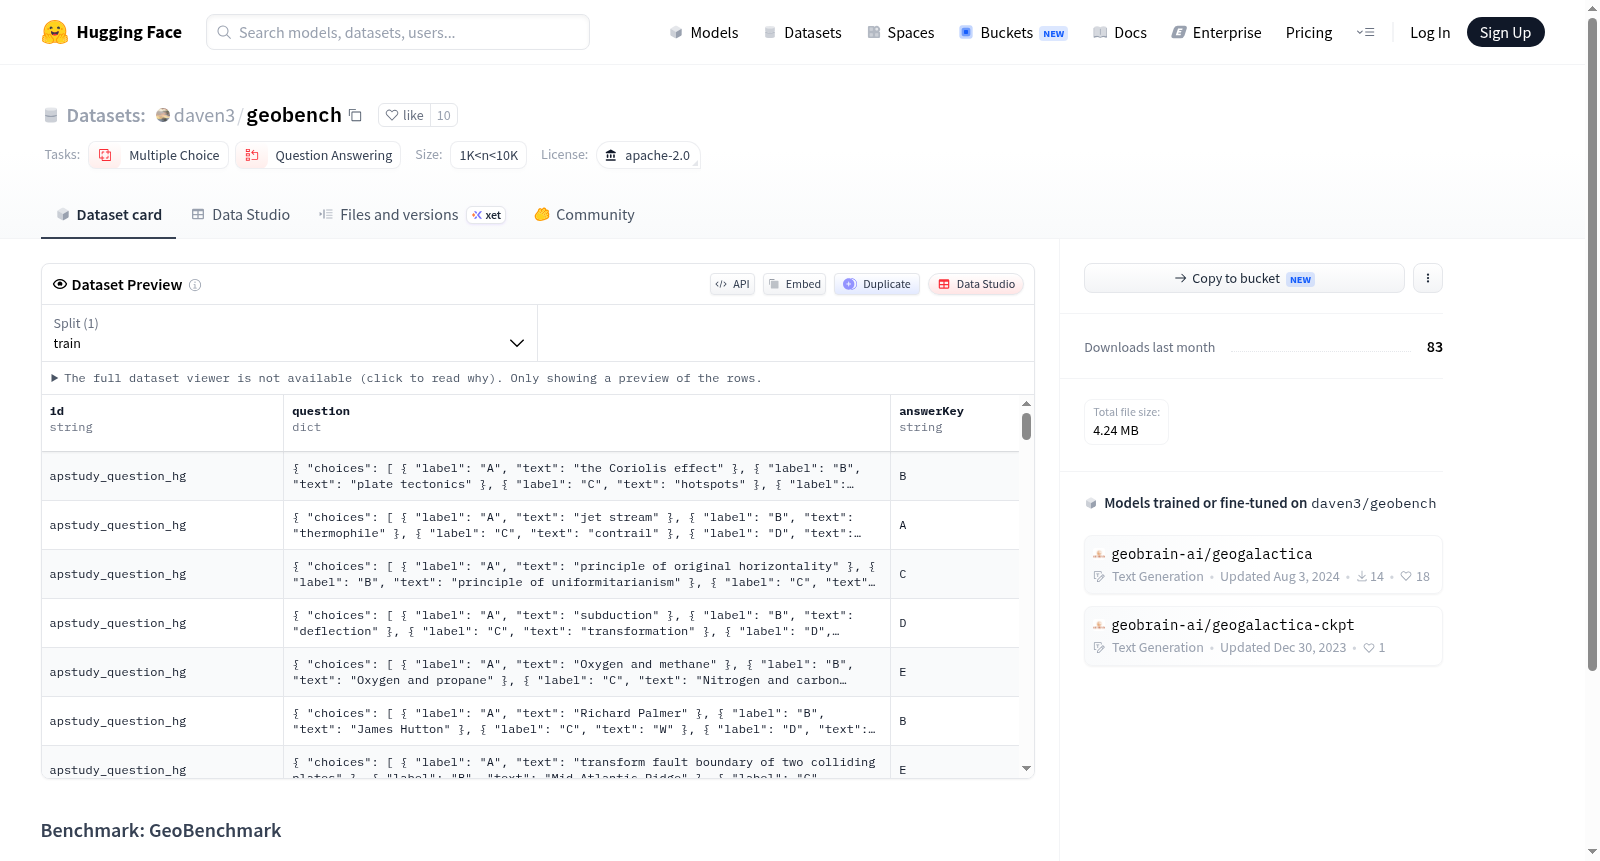
GeoBenchmark数据集包含多项选择题和问答任务。具体来说,数据集收集了183个NPEE中的多项选择题和1,395个AP Test中的多项选择题,用于客观任务。此外,还收集了939个NPEE中的主观问题作为主观任务集,并使用其中的50个问题通过人类评估来测量基线。
GeoBenchmark数据集包含多项选择题和问答任务。具体来说,数据集收集了183个NPEE中的多项选择题和1,395个AP Test中的多项选择题,用于客观任务。此外,还收集了939个NPEE中的主观问题作为主观任务集,并使用其中的50个问题通过人类评估来测量基线。
提供机构:
daven3原始信息汇总
数据集概述
数据集名称
- GeoBenchmark
许可证
- Apache-2.0
任务类别
- 多项选择
- 问答
数据集大小
- 1K<n<10K
数据集内容
- 客观任务:包含183个多项选择题(NPEE)和1,395个多项选择题(AP Test)。
- 主观任务:收集了939个主观问题(NPEE),其中50个用于人类评估基准线。
搜集汇总
数据集介绍
构建方式
GeoBench数据集的构建源于对地理学科考试题目的系统性整合,其核心素材取自中国高考(NPEE)与美国大学先修课程考试(AP Test)中的地理科目试题。在客观题部分,研究团队从NPEE中筛选了183道选择题,并从AP Test中收录了1,395道选择题,共同构成了客观任务集。针对主观题部分,则完整收集了NPEE中的全部939道主观题,并从中抽取50道题目用于基于人工评估的基线测试,从而构建了一个兼具规模与代表性的地理学评估基准。
特点
该数据集最显著的特征在于其跨文化、跨教育体系的试题融合,将中国高考与美国AP考试的地理题目纳入同一框架,为地理人工智能模型的泛化能力评估提供了独特视角。数据规模上,客观题与主观题合计超过2,500道,覆盖了从知识记忆到综合分析的多层次认知维度。此外,数据集明确区分了客观多选任务与主观问答任务,并引入了人工评估机制,使得模型性能的衡量不仅依赖于自动指标,更能反映人类对地理推理质量的判断。
使用方法
GeoBench数据集主要服务于地理领域的大语言模型评估与微调任务。使用者可将客观题部分用于多选问答任务的零样本或少样本测试,通过准确率等标准指标衡量模型的地理知识掌握程度。主观题部分则适合开展生成式问答的评估,研究者可参照数据集提供的50道人工评估样本,对模型输出的地理推理文本进行语义相似度或专家打分。数据集以Apache-2.0许可发布,便于学术研究与非商业用途的便捷接入与复现。
背景与挑战
背景概述
地理学作为一门综合性学科,其评估体系长期依赖主观题与客观题的混合模式,尤其在国家级考试如中国普通高等学校招生全国统一考试(NPEE)和美国大学先修课程(AP)测试中,地理试题的标准化与自动化评估成为教育技术领域的重要研究方向。daven3/geobench数据集由研究团队于近年创建,聚焦于地理学科的多选题与问答题评估,收录了NPEE的183道客观题与939道主观题,以及AP测试的1,395道客观题,旨在为地理知识问答与多项选择任务提供标准化基准。该数据集填补了地理学科在自然语言处理与教育测评交叉领域的空白,通过引入人类评估基线,为模型的地理推理能力提供了可量化的测试平台,对推动地理教育智能化评估具有显著影响力。
当前挑战
当前数据集面临的核心挑战源于地理学科知识的复杂性与评估任务的多样性。首先,客观题虽结构清晰,但地理概念常涉及空间关系、区域比较与因果推理,模型需超越简单模式匹配以理解隐含逻辑,这对多项选择与问答任务构成显著难度。其次,主观题涵盖939道NPEE问答题,其开放性答案要求模型具备生成连贯地理论述的能力,而现有评估仅依赖50道题的人类基线,样本量有限难以全面衡量模型表现。此外,数据构建过程中需平衡试题的学科代表性,确保覆盖自然地理与人文地理的多元主题,同时避免地域偏见,这对数据筛选与标注质量提出了高标准要求。
常用场景
经典使用场景
GeoBenchmark数据集专为地理学领域的多选与问答任务设计,其核心应用场景在于评估和比较不同自然语言处理模型在地理学知识上的理解与推理能力。通过整合中国高考地理试卷(NPEE)与美国大学先修课程(AP Test)中的客观题与主观题,该数据集为研究者提供了一个标准化、跨文化的评测基准。经典使用方式包括利用183道NPEE多选与1395道AP测试题进行模型性能的客观量化,同时借助939道NPEE主观题结合人工评估,深入分析模型在复杂地理情境下的生成与论证能力。
解决学术问题
GeoBenchmark旨在解决地理学领域缺乏统一、高难度评测数据集的学术困境。传统地理学知识问答多依赖小规模或领域窄化的数据集,难以全面反映模型的地理推理深度与跨区域知识迁移能力。该数据集通过融合中美两国标准化考试中的客观与主观题目,系统性地评估了模型在空间认知、区域特征、人地关系等核心地理议题上的表现,从而推动了地理学自然语言处理研究的标准化进程,并为跨学科知识评测提供了可复现的参照框架。
衍生相关工作
GeoBenchmark的发布催生了一系列衍生研究,包括基于该数据集的地理知识图谱构建、多模态地理推理模型以及跨领域迁移学习方法的探索。例如,研究者利用其主观题集开发了面向地理长文本生成的评价指标,并对比了不同预训练语言模型(如BERT、GPT系列)在地理学科上的表现差异。此外,该数据集还促进了地理学与语言学交叉领域的工作,如分析模型在处理地理方位词、地形描述等特殊语义时的认知偏差,进而推动了更具学科针对性的模型架构设计。
以上内容由遇见数据集搜集并总结生成


