遇见数据集

cluneau/github-issues

收藏
Hugging Face2023-04-29 更新2024-03-04 收录
官方服务:

资源简介:

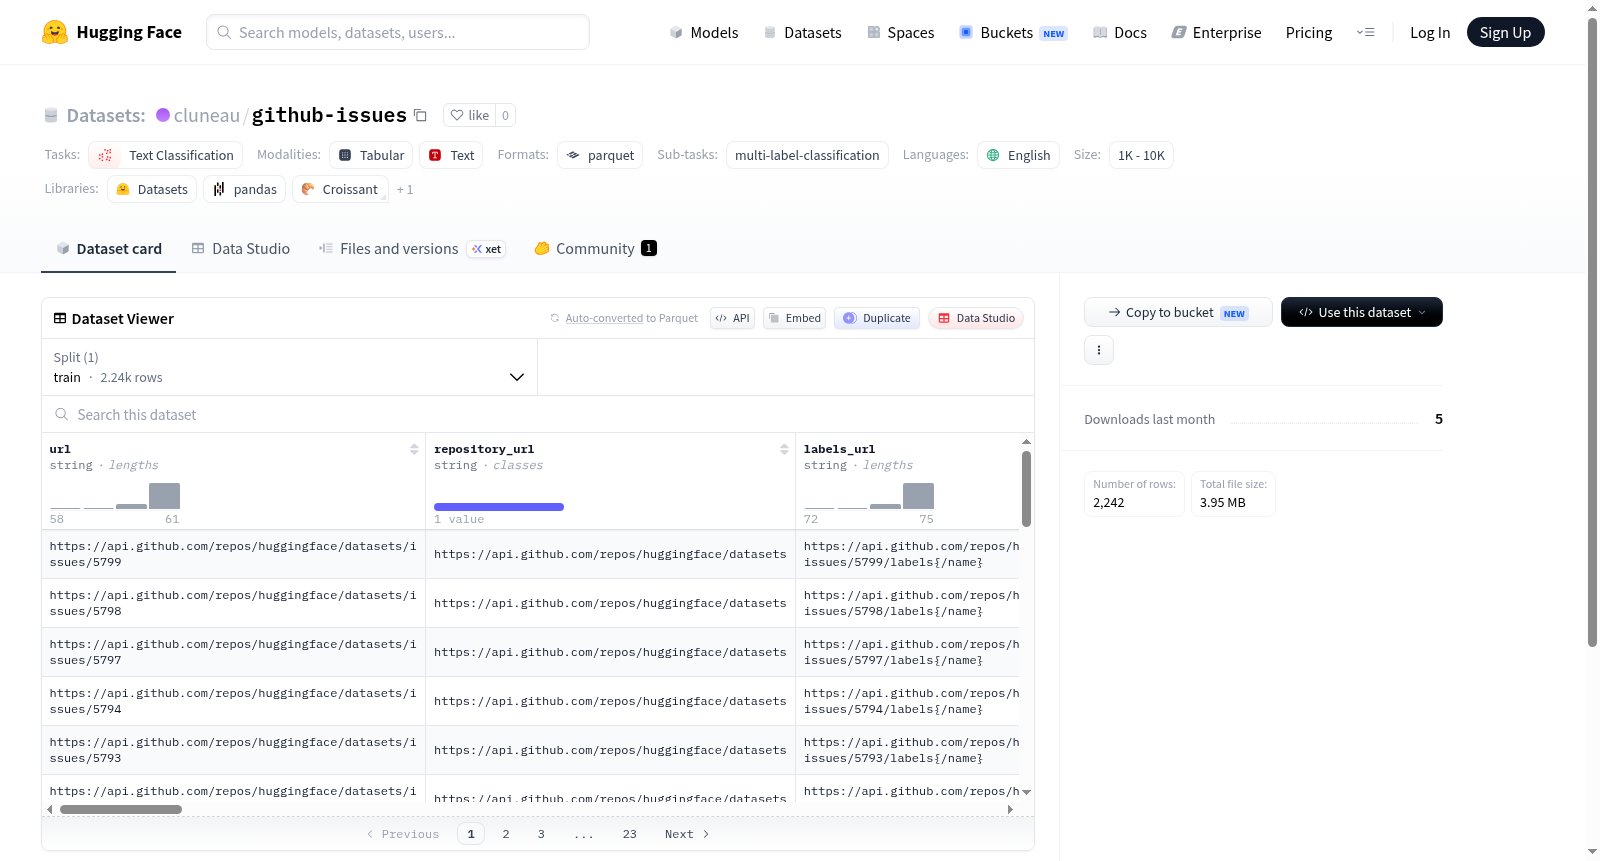
该数据集名为HF Datasets GitHub Issues,主要用于文本分类任务,特别是多标签分类。数据集包含GitHub问题的相关信息,如URL、仓库URL、标签URL、评论URL、事件URL、HTML URL、ID、节点ID、编号、标题、用户信息、标签、状态、锁定状态、分配者、评论、创建时间、更新时间、关闭时间、作者关联、草稿、拉取请求、正文、反应、时间线URL、状态原因、是否为拉取请求等。数据集的大小在1K到10K之间,包含2242个训练样本。

This dataset is named HF Datasets GitHub Issues, which is primarily used for text classification tasks, especially multi-label classification. It contains relevant information of GitHub issues, including URL, repository URL, label URL, comment URL, event URL, HTML URL, ID, node ID, issue number, title, user information, labels, status, locked status, assignee, comments, creation time, update time, close time, author association, draft, pull request, body, reactions, timeline URL, status reason, and whether it is a pull request, etc. The dataset size ranges from 1K to 10K, and it includes 2242 training samples.

提供机构:
cluneau
原始信息汇总

数据集概述

基本信息

  • 名称: HF Datasets GitHub Issues
  • 语言: 英语(monolingual)
  • 大小: 1K<n<10K
  • 任务类型: 文本分类
  • 具体任务: 多标签分类

数据集结构

  • 特征:
    • 基本信息:
      • url, repository_url, labels_url, comments_url, events_url, html_url (均为字符串类型)
      • id, number (均为64位整数类型)
      • node_id (字符串类型)
      • title (字符串类型)
    • 用户信息:
      • user (结构体,包含登录名、ID、节点ID、头像URL等)
    • 标签信息:
      • labels (列表,包含ID、节点ID、URL、名称、颜色等)
    • 状态信息:
      • state (字符串类型)
      • locked (布尔类型)
    • 分配信息:
      • assignee (结构体,包含登录名、ID、节点ID、头像URL等)
      • assignees (列表,包含登录名、ID、节点ID、头像URL等)
    • 评论信息:
      • comments (字符串序列)
    • 时间信息:
      • created_at, updated_at, closed_at (均为64位整数类型)
    • 作者关联信息:
      • author_association (字符串类型)
    • 草稿信息:
      • draft (浮点数类型)
    • 拉取请求信息:
      • pull_request (结构体,包含URL、HTML URL、差异URL等)
    • 反应信息:
      • reactions (结构体,包含URL、总数量、+1、-1等)
    • 时间线URL:
      • timeline_url (字符串类型)
    • 状态原因:
      • state_reason (字符串类型)
    • 是否为拉取请求:
      • is_pull_request (布尔类型)

数据集分割

  • 训练集:
    • 字节数: 12013382
    • 示例数: 2242
    • 下载大小: 3940692
    • 数据集大小: 12013382
搜集汇总
数据集介绍
cluneau/github-issues 数据集图片
构建方式
在软件开发的协作生态中,GitHub Issues 作为开发者交流与问题追踪的核心载体,承载着丰富的语义信息。cluneau/github-issues 数据集正是基于这一背景构建,通过系统化采集 Hugging Face 数据集项目仓库中的议题记录,形成了包含 2242 条样本的文本分类数据集。每条样本不仅保留了议题的标题、正文、状态、标签等标准字段,还细致收录了用户信息、评论序列、反应计数以及关联的拉取请求详情,构建了一个结构完整、字段丰富的多标签分类数据源。
特点
该数据集最显著的特征在于其多维度的结构化设计。除了基础的议题元数据外,数据集中包含了嵌套的用户对象、标签列表、指派人信息以及反应计数等复合字段,能够完整还原议题的生命周期与交互细节。此外,数据集明确标注了是否为拉取请求,并记录了议题的关闭原因与创建、更新、关闭的时间戳,为时序分析与状态预测提供了坚实基础。其规模适中,恰好覆盖 1K 至 10K 区间,兼顾了模型训练的可行性与数据质量的可控性。
使用方法
该数据集专为多标签文本分类任务设计,可直接通过 Hugging Face Datasets 库加载使用。研究者可调用 load_dataset('cluneau/github-issues') 快速获取训练集,并利用其丰富的字段构建多样化的分类目标,如预测议题的标签、状态或是否包含拉取请求。数据以 JSON 格式存储,支持灵活的字段选择与预处理,方便适配各类 Transformer 模型。建议在微调时,将标题与正文拼接作为输入特征,利用 labels 字段中的标签名称构建多标签分类输出层。
背景与挑战
背景概述
在软件工程与自然语言处理的交叉领域,GitHub Issue作为开发者协作与问题追踪的核心载体,承载着丰富的语义信息与结构化元数据。cluneau/github-issues数据集由Hugging Face社区于近年创建,聚焦于Hugging Face Datasets仓库的Issue数据,旨在为文本分类任务提供多标签标注的基准资源。该数据集包含约2242条训练样本,每条记录详尽囊括了Issue的标题、正文、标签、状态、评论及用户交互反应等字段,为研究软件仓库中的问题分类、优先级预测及社区互动模式提供了高质量的数据基础。其出现填补了面向开源生态的细粒度Issue数据集空白,推动了基于Transformer模型在软件工程文本理解任务中的应用探索。
当前挑战
该数据集面临的核心挑战首先在于多标签分类的领域复杂性——GitHub Issue的标签体系高度多样化且存在长尾分布,部分标签样本稀疏导致模型难以泛化。其次,构建过程中需应对数据噪声问题,例如Issue正文中混杂代码片段、Markdown格式及非正式语言,增加了文本预处理的难度。此外,时间跨度带来的语义漂移现象不容忽视,随着仓库演进,Issue主题与标签定义可能发生隐性变化,对模型的时间鲁棒性提出更高要求。最后,用户交互反应(如表情符号)的稀疏性与主观性,也为情感与重要性分析任务引入了额外的标注偏差挑战。
常用场景
经典使用场景
在开源软件生态与自然语言处理交叉研究领域,GitHub Issues数据集为多标签文本分类任务提供了宝贵的实验土壤。该数据集汇聚了HuggingFace Datasets仓库的2242条议题记录,每条样本不仅包含标题与正文描述,还附带了标签、状态、评论等结构化元信息。研究者常利用其进行议题自动标签预测,通过建模标题与正文的语义关联,预测如“bug”、“enhancement”等类别标签,从而助力开发者高效管理项目。该场景下,模型需处理类别不平衡与标签共现问题,成为检验文本表示与多标签分类算法的经典基准。
解决学术问题
该数据集精准回应了开源协作中信息过载与人工分类低效的学术困境。传统上,GitHub议题依赖维护者手动标记,耗时且易出错,尤其在海量提交场景下难以持续。利用此数据集,学者可探索监督学习框架下的自动标签分配,量化不同分类模型在噪声文本与稀疏标签上的泛化能力。其意义在于推动软件工程与自然语言处理的深度融合,为智能化项目管理奠定理论基础,同时为后续研究提供可复现的评估标准,促进学术社区在代码仓库语义理解上的持续突破。
衍生相关工作
该数据集催生了一系列经典工作,尤其在多标签文本分类与软件仓库挖掘领域。例如,研究者基于此数据提出了融合议题元信息(如评论数量、用户角色)的图神经网络模型,以捕捉标签间的依赖关系。另一类工作聚焦于预训练语言模型(如BERT)的微调策略,通过对比不同分词与掩码方案,提升标签预测的鲁棒性。此外,该数据集常被用作跨领域迁移学习的测试床,验证从通用语料到软件工程文本的知识迁移效果,为后续如CodeBERT等代码专用模型的发展提供了重要启示。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务