遇见数据集

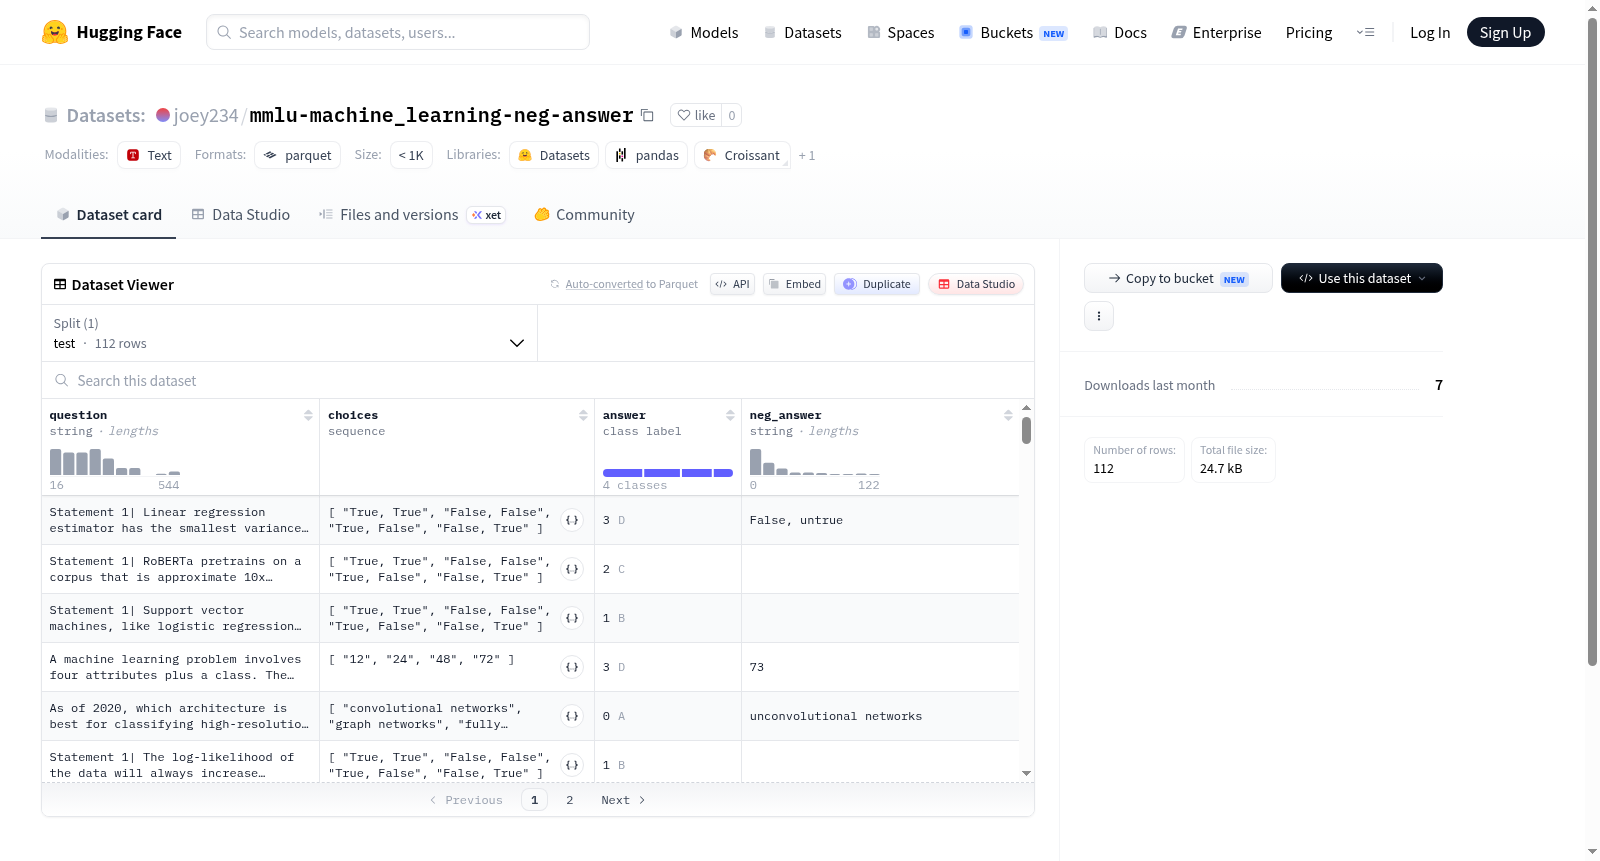
joey234/mmlu-machine_learning-neg-answer

收藏
Hugging Face2023-05-15 更新2024-03-04 收录
官方服务:

资源简介:

--- dataset_info: features: - name: question dtype: string - name: choices sequence: string - name: answer dtype: class_label: names: '0': A '1': B '2': C '3': D - name: neg_answer dtype: string splits: - name: test num_bytes: 36792 num_examples: 112 download_size: 21874 dataset_size: 36792 --- # Dataset Card for "mmlu-machine_learning-neg-answer" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

数据集信息: 特征项: - 名称:question(问题),数据类型:字符串 - 名称:choices(选项),数据类型:字符串序列 - 名称:answer(答案),数据类型:类别标签(class_label),其标签映射规则为: '0': A,'1': B,'2': C,'3': D - 名称:neg_answer(负样本答案),数据类型:字符串 数据集拆分: - 拆分集名称:test(测试集),占用字节数:36792,样本总数:112 下载大小:21874 字节 数据集总存储大小:36792 字节 --- # "mmlu-machine_learning-neg-answer" 数据集卡片 [更多信息待补充](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

提供机构:
joey234
原始信息汇总

数据集概述

数据集名称

mmlu-machine_learning-neg-answer

数据集特征

  • question: 数据类型为字符串。
  • choices: 数据类型为字符串序列。
  • answer: 数据类型为分类标签,具体标签名称为:
    • 0: A
    • 1: B
    • 2: C
    • 3: D
  • neg_answer: 数据类型为字符串。

数据集划分

  • test:
    • 数据量: 36792字节
    • 示例数量: 112

数据集大小

  • 下载大小: 21874字节
  • 数据集总大小: 36792字节
搜集汇总
数据集介绍
joey234/mmlu-machine_learning-neg-answer 数据集图片
构建方式
该数据集源于大规模多任务语言理解(MMLU)基准中机器学习子集的深度加工。在原始MMLU的四选一单选题基础上,研究者通过引入负答案(neg_answer)字段构建了该变体数据集。具体而言,每个样本保留了原始问题(question)、四个选项(choices)及标准答案(answer),同时额外添加一个由模型生成的错误答案作为负样本。这一设计旨在评估模型在干扰信息下的鲁棒性,为对抗性测试提供结构化支持。数据集以112条测试样本构成单一划分,覆盖机器学习核心概念。
特点
数据集的核心特色在于其对抗性评估导向。通过为每个问题配备一个精心构造的负答案,它能够系统性地检验语言模型在面临看似合理但实则错误的选项时的判别能力。所有样本均以类标签形式编码答案(A至D),便于与原始MMLU任务无缝对接。此外,紧凑的测试集规模(112例)使其成为快速基准测试的理想选择,既保持了领域专业性,又降低了计算资源需求。
使用方法
该数据集适用于评估预训练语言模型在机器学习主题上的知识深度与抗干扰能力。使用时,模型需从四个选项中选出正确答案,而负答案字段可作为额外验证信号或用于构建难度递增的测试场景。研究者可通过对比模型在原始MMLU与带负答案变体上的表现差异,量化其鲁棒性。由于数据格式与HuggingFace Datasets库兼容,用户可通过简单的加载函数直接调用,并利用标准评估指标(如准确率)进行性能分析。
背景与挑战
背景概述
大规模多任务语言理解(MMLU)基准测试自2020年由OpenAI等机构提出以来,已成为评估语言模型知识广度与推理能力的重要标杆。joey234/mmlu-machine_learning-neg-answer数据集作为MMLU的衍生版本,聚焦于机器学习子领域,通过引入负向答案(neg_answer)维度,旨在探究模型在面临错误选项干扰时的鲁棒性。该数据集由独立研究者构建,包含112道测试题,每道题配有四个选项及一个预定义的错误答案,其核心研究问题在于揭示语言模型对领域知识的掌握程度与对误导信息的抵抗能力。这一创新设计为理解模型在复杂认知任务中的脆弱性提供了独特视角,推动了对抗性样本与安全对齐领域的研究进展。
当前挑战
该数据集面临的首要挑战在于其规模有限,仅112个样本难以全面覆盖机器学习领域的复杂概念与多样化的知识陷阱,可能导致评估结果的信度与泛化性不足。其次,负向答案的构建依赖人工设计,如何确保错误选项既具迷惑性又避免引入语义偏差,是数据质量控制的关键难题。此外,模型对负向答案的敏感性可能源于表面模式匹配而非深层理解,区分模型是真正抵御误导还是偶然正确成为评估方法学上的挑战。最后,该数据集与原始MMLU的衔接问题亟待解决,负向答案的引入是否改变任务本质、如何标准化对比实验,均需进一步理论探讨与实证验证。
常用场景
经典使用场景
在自然语言处理与知识推理的交叉领域,joey234/mmlu-machine_learning-neg-answer数据集被广泛用于评估机器学习模型对多选问题的理解能力,尤其是模型在面临错误答案干扰时的鲁棒性。该数据集通过引入负样本标签(neg_answer),为研究者提供了探究模型如何区分正确答案与精心构造的误导性选项的独特视角。其经典使用场景包括基准测试大型语言模型在机器学习子领域的知识掌握程度,以及训练模型在对抗性样本下的决策稳定性。
实际应用
在实际应用中,该数据集可用于构建智能教育辅导系统,帮助系统识别学生在机器学习概念理解中的常见误区。例如,通过分析模型对负样本的选择模式,可以设计针对性纠错机制。此外,在自动化问答与知识图谱构建场景中,该数据集支持开发能够抵御虚假信息干扰的检索增强生成系统,提升AI在学术问答、技术文档解析等任务中的可信度与准确性。
衍生相关工作
该数据集衍生了一系列相关工作,包括对抗性样本生成方法的研究,如基于neg_answer构造语义相近的干扰选项来测试模型边界。此外,它催生了鲁棒性微调策略的探索,例如利用负样本进行对比学习以增强模型判别力。部分工作还将其与MMLU原始基准结合,开发了多任务评估框架,用于系统分析模型在不同知识领域中的错误分布。这些研究共同推动了可信AI在知识密集型任务中的发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务