
ManiSoft
收藏资源简介:
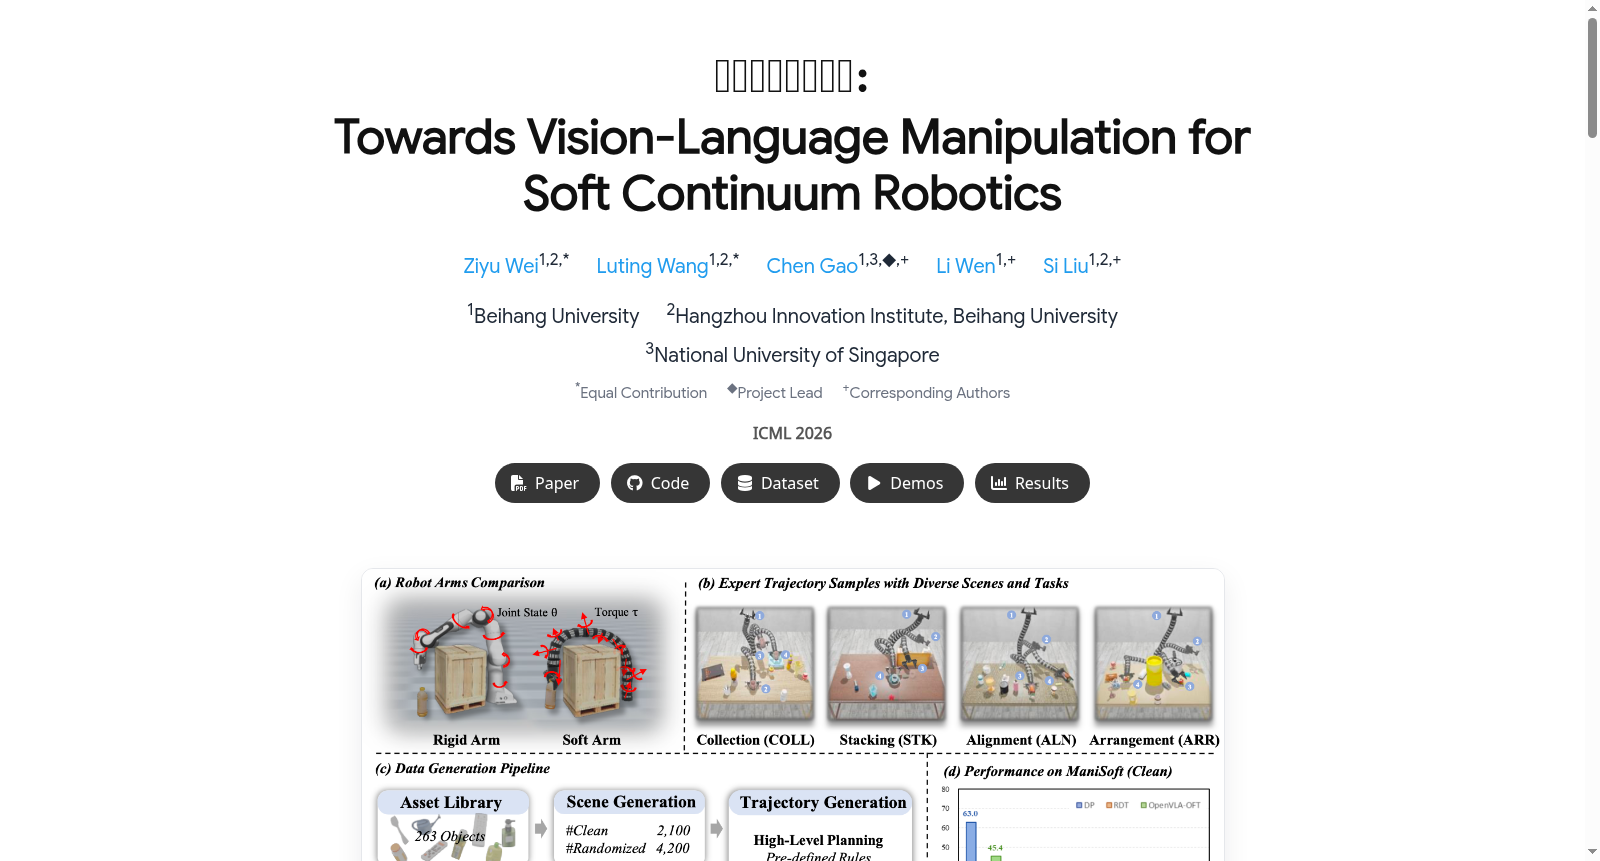
ManiSoft是由北京航空航天大学等研究机构创建的软体机器人视觉语言操纵基准数据集,旨在填补刚性机械臂与软体机械臂在视觉语言交互研究领域的空白。该数据集包含6,300个精心生成的桌面场景及其对应的专家操纵轨迹,每个场景均配备语言指令,数据来源于通过资产库程序化构建的263个三维对象,并采用混合物理仿真器生成高保真视觉观察。数据生成过程采用分层机制,结合高层规划器的规则分解与底层强化学习控制器的扭矩指令生成,确保了轨迹的稳定性与可扩展性。该数据集主要应用于评估和开发面向软体机械臂的视觉语言动作模型,重点解决在缺乏准确本体感知的情况下,如何从视觉观察中推断软体形态并利用其形变能力进行自适应障碍物避让等核心挑战。
ManiSoft is a vision-language manipulation benchmark dataset for soft robotics, developed by research institutions including Beihang University (BUAA). It aims to fill the critical research gap in vision-language interaction studies between rigid and soft robotic arms. This dataset includes 6,300 meticulously generated desktop scenes paired with corresponding expert manipulation trajectories, each accompanied by natural language instructions. The data is derived from 263 3D objects programmatically constructed through asset libraries, with high-fidelity visual observations generated using a hybrid physics simulator. The data generation process employs a hierarchical framework, combining rule-based decomposition from high-level planners and torque command generation from low-level reinforcement learning controllers, thus ensuring the stability and scalability of the generated trajectories. This dataset is primarily designed for evaluating and developing vision-language action models tailored for soft robotic arms, with a core focus on addressing key challenges such as inferring soft body morphology from visual observations and leveraging their deformation capabilities for adaptive obstacle avoidance in the absence of accurate proprioception.
数据集概述:ManiSoft
ManiSoft 是一个面向软体连续体机器人的视觉-语言操作基准数据集,旨在超越当前刚性机械臂的操作范式。
核心信息
- 数据集名称:ManiSoft
- 论文标题:ManiSoft: Towards Vision-Language Manipulation for Soft Continuum Robotics
- 发布机构:北京航空航天大学(Beihang University)
- 论文出处:ICML 2026
数据集规模与组成
- 场景-轨迹对总数:6,300 对,涵盖干净场景和随机化场景。
- 资产库:包含 263 个对象。
- 可操作对象:109 个,覆盖 17 个类别。
- 障碍物对象:154 个,覆盖 35 个类别。
- 语言指令:每个场景平均约 40 条语言指令。
任务分类
ManiSoft 包含四个任务类别,每个任务都提供了干净场景和随机化场景:
-
收集 (Collection, COLL)
- 目标:拾取物体并放入容器中。
- 评估重点:基本轨迹控制和末端执行器协调。
-
对齐 (Alignment, ALN)
- 目标:将目标物体对齐到指定的 6-DoF(六自由度)位姿。
- 评估重点:精确的位置和方向调整。
-
堆叠 (Stacking, STK)
- 目标:将餐具按大小从大到小堆叠成稳定的一摞。
- 评估重点:在接触密集交互中的精确控制。该任务的轨迹通常比其他任务更长。
-
布置 (Arrangement, ARR)
- 目标:排列多个物体。
- 评估重点:感知、空间推理和障碍物感知规划。
数据生成流程
- 场景生成:基于资产库程序化生成桌面场景,包含干净和随机化(增加障碍物、改变位置/纹理/光照)两种类型。语言指令从模板库中根据物体属性自动实例化。
- 轨迹生成:采用分层机制生成专家演示:
- 高层:任务特定的规则型规划器将操作问题分解为语义路径点(如接近、抓取、缩回、放置),每个路径点表示为一个期望的 6-DoF 末端执行器位姿。
- 低层:一个基于强化学习(RL)训练的“执行器”将路径点转换为软体臂的力矩指令,通过结合位姿精度和运动稳定性的密集奖励进行优化。
主要基准测试结果
- 在干净场景中,代表性策略模型(如 Diffusion Policy (DP)、RDT、OpenVLA-OFT)的性能明显高于随机化场景,表明视觉变化、杂乱和障碍物是当前模型在软体机器人上面临的主要挑战。
- OpenVLA-OFT 在随机化场景中表现出最强的鲁棒性。
- DP 在简单的干净场景中保持竞争力。
- 在所有方法中,收集任务最易完成,而堆叠和布置任务则暴露了精确可变形控制和障碍物感知推理的难度。
引用信息
bibtex @article{wei2026manisoft, title={ManiSoft: Towards Vision-Language Manipulation for Soft Continuum Robotics}, author={Ziyu Wei and Luting Wang and Chen Gao and Li Wen and Si Liu}, journal={arXiv preprint arXiv:2605.18617}, year={2026}, }
- 1ManiSoft: Towards Vision-Language Manipulation for Soft Continuum Robotics北京航空航天大学; 北京航空航天大学·杭州创新研究院; 新加坡国立大学 · 2026年


