遇见数据集

CVasNLPExperiments/VQAv2_sample_validation_google_flan_t5_xxl_mode_D_PNP_GENERIC_CM_Q_rices_ns_1000

收藏
Hugging Face2023-06-08 更新2024-03-04 收录
官方服务:

资源简介:

--- dataset_info: features: - name: id dtype: int64 - name: prompt sequence: string - name: question dtype: string - name: true_label sequence: string - name: prediction dtype: string splits: - name: fewshot_0_clip_tags_LAION_ViT_H_14_2B_with_openai_Attributes_LAION_ViT_H_14_2B_descriptors_text_davinci_003_full_DETA_detections_deta_swin_large_o365_coco_classes_caption_all_patches_Salesforce_blip_image_captioning_large_clean_ num_bytes: 12745403 num_examples: 1000 download_size: 1889203 dataset_size: 12745403 --- # Dataset Card for "VQAv2_sample_validation_google_flan_t5_xxl_mode_D_PNP_GENERIC_CM_Q_rices_ns_1000" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

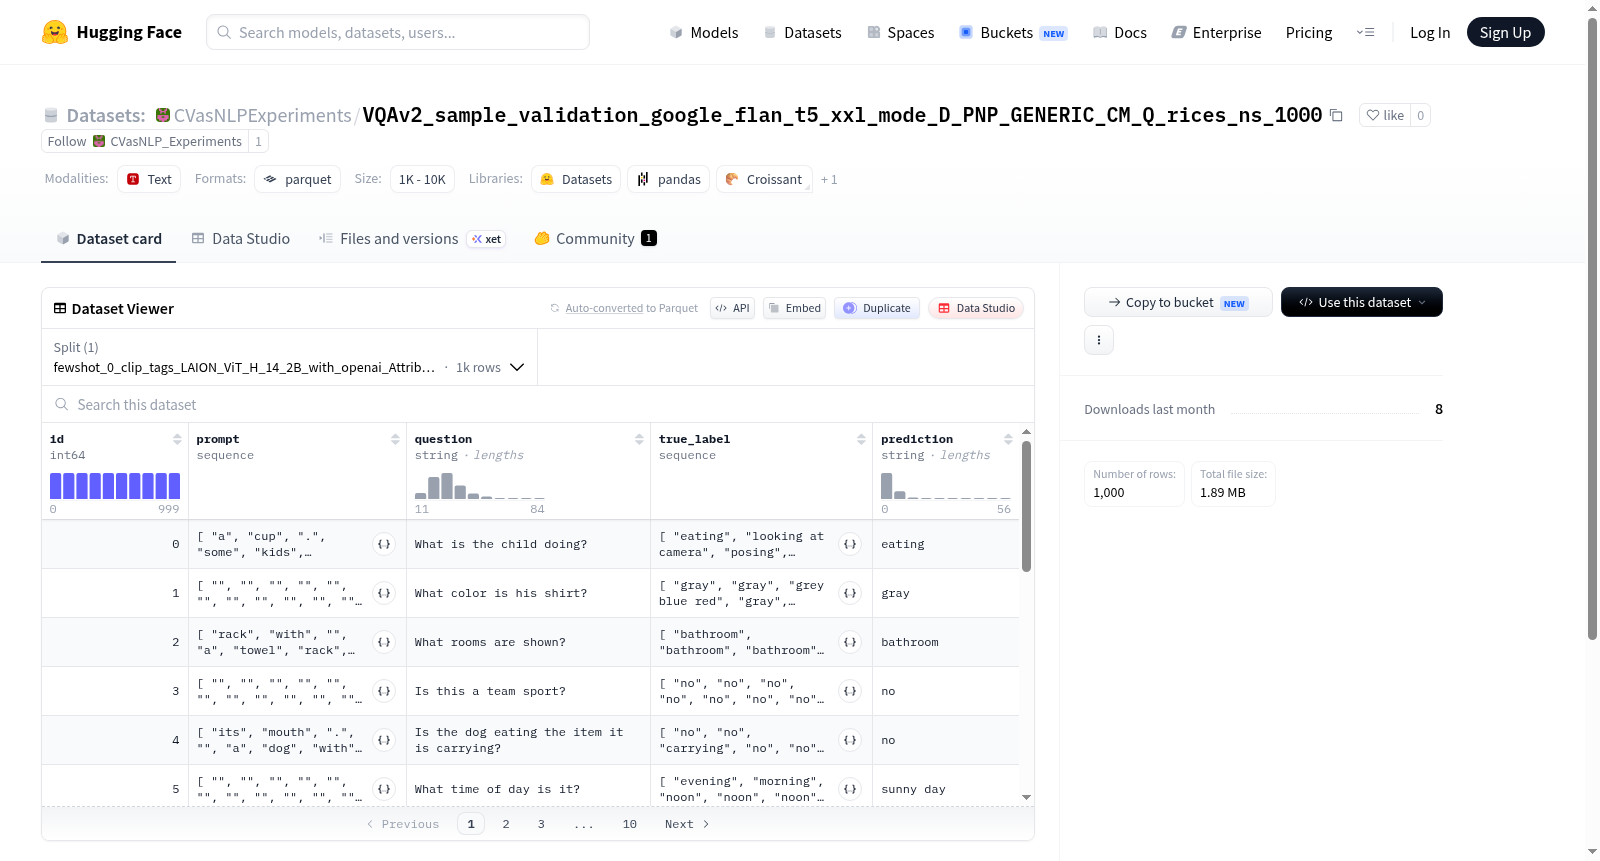
数据集信息: 特征字段: - 名称:id,数据类型:int64 - 名称:提示词(prompt),数据类型:序列型字符串 - 名称:问题(question),数据类型:字符串 - 名称:真实标签(true_label),数据类型:序列型字符串 - 名称:预测结果(prediction),数据类型:字符串 划分集: - 名称:fewshot_0_clip_tags_LAION_ViT_H_14_2B_with_openai_Attributes_LAION_ViT_H_14_2B_descriptors_text_davinci_003_full_DETA_detections_deta_swin_large_o365_coco_classes_caption_all_patches_Salesforce_blip_image_captioning_large_clean_,字节数:12745403,样本数:1000 下载大小:1889203,数据集存储大小:12745403 # 「VQAv2_sample_validation_google_flan_t5_xxl_mode_D_PNP_GENERIC_CM_Q_rices_ns_1000」数据集卡片 [需补充更多信息](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

提供机构:
CVasNLPExperiments
原始信息汇总

数据集概述

数据集名称

"VQAv2_sample_validation_google_flan_t5_xxl_mode_D_PNP_GENERIC_CM_Q_rices_ns_1000"

数据集特征

  • id: 整数类型 (int64)
  • prompt: 字符串序列
  • question: 字符串类型
  • true_label: 字符串序列
  • prediction: 字符串类型

数据集分割

  • 分割名称: fewshot_0_clip_tags_LAION_ViT_H_14_2B_with_openai_Attributes_LAION_ViT_H_14_2B_descriptors_text_davinci_003_full_DETA_detections_deta_swin_large_o365_coco_classes_caption_all_patches_Salesforce_blip_image_captioning_large_clean_
  • 大小: 12,745,403 字节
  • 示例数量: 1000

数据集大小

  • 下载大小: 1,889,203 字节
  • 数据集大小: 12,745,403 字节
搜集汇总
数据集介绍
CVasNLPExperiments/VQAv2_sample_validation_google_flan_t5_xxl_mode_D_PNP_GENERIC_CM_Q_rices_ns_1000 数据集图片
构建方式
在视觉问答(VQA)领域,构建高质量评估数据集是衡量模型泛化能力的关键。本数据集基于VQAv2验证集样本构建,通过采用Google Flan-T5 XXL模型,结合PNP(Progressive Neural Pruning)策略与GENERIC_CM_Q机制,并引入RICES(Retrieval-based In-Context Example Selection)方法,从1000个检索样本中筛选最相关的上下文示例。数据集包含id、prompt、question、true_label和prediction等字段,其中prompt和true_label以序列形式存储,便于多模态交互分析。最终形成1000条评估样本,以JSON格式存储,确保结构清晰。
使用方法
使用本数据集时,用户可直接加载HuggingFace上的JSON文件,通过id字段索引样本。典型流程包括:将question字段输入Flan-T5 XXL模型,结合prompt中的上下文示例生成prediction,并与true_label进行对比评估。由于数据集已预设好fewshot_0等划分,用户可直接用于评测模型的零样本性能。建议配合HuggingFace的datasets库加载,利用其内置的split功能快速访问1000条验证样本。此外,prediction字段可用于存储模型输出,便于后续计算准确率等指标。
背景与挑战
背景概述
视觉问答(VQA)作为连接计算机视觉与自然语言处理的交叉领域,旨在使模型能够基于图像内容回答自然语言问题。VQAv2数据集是这一领域的标杆性基准,由佐治亚理工学院等机构的研究人员于2017年发布,通过引入平衡的二元问题设计,有效缓解了早期数据集中的语言偏见问题,推动了多模态推理能力的评估。本数据集作为VQAv2验证集的采样版本,包含1000个样本,其特点在于整合了多种先进视觉-语言模型的预测结果,如Google Flan-T5-XXL、CLIP标签、BLIP图像描述及DETA目标检测等,旨在探究不同模态特征融合与提示策略(如RICES检索增强)对VQA性能的影响。该数据集的研究核心在于评估大规模语言模型在零样本与少样本场景下的视觉推理能力,为多模态预训练模型的鲁棒性分析提供了关键测试平台。
当前挑战
当前数据集面临的核心挑战包括:1)多模态对齐难题——如何将来自不同视觉编码器(如CLIP、DETA)的异构特征与语言模型(如Flan-T5)的语义空间有效对齐,避免信息丢失或噪声引入;2)语言偏见的残余影响——尽管VQAv2通过平衡设计减少了捷径学习,但采样版本中预测与真实标签的差异仍可能反映模型对特定问题模板或词汇的过度依赖;3)构建过程中的计算与标注成本挑战——整合多种预训练模型(如ViT-H-14、text-davinci-003)的预测结果需要大量推理计算,且自动生成的描述与检测标签可能引入错误累积,影响数据质量;4)少样本泛化限制——基于1000个样本的验证集难以全面覆盖复杂场景(如空间推理、计数任务),导致模型性能评估存在偏差。
常用场景
经典使用场景
在视觉与语言交叉领域的研究中,VQAv2数据集作为视觉问答任务的标杆性基准,被广泛用于评估多模态模型的跨模态理解能力。该样本验证集特别针对模型在零样本或小样本场景下的推理表现进行测试,通过引入RICES(Retrieval-based In-Context Example Selection)策略,从大规模候选池中检索最相关的上下文示例,从而模拟模型在有限标注数据下的泛化性能。这一设计使得研究者能够精准剖析模型在复杂视觉问答任务中,如何利用外部知识增强其语义对齐与逻辑推理能力。
解决学术问题
该数据集有效解决了视觉问答领域长期存在的两大核心难题:一是模型对细粒度视觉语义的鲁棒性不足,二是传统评估方法难以分离模型的知识记忆与推理能力。通过引入来自多个预训练模型(如CLIP、BLIP、DETA)的多样化特征描述,该数据集为分析模型在不同视觉表征空间下的行为差异提供了标准化平台。其意义在于推动了多模态模型从简单的模式匹配向真正的跨模态推理演进,为后续研究如何构建更具可解释性的视觉问答系统奠定了方法论基础。
实际应用
在实际应用中,该数据集所验证的模型能力可直接服务于智能辅助系统,例如为视障人士提供场景理解服务、在电商平台中实现基于图像的智能客服问答,以及协助自动驾驶系统理解交通标志与路面状况的语义关联。通过模拟真实世界中标注数据稀缺的场景,该数据集帮助开发者评估模型在冷启动条件下的表现,从而加速视觉问答技术在工业级产品中的落地部署,降低对大规模人工标注的依赖。
数据集最近研究
最新研究方向
该数据集聚焦于多模态大语言模型在视觉问答(VQA)任务中的零样本与少样本推理能力评估,尤其关注基于检索增强的上下文学习范式。通过引入RICES(Retrieval-based In-Context Example Selection)策略,结合CLIP、DETA等视觉编码器与Flan-T5等语言模型,探索了在无微调条件下如何利用外部知识库(如LAION描述、属性标签、目标检测结果)提升模型对复杂视觉场景的理解与回答准确性。该方向与当前多模态领域的前沿趋势——即利用检索增强生成(RAG)技术缓解大模型幻觉问题——高度契合,为构建更鲁棒、可解释的视觉对话系统提供了基准测试平台,推动了从静态预训练向动态知识注入的范式转变。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务