
yazidtagnaouti/myway
收藏官方服务:
资源简介:
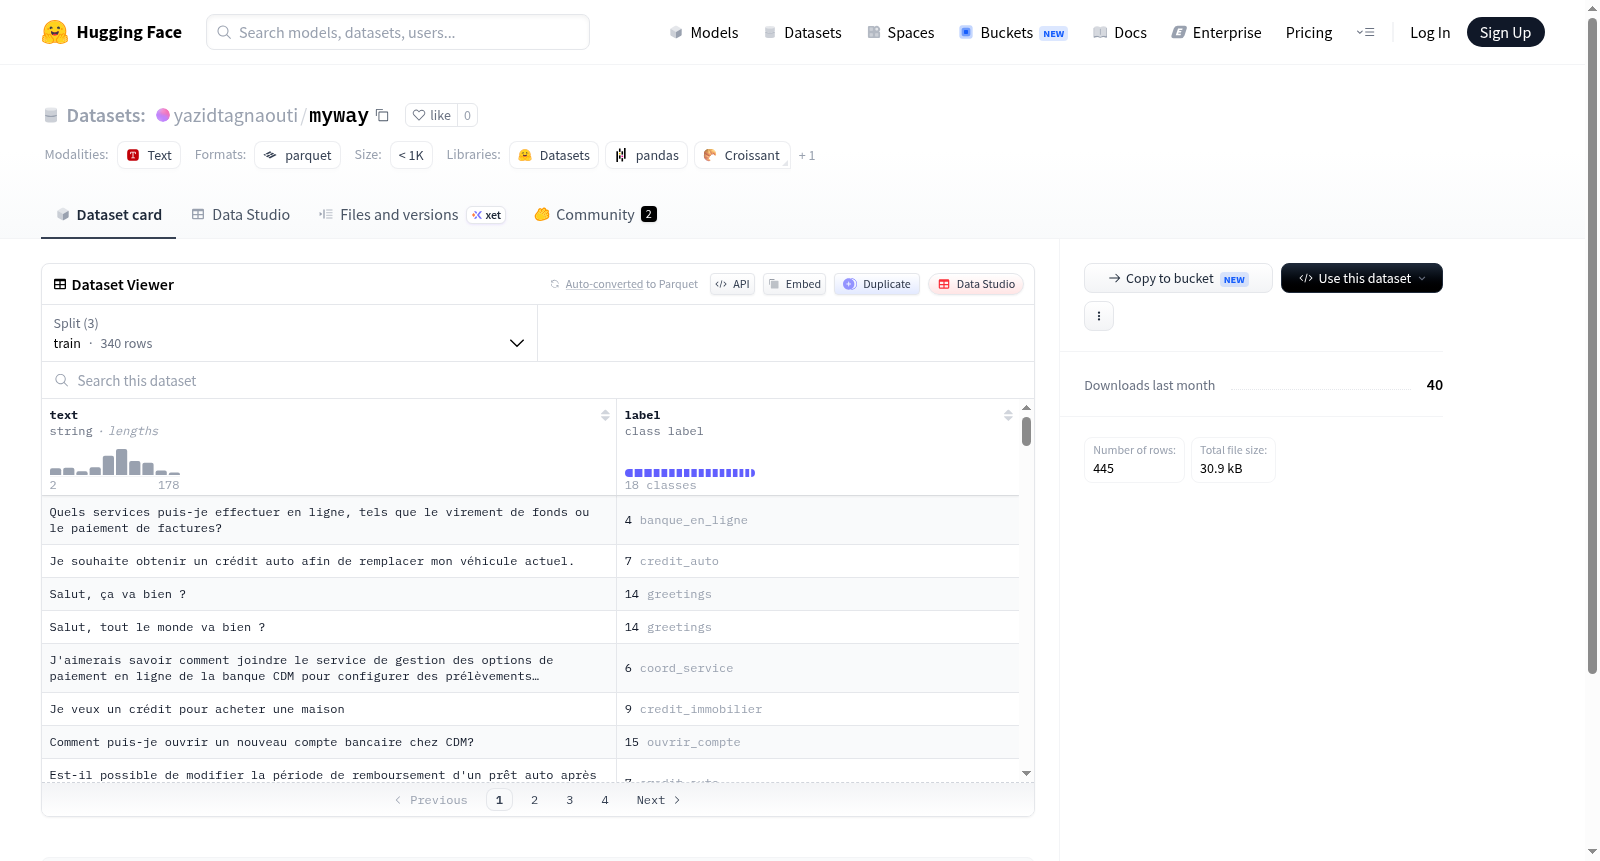
该数据集包含文本和标签两个主要字段,其中标签是一个分类标签,涵盖了18个不同的类别,如死亡和残疾保险、储蓄保险、支付方式保险、多风险住房保险、在线银行、银行卡、协调服务、汽车贷款、消费贷款、抵押贷款、储蓄、教育储蓄、退休储蓄、告别、问候、开户、事故保护和模拟等。数据集被划分为训练集、测试集和验证集三个部分,分别包含340、45和60个样本,总大小为46923字节。
该数据集包含文本和标签两个主要字段,其中标签是一个分类标签,涵盖了18个不同的类别,如死亡和残疾保险、储蓄保险、支付方式保险、多风险住房保险、在线银行、银行卡、协调服务、汽车贷款、消费贷款、抵押贷款、储蓄、教育储蓄、退休储蓄、告别、问候、开户、事故保护和模拟等。数据集被划分为训练集、测试集和验证集三个部分,分别包含340、45和60个样本,总大小为46923字节。
提供机构:
yazidtagnaouti原始信息汇总
数据集概述
特征信息
- text: 数据类型为字符串。
- label: 数据类型为类别标签,包含以下类别:
- 0: assurance_deces_et_invalidite
- 1: assurance_epargne
- 2: assurance_moyens_de_paiement
- 3: assurance_multirisques_habitation
- 4: banque_en_ligne
- 5: carte_bancaire
- 6: coord_service
- 7: credit_auto
- 8: credit_conso
- 9: credit_immobilier
- 10: epargne
- 11: epargne_education
- 12: epargne_retraite
- 13: goodbye
- 14: greetings
- 15: ouvrir_compte
- 16: protection_accident
- 17: simulation
数据分割
- train: 包含340个样本,占用35851.28字节。
- test: 包含45个样本,占用4745.02字节。
- validation: 包含60个样本,占用6326.70字节。
数据集大小
- 下载大小: 27376字节。
- 数据集大小: 46923字节。
配置信息
- default: 数据文件路径如下:
- train: data/train-*
- test: data/test-*
- validation: data/validation-*
搜集汇总
数据集介绍
构建方式
在金融与保险服务日益数字化的背景下,多语种客户意图识别成为智能客服系统的核心挑战。yazidtagnaouti/myway数据集专为此场景构建,涵盖法语银行与保险领域的18个细分类别,如死亡与伤残保险、储蓄保险、在线银行、信用卡服务等。数据集通过收集真实客服对话文本,并采用人工标注方式为每条语句分配唯一标签,确保类别边界清晰。数据划分为训练集340条、测试集45条和验证集60条,形成标准化的监督学习任务结构。
使用方法
数据集以HuggingFace Datasets格式托管,支持通过load_dataset函数直接加载,指定config_name为'default'即可获取划分好的训练、测试与验证子集。每条样本包含'text'字段(用户输入语句)与'label'字段(整数索引,映射至18个预定义意图)。使用时需将标签转换为one-hot编码或直接作为分类目标,可应用于训练基于Transformer的文本分类模型(如CamemBERT、FlauBERT)。推荐在微调时采用分层采样策略以维护类别比例,并利用验证集进行早停与超参数调优。
背景与挑战
背景概述
在自然语言处理与金融服务深度融合的背景下,对话系统的意图识别能力成为提升用户体验的关键。yazidtagnaouti/myway数据集由研究团队于近年创建,聚焦于法语银行与保险领域的客户服务场景,核心研究问题在于如何精准区分涵盖死亡与残疾保险、储蓄、在线银行、信用卡、住房综合保险等17类细粒度意图。该数据集通过收集真实客服对话构建,训练集包含340条样本,测试集与验证集分别含45条和60条样本,为多类别文本分类任务提供了基准资源。其影响力体现在推动法语金融领域意图识别模型的开发,弥补了非英语场景下专业数据集稀缺的不足,并为跨语言迁移学习提供了参照标准。
当前挑战
该数据集面临的首要挑战是解决金融领域意图识别中类别高度相似且样本不均衡的难题,例如‘assurance_epargne’与‘epargne’等类别语义重叠,易导致模型混淆。构建过程中,数据标注需依赖金融专业知识以确保标签准确性,而340条训练样本的规模限制了深度学习模型的泛化能力,容易引发过拟合。此外,法语特有的语法结构及金融术语的复杂性增加了文本预处理的难度,例如‘carte_bancaire’与‘moyens_de_paiement’等名词短语的边界识别。数据来源的隐私合规性也是一大挑战,需在脱敏处理与保留语义特征之间取得平衡,从而保障数据集的实用性与伦理标准。
常用场景
经典使用场景
在智能客服与金融科技交叉领域,yazidtagnaouti/myway数据集专为法语金融服务对话意图识别而设计。其经典使用场景聚焦于对银行、保险及支付场景中用户自然语言查询的精细分类,涵盖从死亡伤残保险、储蓄计划到住房综合保险、在线银行、银行卡服务、各类贷款(汽车、消费、住房)、信用卡、教育储蓄、退休储蓄、账户开立、事故保护及模拟咨询等18个明确类别。研究者利用该数据集训练序列分类模型,以精准区分用户意图,从而构建高效、智能的对话系统,实现服务自动路由与个性化响应。
解决学术问题
该数据集有效解决了法语金融领域缺乏高质量、细粒度意图标注语料的学术难题。此前,多语种意图识别研究多集中于英语或通用领域,忽视了法语金融术语的复杂性与领域特异性。myway数据集通过提供涵盖保险、银行、信贷、储蓄等核心金融子领域的340条训练样本及105条验证测试样本,为对比学习、少样本学习及跨语言迁移学习提供了基准。它推动了意图识别技术从通用场景向垂直金融领域的深化,促进了对话状态追踪与多轮交互理解的研究,显著提升了模型对法语金融术语的语义解析能力。
实际应用
在实际应用中,该数据集支撑了法语地区金融机构的智能客服系统升级。银行与保险公司可基于此构建自动意图路由模块,将用户关于死亡伤残保险、住房保险、在线银行、信用卡挂失、贷款申请、账户开立、储蓄产品咨询及告别问候等请求,精准分配至相应业务队列。同时,它赋能了模拟咨询与产品推荐引擎,例如在用户表达“épargne”(储蓄)意图时,系统可自动推送教育储蓄或退休储蓄选项。此外,该数据集还用于构建金融知识库的问答系统,提升客服响应效率与客户满意度。
数据集最近研究
最新研究方向
在金融科技与自然语言处理交叉领域,面向多语种尤其是法语市场的智能客服系统正成为研究热点。myway数据集聚焦银行与保险业务场景,涵盖信用卡、贷款、储蓄、在线银行及退保问候等17个细分意图类别,为构建可精准识别客户需求的对话模型提供了关键训练资源。当前前沿方向包括利用该数据集训练轻量化意图分类器,以在嵌入式设备或实时服务中实现高效推理;同时,结合预训练语言模型(如FlauBERT、CamemBERT)进行少样本学习与领域自适应,探索在标注数据稀缺条件下维持高精度的技术路径。这一数据集的出现呼应了欧洲金融服务业数字化转型对本地化、合规化AI助手的需求,其多类别细粒度标注设计有助于推动意图识别从粗粒度向精细粒度演进,对提升客户自助服务体验、降低人工坐席成本具有显著应用价值。
以上内容由遇见数据集搜集并总结生成


