遇见数据集

AbstractPhil/cc-task1-json

收藏
Hugging Face2026-05-18 更新2026-05-31 收录
官方服务:

资源简介:

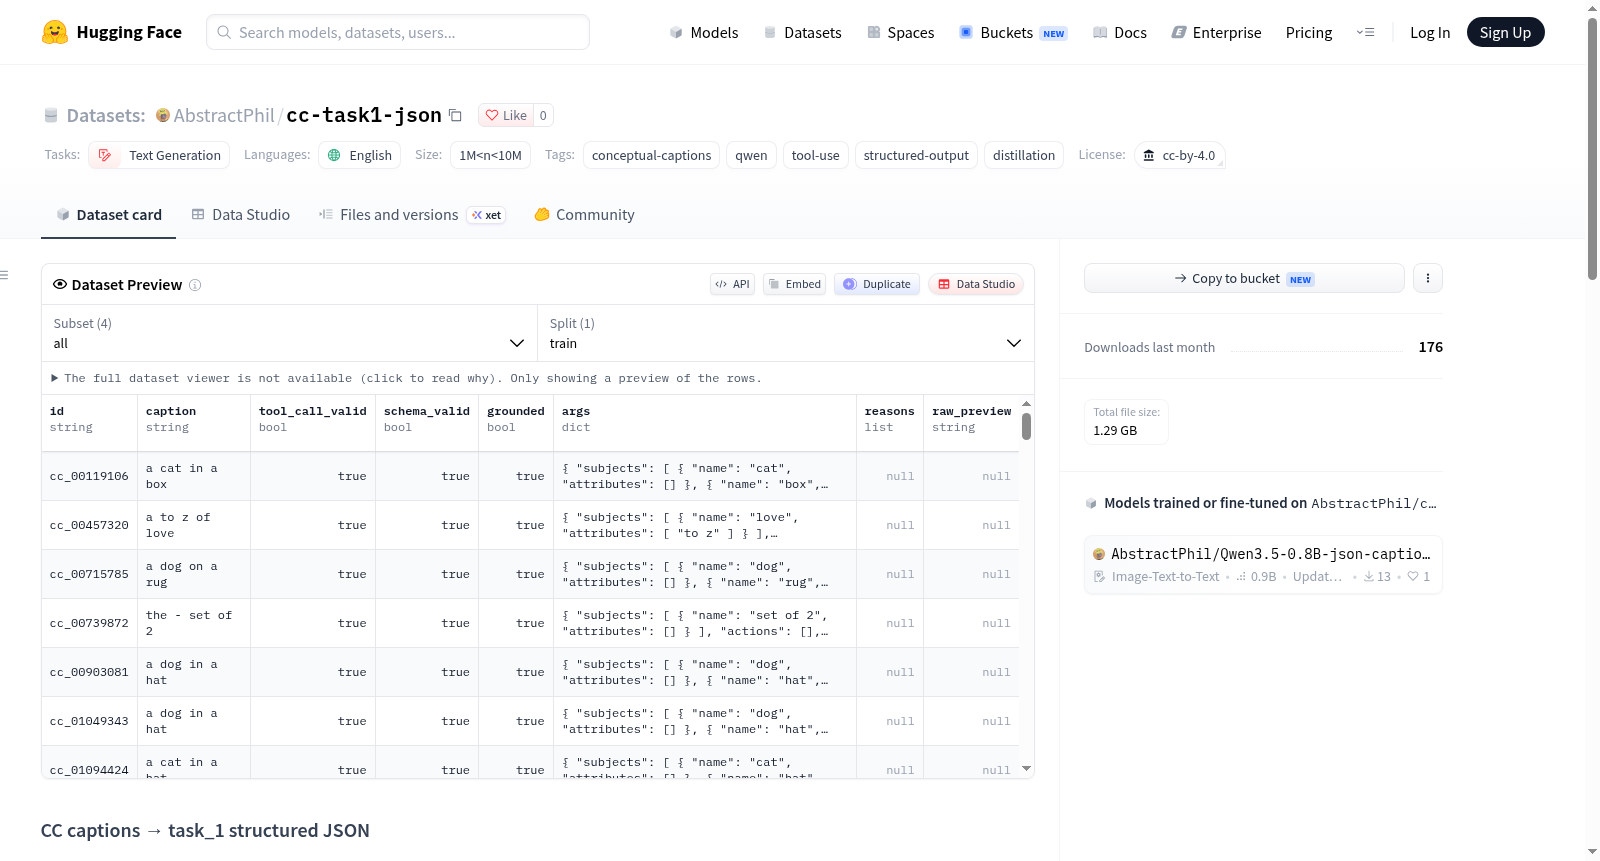
该数据集将Conceptual Captions(CC captions)转换为结构化JSON格式,专门用于任务1(task_1)。通过使用Qwen3.5-0.8B LoRA适配器模型,对原始英文图像描述进行主观分析,提取并转换为包含类似评估的JSON数据。数据集包含有效性评分(如schema_valid和grounded),其中grounded为true的行可用于训练。数据格式包括id、原始描述、args字段(含subjects、actions、setting等结构化信息),适用于文本生成任务,并支持工具使用和结构化输出。数据集规模在1M到10M之间,语言为英语,配置多个分片(shard_0、shard_1、shard_2)。

Conceptual Captions converted to literal-extraction JSON via the Qwen3.5-0.8B LoRA adapter for task_1, with schema validity and grounding scores. The dataset transforms plain English image prompts into structured JSON containing subjective assessments, including fields like subjects, actions, and setting. It is designed for text-generation tasks, with tags such as conceptual-captions, tool-use, and structured-output. Rows with grounded==true are training-ready, and the dataset is sharded for efficient handling.
提供机构:
AbstractPhil
搜集汇总
数据集介绍
AbstractPhil/cc-task1-json 数据集图片
构建方式
在概念描述生成与结构化语义抽取交叉的研究场景中,该数据集以 Conceptual Captions 的图像提示文本为源材料,经由 AbstractPhil/cc-prompts-sharded 分片后,借助 Qwen3.5-0.8B 基座与 AbstractPhil/qwen3.5-0.8b-task_1-lora 适配器执行批量推理。转换脚手架在推理时取自 AbstractPhil/json-coco-format 的系统提示与工具定义,三项 Google Colab 并行任务分别处理 shard_0、shard_1 与 shard_2,运行 cc_batched_inference.py 并以不低于128的批大小在 RTX 6000 Pro Blackwell 上推进,每10000行分块上传。生成结果继而接受工具调用有效性、模式有效性与 grounding 评分,总耗时约50小时,形成面向任务1的 JSON 样本集合。
特点
在图像—文本对齐与工具调用式文本生成的数据资源谱系中,该数据集呈现出多层级质量信号与结构化语义字段并置的特征。其规模处于100万至1000万行之间,按 shard_0、shard_1、shard_2 及 all 配置组织,便于分片加载与整体聚合。每一行包含原始 caption、tool_call_valid、schema_valid、grounded 等校验标记,并在 args 中给出 subjects、actions、setting、style、mood 等抽取结果。grounded 为真的样本可直接用于训练。需注意其由 V1 LoRA 蒸馏得到,上下文关联有限,主题错误、无效语境与结构瑕疵可能存在,且标记长度常超过标准 CLIP 模型的77个 token 限制,并携带需在训练前过滤的偏差。
使用方法
在监督微调与结构化输出蒸馏的典型流程中,该数据集可通过 Hugging Face datasets 接口便捷载入。调用 load_dataset('AbstractPhil/cc-task1-json', 'all', split='train') 可获取全量训练分片,亦可选择 shard_0、shard_1 或 shard_2 以控制内存与并行粒度。以 r['grounded'] 为条件过滤可获得训练就绪的干净子集,并统计其在总量中的占比。面向 SFT 训练时,宜依据 caption 与 args 重建 messages 数组,并复用 json-coco-format 中的系统提示与工具定义脚手架。使用前应过滤空值,并核查 tool_call_valid、schema_valid 与 grounded 信号,以降低噪声样本对训练过程的干扰。
背景与挑战
背景概述
在概念性描述与结构化监督数据加速汇流的背景下,cc-task1-json 由 AbstractPhil 构建,作为 Task 1 V1 完成版发布于 Hugging Face;卡片未标注具体发布日期,但说明其依托 Qwen3.5-0.8B 的 LoRA 适配器,在 Google Colab 中以三路并行 Notebook 调用 RTX 6000 Pro Blackwell,总耗时约五十小时。其核心研究问题在于把 Conceptual Captions 的英文图像提示转化为 task_1 结构化 JSON,抽取主体、动作、场景等要素并赋予主观评估。该数据集以百万级规模为文本生成、工具调用、结构化输出与蒸馏研究提供了可训练监督信号,并对 schema 有效性与 grounding 评测具有参考意义。
当前挑战
该数据集的挑战植根于图像描述语义解析与结构化生成的双重难题:领域层面需将开放英文提示映射为受 schema 约束的 JSON,并完成主体、动作、场景及主观风格与情绪判断,同时维持工具调用有效性与事实接地;构建层面则受限于 Qwen3.5-0.8B LoRA 的容量,V1 存在上下文关联有限、主题错误、无效上下文、结构脆弱等风险,且生成 token 常超过 CLIP 七十七 token 限制。偏置亦被明示为保证存在,故须在训练前过滤空值并依赖 grounded 标志筛选样本;后续 V2 需先训练更大模型方能提升可靠性。
常用场景
经典使用场景
在视觉语言预训练与指令微调交汇的领域中,概念字幕数据长期承担语义桥接功能。cc-task1-json将Conceptual Captions的自然语言图像描述经Qwen3.5-0.8B LoRA适配器转写为task_1结构化JSON,典型用途是监督模型从英文提示中抽取主体、动作、场景、风格与情绪等字段,并实现工具调用格式对齐。研究者可加载all配置,依据grounded、tool_call_valid与schema_valid标记筛选高质量样本,用于结构化文本生成、多模态元数据生成和轻量级工具调用代理训练。该场景强调从自由文本到可验证JSON的蒸馏式映射,而非单纯图像分类或字幕生成。
衍生相关工作
围绕cc-task1-json形成的相关经典工作,主要体现为数据生成、格式脚手架与模型适配器的连续链条。源字幕数据集AbstractPhil/cc-prompts-sharded提供分片英文提示;AbstractPhil/json-coco-format提供系统提示与工具定义;AbstractPhil/qwen3.5-0.8b-task_1-lora完成首版结构化转写,并暴露出上下文关联有限、主题偏差与结构基座欠稳等局限。后续V2预期依赖更大模型训练以增强稳健性。这些构件共同推动工具调用蒸馏、结构化输出监督和概念字幕再加工,为COCO式JSON生成、SFT消息重建以及schema合规性评估提供了可复用的实验基础。
数据集最近研究
最新研究方向
在视觉语言预训练由自由文本对齐迈向可验证结构化语义接口的浪潮中,cc-task1-json所代表的蒸馏式数据构建正成为前沿探索。其研究指向利用Qwen3.5-0.8B LoRA将Conceptual Captions自然语言字幕转译为含主体、动作、场景、风格与情绪的任务式JSON,并以tool_call_valid、schema_valid与grounded三重信号筛选监督样本。该路径关联函数调用、多模态指令微调与合成数据质量评估等热点,为降低人工标注依赖、缓解字幕歧义、增强视觉模型可控生成与推理可解释性提供数据基石。其意义在于推动图文语料从描述性资源转化为可执行、可审计的语义监督,支撑机器人规划、视觉问答及跨模态检索等下游应用。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务