遇见数据集

sty-yyj/ElysiumTrack-1M

收藏
Hugging Face2024-07-18 更新2024-07-22 收录
官方服务:

资源简介:

ElysiumTrack-1M数据集是一个百万规模的对象感知视频数据集,支持单目标跟踪(SOT)、基于语言表达的单目标跟踪(RSOT)和视频引用表达式生成(Video-REG)等任务。数据集的视频来源于WebVid-10M,数据集的使用仅限于学术用途,不支持商业用途。

The ElysiumTrack-1M dataset is a million-scale object perception video dataset that supports tasks such as Single Object Tracking (SOT), Referring Single Object Tracking (RSOT), and Video Referring Expression Generation (Video-REG). The dataset contains 1.27M trajectories and 1.27M expressions, with a total duration of 9.2 months. The videos are sourced from WebVid-10M and are intended for academic use only, not supported for commercial usage.

提供机构:
sty-yyj
原始信息汇总

ElysiumTrack-1M 数据集概述

数据集简介

ElysiumTrack-1M 是一个百万级对象感知视频数据集,支持以下任务:

  • 单目标跟踪 (SOT):通过参考目标在第一帧中的初始位置,预测目标在连续帧中的位置。
  • 参考单目标跟踪 (RSOT):基于给定的语言表达,在整个视频中识别和定位特定目标。该任务提供了更灵活的跟踪格式,并建立了语言与跟踪之间的有价值联系。
  • 视频参考表达生成 (Video - REG):给定视频中任意帧中目标的坐标,任务是预测目标的描述。与传统的 REG 任务不同,Video - REG 要求模型具有时间感知能力,因为目标在当前帧中的外观可能受到遮挡或运动模糊的影响,但在其他帧中可以识别。

数据统计

数据集 #轨迹 #表达式 时长
OTB15 51 0 16.4 分钟
VOT14 25 0 5.7 分钟
VOT16 60 0 11.9 分钟
VOT17 60 0 11.9 分钟
UAV20L 20 0 32.6 分钟
UAV123L 91 0 1.1 小时
GOT - 10K 10K 0 1.7 天
LaSOT 1.4K 1.4K 1.4 天
TrackingNet 30.6K 0 5.6 天
ElysiumTrack -1M 1.27M 1.27M 9.2 个月

结果

模型 任务 AUC P $P_{Norm}$
MiniGPT-v2 RSOT 65.4 70.1 67.4
Elysium RSOT 87.5 94.5 93.7
Elysium SOT 88.7 94.6 93.8

数据来源

视频来自 WebVid-10M,该数据集的详细描述可以在 Frozen in Time 中找到。

使用范围

数据集设计用于支持 SOT、RSOT 和 Video-REG 等任务。

使用限制

仅限学术使用,不支持商业用途。

引用

@misc{wang2024elysiumexploringobjectlevelperception, title={Elysium: Exploring Object-level Perception in Videos via MLLM}, author={Han Wang and Yongjie Ye and Yanjie Wang and Yuxiang Nie and Can Huang}, year={2024}, eprint={2403.16558}, archivePrefix={arXiv}, primaryClass={cs.CV}, url={https://arxiv.org/abs/2403.16558}, }
搜集汇总
数据集介绍
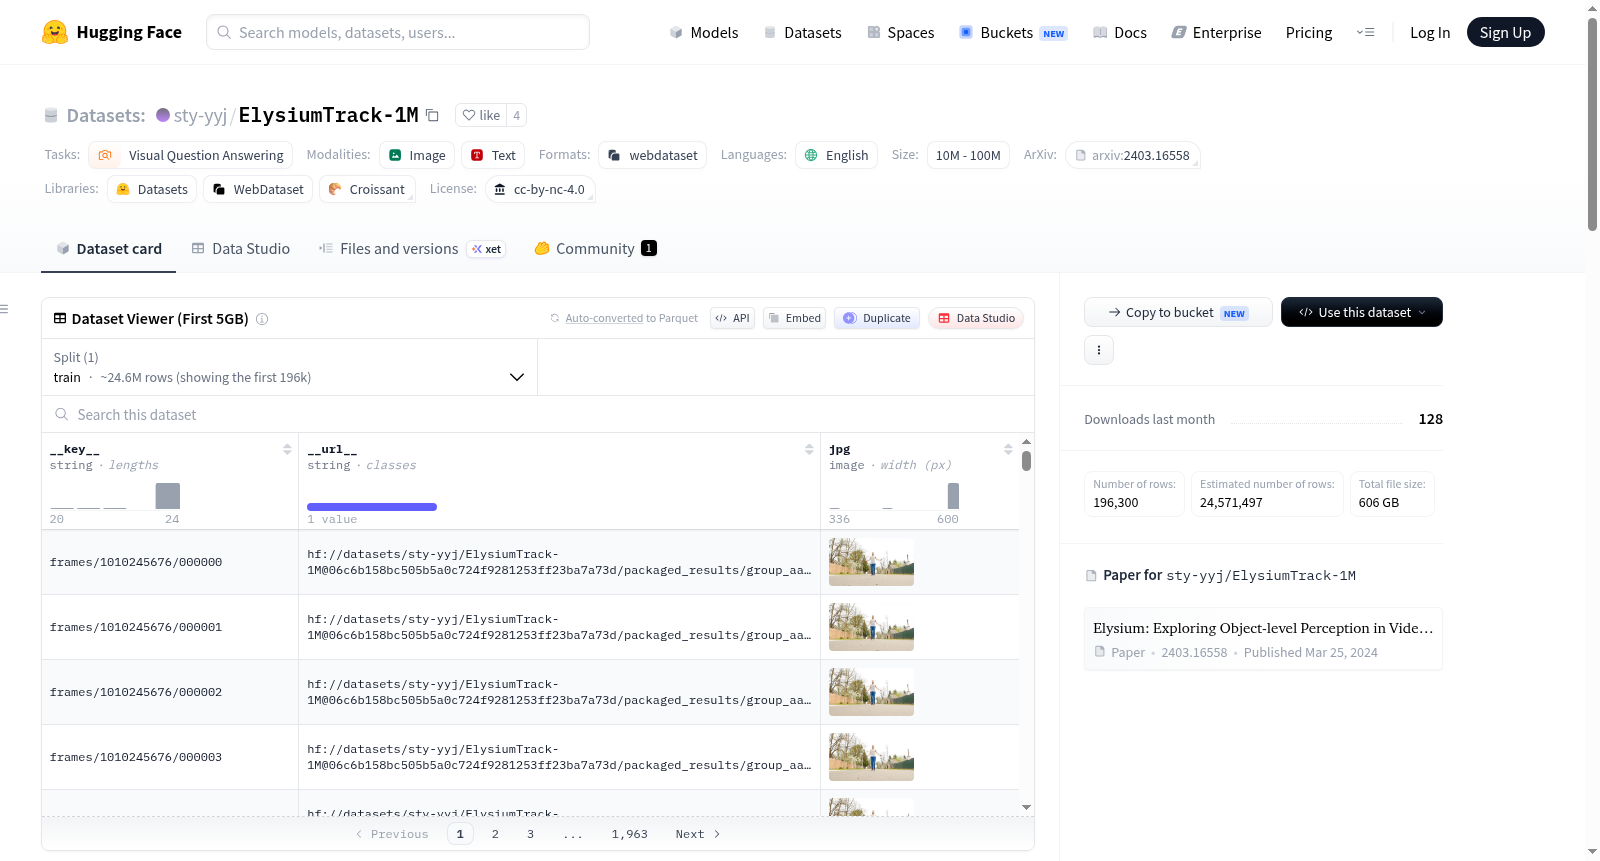
sty-yyj/ElysiumTrack-1M 数据集图片
构建方式
在视频理解领域,大规模、多模态的感知数据集是推动模型迈向通用智能的关键基石。ElysiumTrack-1M数据集正是基于这一理念,从WebVid-10M海量视频库中精心筛选并标注而成,构建了包含127万条轨迹与对应语言描述的庞大规模。其构建过程依托于精确的自动追踪算法与人工校验相结合的策略,为每条视频轨迹赋予精准的边界框序列,并同步生成与之语义匹配的自然语言表达,从而实现了视觉定位与语言描述的深度融合。这一系统性构建方式,不仅确保了数据规模的数量级突破,更在质量上保障了轨迹的连续性与表达的准确性,为视频级目标感知研究提供了坚实的数据支撑。
特点
该数据集的核心特质在于其百万级的庞大规模与多任务协同设计,总时长高达9.2个月,远超现有同类基准。其独到之处在于同时支持单目标跟踪(SOT)、指代性单目标跟踪(RSOT)以及视频指代表达生成(Video-REG)三项关键任务。尤其是RSOT与Video-REG任务的引入,突破了传统视觉跟踪仅依赖框标注的局限,通过语言与视觉的跨模态对齐,赋予了模型在复杂场景下基于语义描述进行灵活追踪的能力。此外,数据集在轨迹多样性上表现卓越,涵盖不同时长、运动模式与遮挡程度的视频片段,有效模拟了真实世界中的长尾分布,为评估模型的时序感知与鲁棒性提供了严苛的测试环境。
使用方法
研究者可直接利用该数据集开展SOT、RSOT与Video-REG等任务的模型训练与评估。使用方法上,数据以标准化的视频帧序列与对应的轨迹标注、语言表达形式提供,便于直接加载至诸如MiniGPT-v2等视觉语言模型中进行微调。对于SOT任务,模型需依据首帧目标框预测后续帧位置;对于RSOT任务,模型需根据给定的自然语言描述在整个视频中定位目标;而Video-REG任务则要求模型根据任意帧的目标坐标生成其描述。建议用户参照论文中Elysium模型的训练范式,结合多任务损失函数进行联合优化,以充分发挥该数据集在跨模态感知与时序推理方面的潜力。
背景与挑战
背景概述
在视频理解领域,对象级感知任务如单目标跟踪、指代跟踪与视频指代表达生成,长期受限于标注数据的规模与多样性。2024年,由Han Wang、Yongjie Ye等研究者提出的ElysiumTrack-1M数据集,依托WebVid-10M视频源,构建了包含127万条轨迹与对应语言表达的海量资源,总时长超过9个月,远超以往数据集如LaSOT或TrackingNet的规模。该数据集旨在推动多模态大语言模型在视频中的对象级理解,其核心研究问题在于如何通过语言与视觉的深度融合,实现更灵活、鲁棒的跟踪与描述任务。ElysiumTrack-1M的发布为视频感知领域提供了前所未有的训练与评估基准,显著提升了模型在复杂场景下的表现,例如其配套模型Elysium在指代跟踪任务上AUC达到87.5%,展现了强大的影响力。
当前挑战
ElysiumTrack-1M所解决的领域挑战主要在于传统视频跟踪数据集规模有限且缺乏语言标注,难以支持多模态模型的训练需求。该数据集通过百万级轨迹与表达,攻克了对象级感知中语言与视觉对齐的难题,并提升了模型应对遮挡、运动模糊等时空变化的能力。在构建过程中,挑战尤为突出:首先,从WebVid-10M的千万级视频中筛选并生成高质量轨迹与表达,需克服自动标注的噪声与歧义问题;其次,确保轨迹在长视频中的连续性,避免因帧间中断导致数据失效;最后,平衡数据多样性(如场景、对象类别)与标注一致性,以降低模型过拟合风险。这些挑战的解决为后续研究提供了关键经验。
常用场景
经典使用场景
ElysiumTrack-1M作为百万级规模的视频目标感知数据集,其最经典的使用场景集中于单目标跟踪(SOT)、基于语言表达的指代单目标跟踪(RSOT)以及视频指代表达生成(Video-REG)三大核心任务。在SOT任务中,模型需依据初始帧给定的目标位置,在后续帧中持续预测其空间坐标;RSOT则引入自然语言描述作为指引,要求模型在完整视频中定位并追踪语言所指的特定对象,极大提升了跟踪的灵活性与人机交互的直观性;Video-REG任务则反其道而行之,给定任意帧中目标的坐标,模型需生成对该目标的语义描述,并需具备跨帧融合时序信息以应对遮挡或运动模糊的能力。该数据集凭借其1.27M条轨迹与等量的语言表达,为多模态视频理解提供了规模空前的训练与评测基准。
实际应用
在实际应用层面,ElysiumTrack-1M所支撑的RSOT与Video-REG任务直接服务于智能监控、自动驾驶、人机交互与视频编辑等前沿领域。例如,在智能安防场景中,用户可通过自然语言指令(如“穿红色外套的男子”)在监控录像中实时锁定并追踪目标,极大简化了操作流程;在自动驾驶系统中,车辆可利用语言描述(如“前方左侧的白色轿车”)精准跟踪周围交通参与者,提升环境感知的语义层次。此外,Video-REG技术可用于自动生成视频中对象的描述性字幕,辅助视障人士理解动态视觉内容,或为视频检索与内容管理提供细粒度标签。该数据集通过将语言与视觉轨迹深度耦合,为构建能理解并响应人类自然指令的智能视频系统提供了坚实的训练基础,推动了从被动感知到主动交互的技术落地。
衍生相关工作
ElysiumTrack-1M的发布催生了一系列具有影响力的衍生工作,其中最为经典的是同一研究团队提出的Elysium多模态大语言模型(MLLM),该模型在该数据集上针对RSOT和SOT任务取得了显著成果(RSOT AUC达87.5,SOT AUC达88.7),验证了大规模语言-轨迹对齐数据对提升视频目标感知性能的有效性。此外,该数据集也被用于评估和微调现有视觉语言模型(如MiniGPT-v2)在视频跟踪任务上的表现,揭示了通用多模态模型在细粒度时序定位方面的潜力与局限。基于ElysiumTrack-1M的基准测试,后续研究进一步探索了跨任务知识迁移、语言引导的跟踪鲁棒性分析以及视频级指代表达生成的统一框架,推动领域从单一目标跟踪向多模态、多任务协同感知演进,为未来构建通用视频理解智能体奠定了关键数据与方法基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务