flytech/llama-python-codes-30k
收藏资源简介:
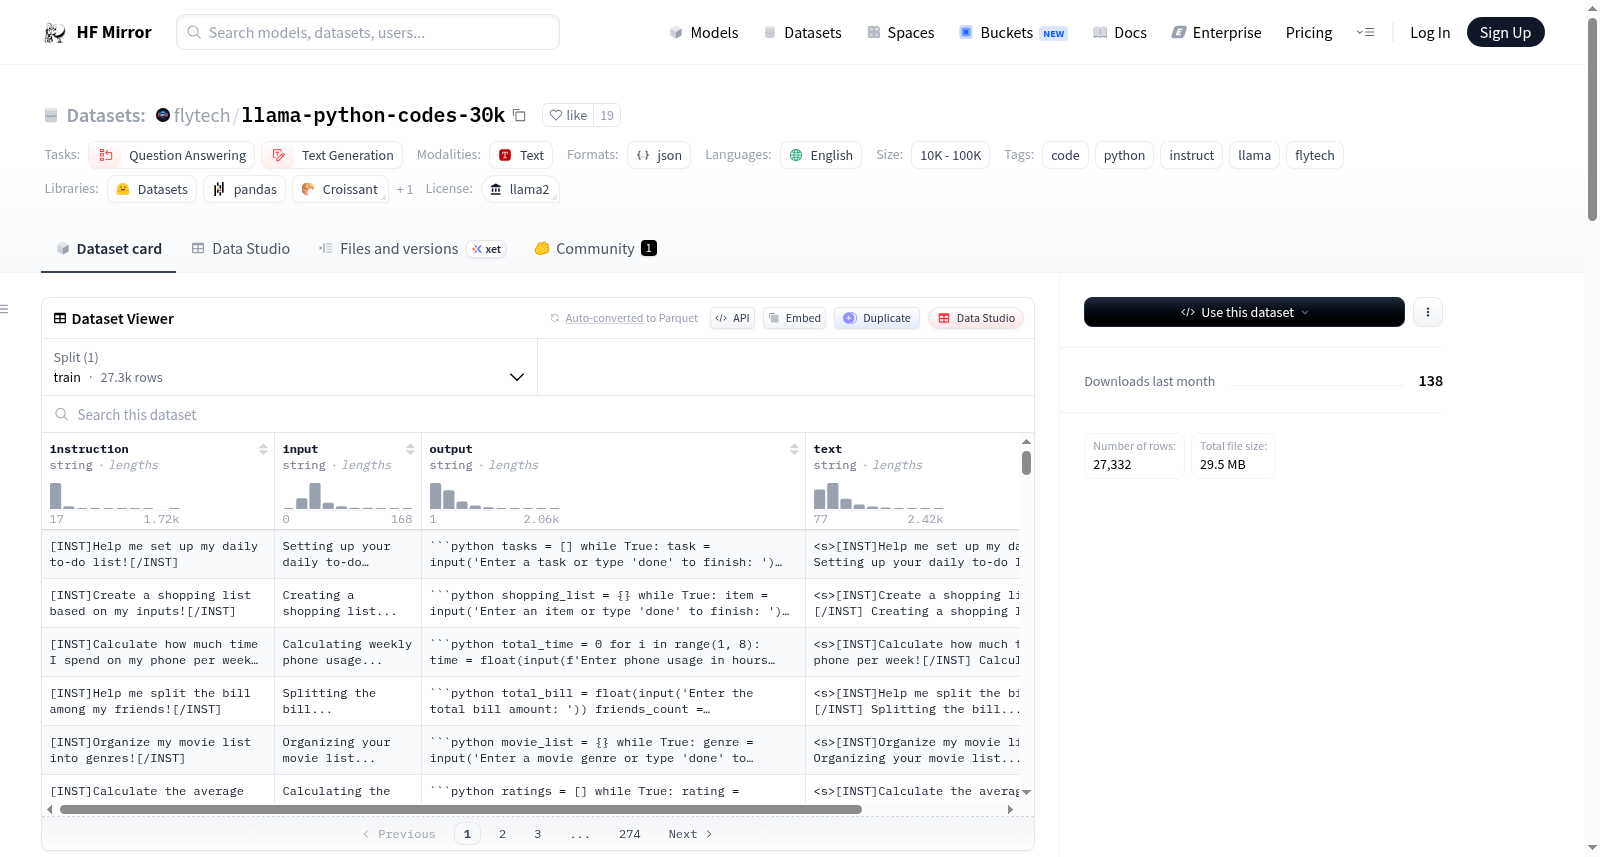
Llama1/2 Python Codes 30k Tokenized数据集是一个丰富的资源,适用于多种自然语言处理任务,如问答、文本生成和文本到文本生成。它主要关注Python的指令任务,并针对Llama架构进行了标记化处理。数据集包含GPT-4生成的内容、自定义代码、行为方法以及超出Python范围的任务。数据集未经过清洗,输入条目数量较少。数据集的大小在10M到100M之间,包含27,331个示例,总标记数为13,993,984。
The Llama1/2 Python Codes 30k Tokenized dataset is a rich resource suitable for a wide range of natural language processing tasks, including question answering, text generation, and text-to-text generation. It primarily centers on Python instruction-related tasks and has been tokenized specifically for the Llama architecture. The dataset encompasses content generated by GPT-4, custom code, behavioral methodologies, and tasks that extend beyond the scope of Python. It is unfiltered and contains a relatively small number of input entries. With a size ranging from 10M to 100M, the dataset includes 27,331 examples and has a total of 13,993,984 tokens.
数据集概述
基本信息
- 作者: FlyTech
- 许可证: llama2
- 任务类别:
- 问答
- 文本生成
- 文本到文本生成
- 语言: 英语
- 标签:
- code
- python
- instruct
- llama
- flytech
- 名称: Llama1/2 Python Codes 30k Tokenized
- 大小类别: 10M<n<100M
详细描述
- 概述: 该数据集是一个丰富的资源,适用于各种自然语言处理任务,如问答、文本生成和文本到文本生成。它主要关注Python中的指令任务,并针对Llama架构进行了标记化。数据集包括GPT-4生成的内容、自定义代码、行为方法和超越Python的任务。
重要提示
- 警告: 该数据集(llama-python-codes-30k)未经过清理,具有非常低的唯一输入条目数量。对于完全清理、去标记化并过滤输入条目的版本,请参考flytech/python-codes-25k。
数据集指标
- 标记计数(通过LlamaTokenizer):
- 最大值: 508
- 平均值: 158.06
- 总计: 13,993,984
- 单词计数: 1,890,810
- 示例数量: 27,331
使用方法
python from datasets import load_dataset
dataset = load_dataset(flytech/llama-python-codes-30k, split=train)
可以以任何方式映射数据集,例如:
dataset = dataset.map(lambda example: {text: example[instruction] + + example[input] + + example[output]})[text]
许可证
该数据集使用llama2许可证。