jupyter-agent-dataset
收藏资源简介:
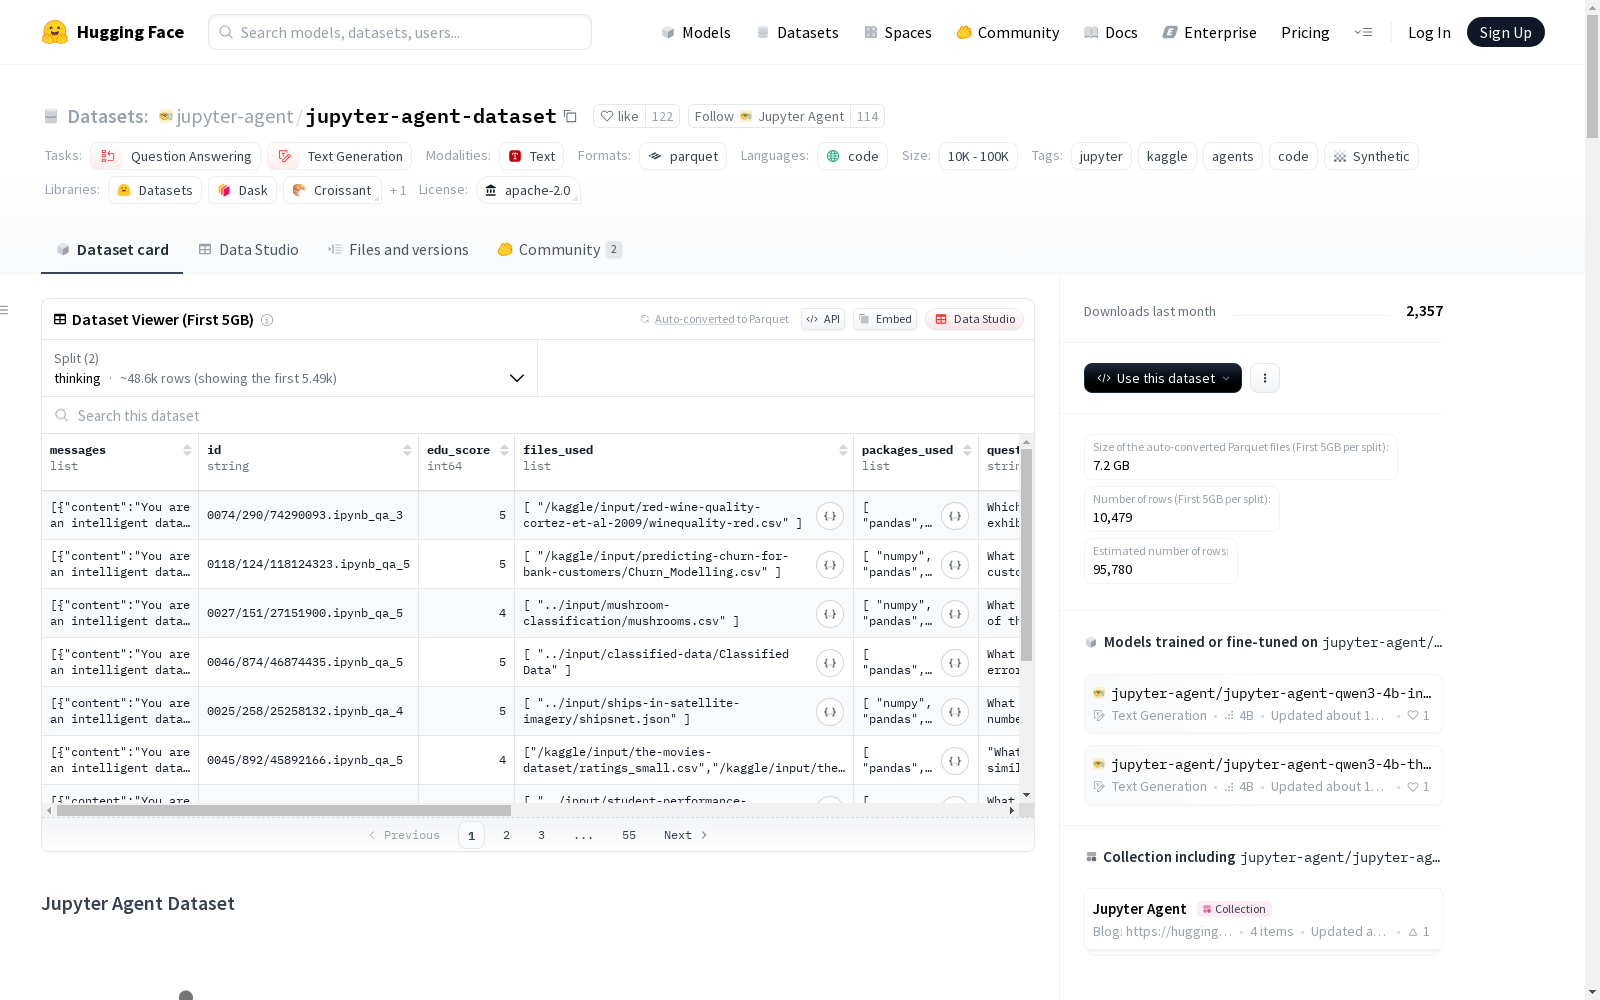
Jupyter Agent Dataset 是一个由真实 Kaggle 笔记本经过多阶段处理生成的数据集,用于训练代码代理。数据集包括自然语言问题、验证答案和执行跟踪,适合训练代码代理进行数据集理解和代码执行。数据集分为 'thinking' 和 'non-thinking' 两个子集,分别包含带有和不带有思考注释的代码生成内容。数据集包含 51389 个合成笔记本,总计约 2 亿个训练标记。数据集可以帮助模型在 DABstep 基准测试中取得显著提升,并提高模型的数据探索和编码技能。
Jupyter Agent Dataset is a dataset generated from real Kaggle notebooks through multi-stage processing, dedicated to training code agents. The dataset includes natural language questions, validated answers and execution traces, which is suitable for training code agents to perform dataset comprehension and code execution. It is divided into two subsets: 'thinking' and 'non-thinking', which contain code generation content with and without thought annotations respectively. The dataset contains 51,389 synthetic notebooks, totaling approximately 200 million training tokens. This dataset can help models achieve significant improvements on the DABstep benchmark, and enhance models' data exploration and coding skills.
Jupyter Agent Dataset
数据集概述
Jupyter Agent Dataset 是一个基于真实 Kaggle 笔记本的合成数据集,专门用于训练代码代理。数据集通过多阶段流水线处理,包括去重、获取参考数据集、评分教育质量、过滤数据分析相关内容、生成基于数据集的问答对,以及通过运行笔记本产生可执行推理轨迹。
关键信息
- 创建者: Hugging Face Jupyter-Agent 团队
- 许可证: Apache-2.0
- 语言: 代码
- 标注方式: 机器生成
- 多语言性: 单语
- 数据规模: 10K<n<100K
- 任务类别: 问答、文本生成
- 标签: jupyter、kaggle、agents、code、synthetic
数据集结构
数据集包含 51,389 个合成笔记本,总计约 2 亿训练标记。提供两个子集:
thinking: 包含思考标签的代码生成思考评论non_thinking: 不包含思考标签的代码生成
数据特征
每个示例包含以下字段:
id: 笔记本和问答对的唯一标识符messages: ChatML 格式的合成笔记本question: 基于笔记本/数据集的自然语言问题answer: 经过验证的简短最终答案edu_score: 教育质量评分(LLM 分配)files_used: 原始参考 Kaggle 笔记本中使用的文件packages_used: 原始参考 Kaggle 笔记本中使用的包kaggle_dataset_name: 完整的 Kaggle 源数据集名称executor_type: 代码执行器类型(E2B 或 LLM/Qwen-Coder)original_notebook: 原始 Kaggle 源笔记本tools: 用于笔记本生成的工具调用
数据集用途
用于训练能够执行以下任务的代码代理:
- 阅读笔记本和数据集上下文
- 执行 Python 代码(如 pandas、numpy、matplotlib)回答基于数据集的问题
- 生成带有中间计算的逐步解决方案
数据集创建过程
数据来源与准备
- 大规模去重 Kaggle 笔记本
- 下载链接的数据集
- 教育质量评分
- 过滤不相关的笔记本
合成笔记本生成
- 问答对生成:使用 Qwen-32B 生成基于数据集的问答对
- 轨迹生成:使用 Qwen-Coder-480B 生成代码/思考,通过 E2B 执行
技术依赖
- Datatrove:大规模处理真实 Kaggle 笔记本
- Qwen-32B:评分和问答生成
- Qwen-Coder-480B:笔记本和代码执行轨迹生成
- E2B:安全沙盒执行
使用注意事项
- 许可和条款:上游 Kaggle 笔记本和数据集有其自己的许可证/服务条款
- 数据质量:笔记本可能包含错误、非确定性输出或环境特定行为
- LLM 生成内容:问答对和验证是机器生成的,可能包含错误
- 偏见:源笔记本和数据集可能反映作者/领域偏见
- 安全性:可执行轨迹可能包含环境特定代码
数据集统计
- 总字节数:102,156,900,168
- 下载大小:71,781,735,066
- 示例数量:51,389
引用信息
@misc{jupyteragentdataset, title={Jupyter Agent Dataset}, author={Baptiste Colle and Hanna Yukhymenko and Leandro von Werra}, year={2025} }