遇见数据集

aitamilnadu/tamil_stories

收藏
Hugging Face2024-01-23 更新2024-03-04 收录
官方服务:

资源简介:

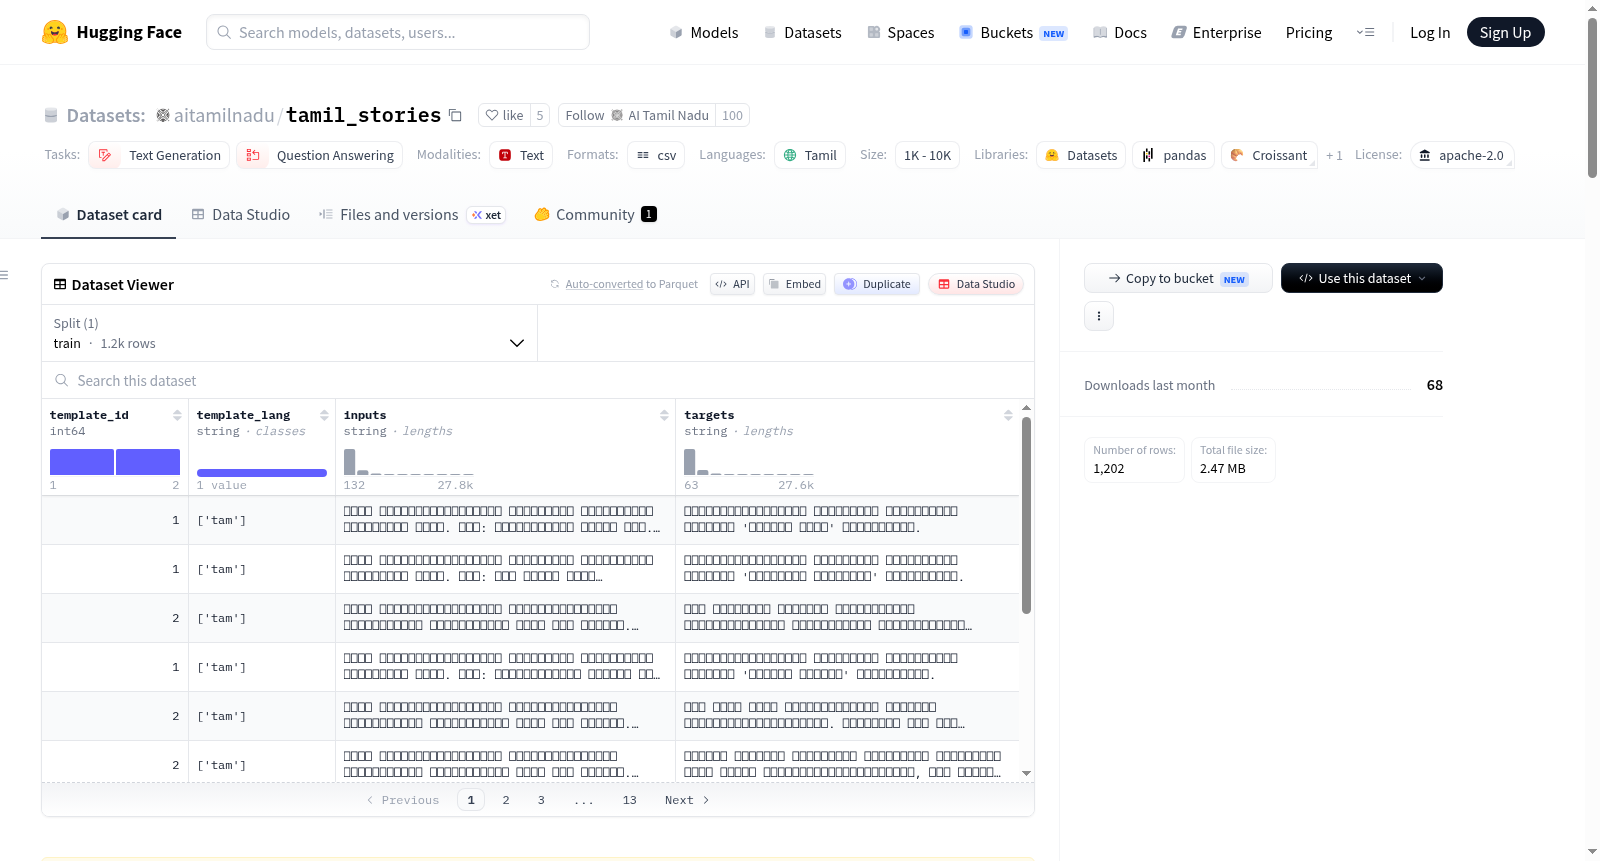
`tamil_stories`是一个开源数据集,包含了从公开的泰米尔语短故事网站抓取并转换为指令风格的记录。数据集经过自动清理和志愿者手动标记,适用于多种任务,如训练大型语言模型、生成合成数据、数据增强和问答。数据集由Cohere For AI的Aya Open Science Initiative创建,遵循Apache 2.0许可证,可用于学术或商业目的。数据集包含1202条记录,主要用于根据故事生成标题或根据关键词和标题生成完整故事。数据集的创建目的是为了填补泰米尔语在AI/ML领域缺乏指令风格数据集的空白。

`tamil_stories`是一个开源数据集,包含了从公开的泰米尔语短故事网站抓取并转换为指令风格的记录。数据集经过自动清理和志愿者手动标记,适用于多种任务,如训练大型语言模型、生成合成数据、数据增强和问答。数据集由Cohere For AI的Aya Open Science Initiative创建,遵循Apache 2.0许可证,可用于学术或商业目的。数据集包含1202条记录,主要用于根据故事生成标题或根据关键词和标题生成完整故事。数据集的创建目的是为了填补泰米尔语在AI/ML领域缺乏指令风格数据集的空白。

提供机构:
aitamilnadu
原始信息汇总

数据集概述

tamil_stories 是一个开源数据集,包含1202条指令风格的记录,通过抓取公开可用的短篇故事生成。该数据集可用于以下任务:

  • 给定故事,生成适当的标题。
  • 给定故事中的一些突出角色/词汇以及标题,生成完整的故事。

数据集详情

  • 许可证:Apache 2.0
  • 任务类别:文本生成、问答、对话
  • 语言:泰米尔语
  • 数据规模:1K<n<2K
  • 语言创建者:专家生成、机器生成
  • 多语言性:单语种
  • 数据集名称:tamil_stories

数据集用途

该数据集主要用于指令微调大型语言模型,也可用于合成数据生成和数据增强。

数据集来源

数据从以下网站抓取:

数据处理

  • 数据通过抓取和自动清洗生成,并由志愿者手动标记。
  • 抓取的数据经过仔细分析,确保没有遗漏的单词、拼写错误,并且数据仅包含泰米尔语。
  • 单词/字符由志愿者手动添加到故事中。
  • 最后,将预处理的数据转换为指令风格的提示和完成。

模板

用于创建指令风格提示和完成的模板如下:

模板1

python Prompt: கீழே கொடுக்கப்பட்டுள்ள கதைக்குப் பொருத்தமான தலைப்பைக் கொடு. கதை: {Story}

Completion: கொடுக்கப்பட்டுள்ள கதைக்குப் பொருத்தமான தலைப்பு {Title} என்பதாகும்.

模板2

python Prompt: கீழே கொடுக்கப்பட்டுள்ள வார்த்தைகளையும் தலைப்பையும் பயன்படுத்தி சிறு கதை எழுதுக. வார்த்தைகள்: {Comma_Seperated_Words} தலைப்பு: {Title}

Completion: {Story}

个人或敏感数据

该数据集包含公共信息,据我所知,没有私人个人的个人标识符或敏感信息。

已知限制

  • 提示/完成中使用的含义是根据完整句子的可用性随机选择的,这可能会忽略其他学者编写的其他含义,从而反映出一些偏见。

贡献者
搜集汇总
数据集介绍
aitamilnadu/tamil_stories 数据集图片
构建方式
该数据集源自泰米尔语低资源语言背景下对开源短篇故事的系统性采集。构建过程首先通过定制化网络爬虫从Siruvarmalar与Tamilsurangam两大泰米尔语文学网站抓取原始文本,随后经由自动化清洗流程剔除噪声信息。在此基础上,志愿者团队对数据进行了精细的人工标注,包括校正拼写错误、确保语言纯净性,并手动为故事添加关键词或人物信息。最终,利用预设的指令模板将预处理后的语料转化为结构化的提示-完成对,形成涵盖故事标题生成与基于关键词的完整故事创作两种任务类型的指令式数据集。
特点
该数据集包含1202条高质量指令记录,专为泰米尔语这一资源稀缺语言设计,填补了该语种在指令微调领域的空白。其核心特点在于双任务范式:既可基于故事内容生成标题,也能依据给定词汇与标题逆向还原完整叙事,这种双向映射结构赋予了模型更强的语义理解与生成能力。数据集采用Apache 2.0开源协议,支持学术与商业用途,打破了非商业限制的壁垒。所有数据经人工与机器双重校验,确保泰米尔语文本的准确性与文化保真度。
使用方法
用户可通过HuggingFace Datasets库便捷加载该数据集,仅需安装datasets库并调用load_dataset('aitamilnadu/tamil_stories')即可获取。该数据集适用于大语言模型的指令微调,尤其适合泰米尔语文本生成、问答系统与对话模型训练。研究者亦可将其作为少样本示例,提交至开源大模型以生成风格相似的泰米尔语新故事,实现合成数据扩展。此外,数据集支持数据增强与迁移学习,开发者可基于其模板结构自定义任务,如故事分类或角色关系推理,灵活适配多样化自然语言处理场景。
背景与挑战
背景概述
在自然语言处理领域,低资源语言的数据稀缺始终是制约大语言模型性能提升的关键瓶颈。泰米尔语作为拥有数千年文学积淀的古老语言,其数字化语料库的匮乏使得该语言在人工智能研究中长期处于边缘地位。为弥合这一鸿沟,Cohere For AI于2023年发起Aya开放科学倡议,由miluckshan-j等七位研究者组成的团队,通过系统性爬取Siruvarmalar和Tamilsurangam两个泰米尔语短篇小说网站,结合人工标注与自动化清洗,创建了包含1202条指令式记录的tamil_stories数据集。该数据集采用Apache 2.0许可协议发布,开创了泰米尔语首个面向指令微调的开源语料库,为低资源语言的模型训练、数据增强及问答系统研究提供了标准化基准,其影响力辐射至学术与商业应用领域。
当前挑战
该数据集面临的核心挑战体现在两个维度。从领域问题层面,泰米尔语作为低资源语言,现存语料多为非结构化文本,缺乏适配大语言模型指令微调的高质量标注数据,导致模型在故事生成、标题预测等任务中难以捕捉泰米尔语独特的语法结构与文化隐喻。从构建过程层面,团队需应对三大技术障碍:其一,爬取自不同网站的短篇小说存在编码不一致、拼写错误及非泰米尔语字符混入等噪声,需设计定制化清洗脚本;其二,指令式模板的语义映射具有主观性,如从故事中提取关键词时,不同志愿者对‘显著角色’的界定存在差异,可能引入标注偏差;其三,数据集规模仅千余条,远未达到大模型微调所需的数据量级,且故事主题集中于儿童文学,导致领域覆盖度有限,影响模型泛化能力。
常用场景
经典使用场景
在自然语言处理与低资源语言模型研究的交汇点上,泰米尔语作为拥有悠久文学传统却鲜有指令式数据集的语种,其发展长期受限于数据匮乏。'tamil_stories' 数据集应运而生,其经典使用场景聚焦于指令微调:通过将泰米尔语短篇故事转化为结构化指令模板,支持从故事生成标题,或依据标题与关键词还原完整故事。这种任务设计不仅为泰米尔语大语言模型提供了高质量的监督训练样本,更开创性地为低资源语言构建了可复用的指令式数据范式,推动了多语言模型在文化多样性上的公平发展。
解决学术问题
该数据集精准回应了低资源语言在自然语言处理中的核心困境——缺乏高质量、可商用的指令式语料。传统泰米尔语数据集多局限于非商业用途或未经结构化的原始文本,而 'tamil_stories' 通过人工标注与自动化清洗的协作,提供了1202条开放许可的指令记录,解决了学术研究中模型微调时数据稀缺与版权限制的双重障碍。其意义在于,为多语言模型在泰米尔语上的生成能力、问答系统及对话系统的评估提供了基准,并验证了从民间文学资源中提取训练数据的可行性,从而拓宽了低资源语言NLP的研究边界。
衍生相关工作
基于 'tamil_stories' 的数据构建方法,衍生了一系列针对低资源语言的指令式数据集创建工具与研究工作。例如,其配套的开源爬虫与清洗脚本(如 Tamilsurangam Webscraper)被社区复用至其他印度语言,推动了类似马拉雅拉姆语、泰卢固语等语种的指令数据集建设。此外,该数据集作为 Aya 开放科学倡议的一部分,为多语言模型对齐研究提供了泰米尔语基准,后续工作如跨语言故事生成模型评估、文化适应型NLG系统的开发,均以此数据为起点,验证了民间文学资源在促进语言技术包容性上的潜力。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务