
ZHEZIXI/llama3weitiao
收藏官方服务:
资源简介:
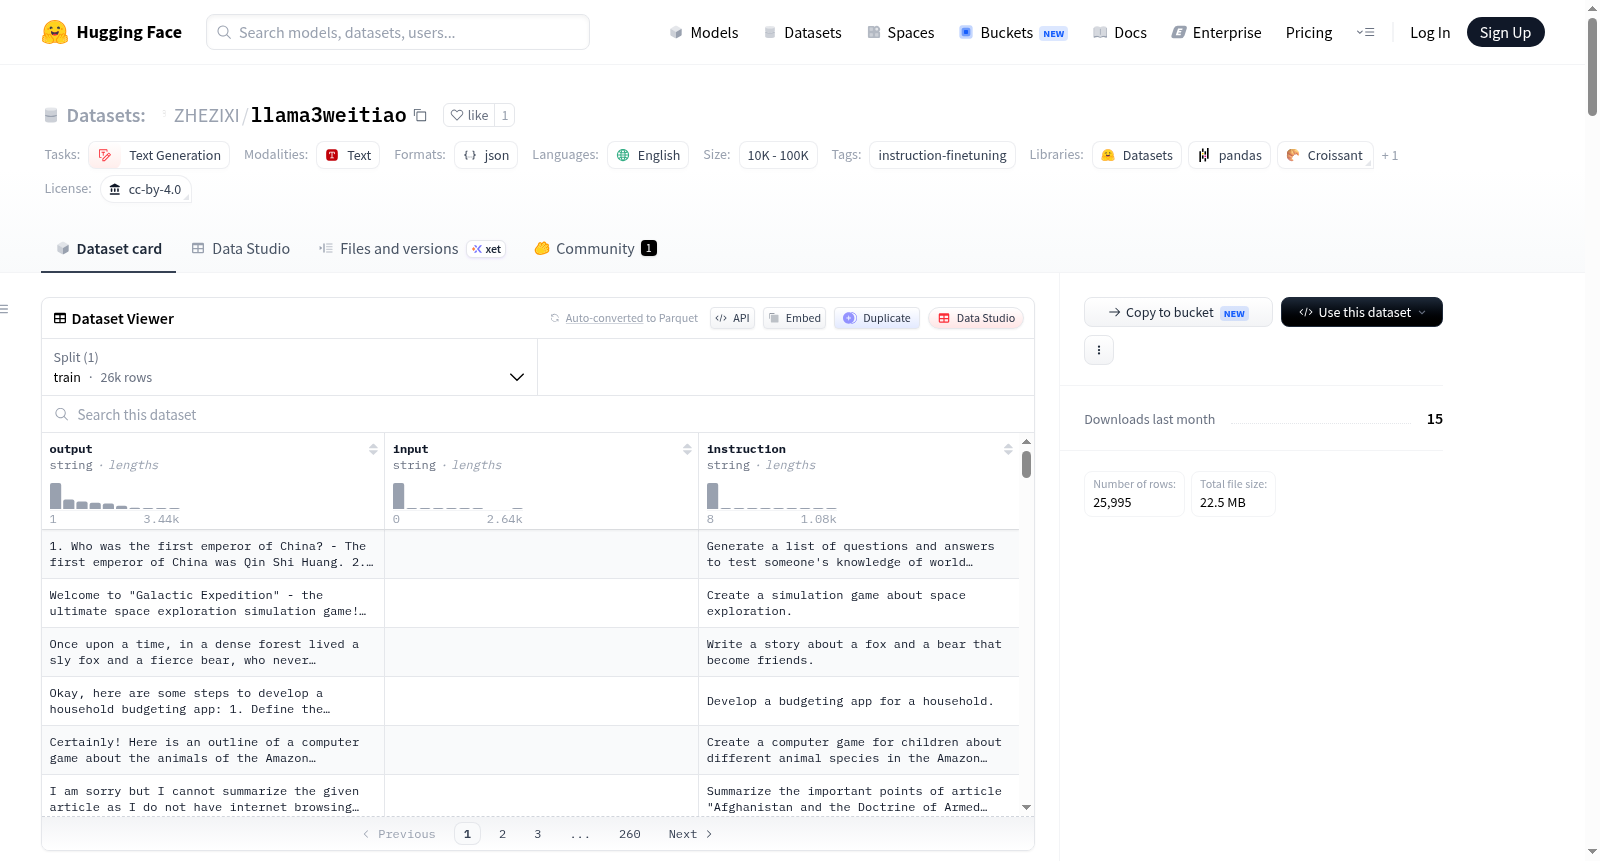
Alpaca-Cleaned数据集是原始Alpaca数据集的清理版本,修复了原始数据集中存在的多个问题,如幻觉、合并指令、空输出、空代码示例、生成图像指令、N/A输出、不一致的输入字段、错误答案、非清晰指令以及多余的转义和控制字符。数据集包含52,000条指令和演示,用于指令微调语言模型,使其更好地遵循指令。数据集为英文,结构包括指令、输入、输出和格式化文本字段。
Alpaca-Cleaned数据集是原始Alpaca数据集的清理版本,修复了原始数据集中存在的多个问题,如幻觉、合并指令、空输出、空代码示例、生成图像指令、N/A输出、不一致的输入字段、错误答案、非清晰指令以及多余的转义和控制字符。数据集包含52,000条指令和演示,用于指令微调语言模型,使其更好地遵循指令。数据集为英文,结构包括指令、输入、输出和格式化文本字段。
提供机构:
ZHEZIXI原始信息汇总
数据集概述
数据集名称: Alpaca-Cleaned
数据集描述: Alpaca-Cleaned 是斯坦福大学发布的原始 Alpaca 数据集的清理版本。该版本解决了原始数据集中的多个问题,包括幻觉现象、合并指令、空输出、空代码示例、生成图像的指令、N/A 输出、输入字段不一致、错误答案以及指令不清晰或无意义等问题。
数据集来源:
- 原始数据集由 OpenAI 的
text-davinci-003引擎生成,包含 52,000 条指令和演示。 - 清理后的数据集解决了原始数据集中的多项问题,提高了数据质量。
数据集结构:
- 数据实例: 每个实例包含
instruction(指令)、input(可选输入)、output(输出)和text(格式化的指令、输入和输出)。 - 数据字段:
instruction: 描述模型应执行的任务。input: 提供任务的上下文或输入。output: 由text-davinci-003生成的指令答案。text: 使用作者提供的模板格式化的指令、输入和输出。
数据集用途:
- 用于指令微调预训练语言模型,提高模型遵循指令的能力。
语言:
- 数据集语言为英语(BCP-47 en)。
许可证:
- 数据集根据 Creative Commons NonCommercial (CC BY-NC 4.0) 许可发布。
数据集创建注意事项:
- 数据由语言模型生成,可能包含错误或偏见。建议用户谨慎使用,并提出新的方法来过滤或改进这些不完美之处。
数据集问题修复详情
- 幻觉现象: 原始数据集中许多指令引用互联网数据,导致 GPT3 产生幻觉答案。
- 合并指令: 原始数据集中存在多个指令被合并的情况。
- 空输出: 原始数据集中部分条目输出为空。
- 空代码示例: 原始数据集中描述缺少代码示例,难以理解代码意图。
- 生成图像的指令: 原始数据集中包含无法实现的生成图像指令。
- N/A 输出: 原始数据集中部分代码片段输出标记为 N/A。
- 输入字段不一致: 原始数据集中输入字段的使用不一致。
- 错误答案: 原始数据集中约 80% 的数学问题答案估计错误。
- 非理性/不清晰指令: 原始数据集中存在不清晰或无意义的指令。
- 多余转义和控制字符: 原始数据集中包含多余转义和控制字符。
搜集汇总
数据集介绍
构建方式
在自然语言处理领域,指令微调数据集是提升语言模型遵循人类指令能力的关键资源。ZHEZIXI/llama3weitiao数据集源自斯坦福大学发布的Alpaca数据集,并经过严格清洗与优化。原始Alpaca数据集通过OpenAI的text-davinci-003引擎,基于Self-Instruct框架生成52,000条指令-演示对,但存在幻觉、合并指令、空输出、代码示例缺失、图像生成指令、N/A输出、输入字段不一致、错误答案、非明确指令及多余转义字符等十类问题。本数据集针对这些缺陷进行了系统性修复,例如移除引用网络链接导致的幻觉样本、拆分合并指令、补充缺失输出、剔除图像生成任务、统一空输入格式、校正数学题错误答案、重写模糊指令并清理控制字符,从而构建出更高质量、更可靠的指令微调数据。
特点
该数据集的核心特点在于其纯净性与实用性。相较于原始Alpaca数据,它显著降低了噪声与错误率,尤其修正了约80%的数学题错误,确保模型训练数据的准确性。数据集包含52,002条训练样本,每条样本由指令(instruction)、可选上下文输入(input)、模型输出(output)及格式化文本(text)四字段构成,其中约40%的样本包含输入字段,增强了任务的多样性。数据完全使用英文,覆盖分类、摘要、数学推理等多种任务类型,且指令经过唯一性验证,避免了重复样本。此外,数据集采用CC BY-NC 4.0许可协议,支持非商业研究与学术探索,为指令微调领域提供了可靠的基准资源。
使用方法
使用本数据集进行模型微调时,可直接加载HuggingFace上的ZHEZIXI/llama3weitiao仓库。数据以标准JSON格式存储,字段结构清晰,便于与常见深度学习框架(如Transformers库)集成。用户可将‘text’字段作为模型输入,该字段已按Alpaca作者使用的提示模板格式化,包含指令、输入和响应的完整上下文。对于自定义训练流程,也可单独提取instruction、input和output字段进行灵活处理。数据集仅包含训练拆分,适用于监督式指令微调任务,如基于LLaMA架构的模型优化。建议在微调前进行数据划分与预处理,以适配具体模型的需求,并注意数据英文属性,确保任务语言一致性。
背景与挑战
背景概述
Alpaca-Cleaned数据集由斯坦福大学研究团队于2023年创建,旨在解决原始Alpaca数据集中存在的质量问题。该数据集基于OpenAI的text-davinci-003引擎生成的52,000条指令-演示对,专注于指令微调任务,以提升语言模型遵循指令的能力。其核心研究问题在于如何通过高质量、低成本的合成数据实现大语言模型的指令跟随性能优化。作为Alpaca数据集的清洗版本,它修正了原始数据中的幻觉、合并指令、空输出、错误答案等十类缺陷,为学术界提供了更可靠的基准资源。该数据集在指令微调领域具有重要影响力,促进了可控实验和可重复性研究,推动了基于合成数据的语言模型训练方法发展。
当前挑战
Alpaca-Cleaned数据集所解决的领域挑战主要集中在指令微调数据的质量保障上。原始Alpaca数据存在严重幻觉问题,许多指令要求总结网络文章或描述图片,而GPT-3只能生成虚构内容;数学问题中约80%的答案错误,如将数据集{1,2,4,5,8,9}的中位数误算为5。构建过程中面临的挑战包括:识别并消除合并指令(如投资建议与名词识别任务被拼接)、处理空输出和N/A输出、统一不一致的输入字段(如<no input>、No input等变体)、移除无意义指令(如冷冻酸奶样本)以及清除多余转义字符。这些问题的系统性修复需要大量人工审核与规则设计,确保清洗后的数据集既保持多样性又具备正确性。
常用场景
经典使用场景
在自然语言处理与大型语言模型微调的研究中,ZHEZIXI/llama3weitiao数据集作为Alpaca-Cleaned的精炼版本,其经典用途在于为指令微调(instruction finetuning)提供高质量的训练样本。该数据集通过对原始斯坦福Alpaca数据集进行系统性清洗,剔除了包含幻觉、合并指令、空输出及错误答案等噪声数据,尤其纠正了约80%的数学问题错误,从而为研究者提供了一个更可靠、更纯净的指令遵循训练基准。这使得该数据集成为评估和改进语言模型在多样化任务上遵循人类指令能力的基石,广泛应用于文本生成、分类、摘要等任务的模型微调与性能对比。
解决学术问题
该数据集核心解决了指令微调领域中数据质量参差不齐的学术难题。原始Alpaca数据集因自动生成而存在大量幻觉、逻辑矛盾及格式不一致问题,严重影响了微调模型的鲁棒性和泛化能力。ZHEZIXI/llama3weitiao通过系统性修复这些缺陷,为研究者提供了更可信的训练数据,从而推动了关于如何构建高质量指令数据集的方法论探索。其意义在于,它不仅提升了模型在数学推理、事实性问答等任务上的准确率,还揭示了数据清洗对抑制模型幻觉的关键作用,为后续研究如Self-Instruct和LIMA等提供了重要的数据基础与对比基准。
衍生相关工作
该数据集衍生了一系列经典工作,其中最著名的是Stanford Alpaca模型及其训练框架,后者首次证明了使用低成本自动生成数据即可微调出性能接近GPT-3.5的指令遵循模型。随后,基于该数据集的变体如Alpaca-LoRA、Vicuna和GPT4All等,进一步探索了参数高效微调、多轮对话增强以及跨语言迁移等技术。此外,数据清洗方法论本身也催生了多个后续研究,例如针对数学推理的Math-Alpaca和针对安全性的Alpaca-Safe,这些工作共同推动了指令微调领域从数据构建到模型部署的全面进步。
以上内容由遇见数据集搜集并总结生成


