ViRL39K
收藏资源简介:
ViRL39K(读作“viral”)是一个经过精心策划的、包含38,870个可验证问答对的数据集,用于视觉语言强化学习训练。它基于新收集的问题和现有数据集构建,并经过了清洗、重构、改写和验证。ViRL39K为最先进的视觉语言推理模型VL-Rethinker提供了基础,具有高质量、可验证性、覆盖全面的话题和类别,并提供了详细的模型能力注释,指导在不同规模模型训练时选择适当的查询。
ViRL39K (pronounced "viral") is a meticulously curated dataset containing 38,870 verifiable question-answer pairs for visual-language reinforcement learning training. It is built upon newly collected questions and existing datasets, and has undergone cleaning, restructuring, rewriting, and validation. ViRL39K serves as the foundational resource for the state-of-the-art visual-language reasoning model VL-Rethinker, featuring high quality, verifiability, comprehensive coverage of topics and categories, as well as detailed model capability annotations that guide the selection of appropriate queries during model training across different scales.
ViRL39K 数据集概述
1. 数据集简介
- 名称: ViRL39K (发音为"viral")
- 数据量: 38,870个可验证的问答对
- 用途: 视觉-语言强化学习训练
- 基础数据源: 新建问题及多个现有数据集(Llava-OneVision、R1-OneVision、MM-Eureka、MM-Math、M3CoT、DeepScaleR)
- 处理过程: 经过清洗、重新格式化、重新表述和验证
- 关联模型: 为SoTA视觉语言推理模型VL-Rethinker奠定基础
2. 数据集特点
- 高质量可验证: 经过严格筛选和质量控制,移除有问题或无法通过规则验证的查询
- 主题全面: 涵盖从小学问题到STEM和社会主题的广泛领域
- 多样化推理: 包含图表、图解、表格、文档、空间关系等推理
- 能力标注: 提供细粒度的模型能力注释,指导不同规模模型的训练查询选择
3. 数据集统计
3.1 主要类别
- 覆盖8个主要类别
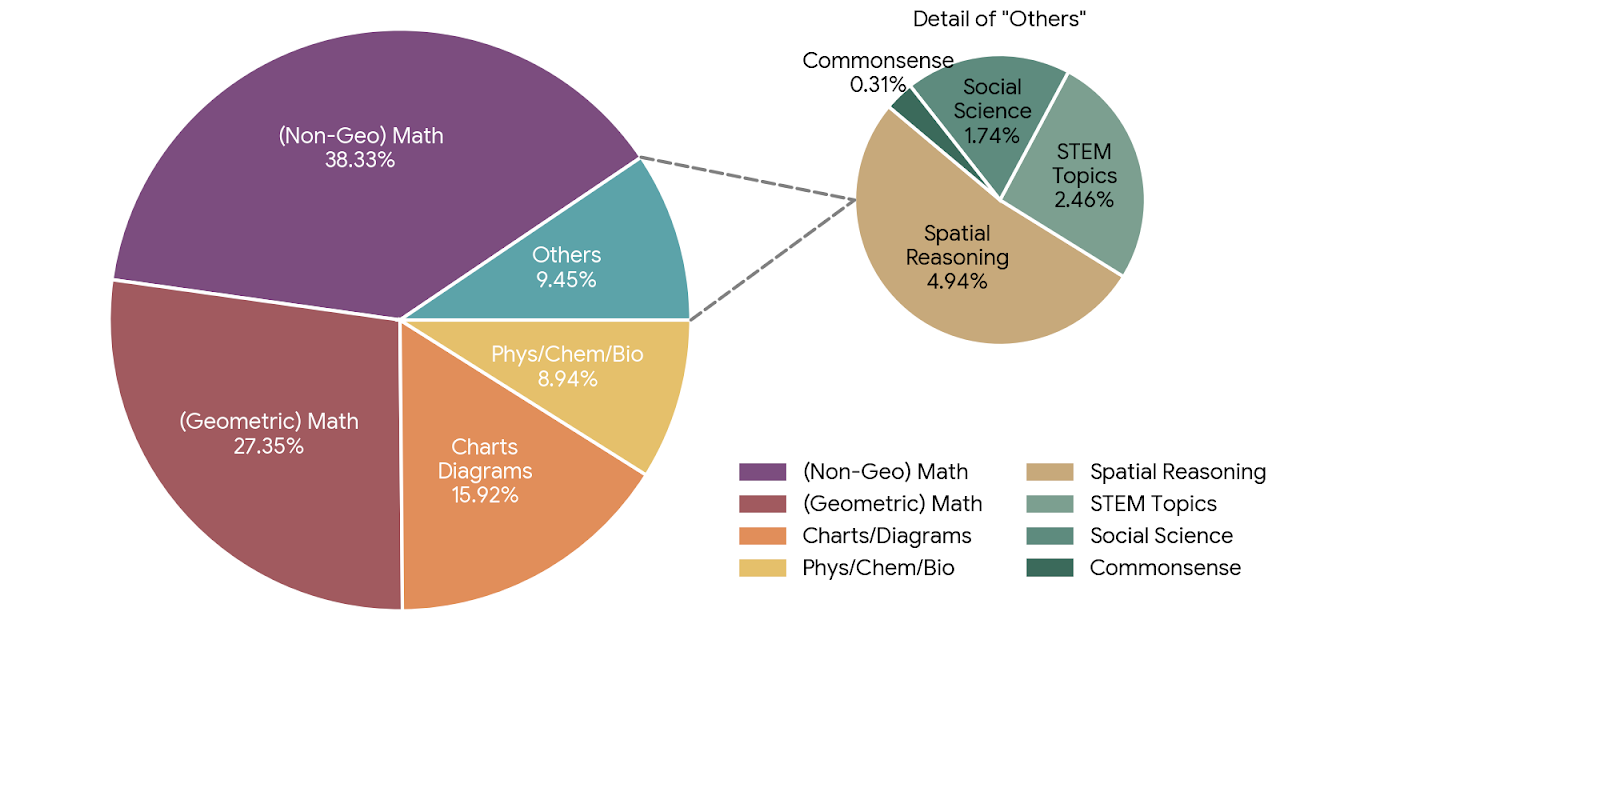
3.2 难度级别
- 针对不同规模模型提供不同难度级别

- 每个查询带有反映模型能力亲和力的PassRate标注
4. 相关资源
5. 引用信息
bibtex @article{vl-rethinker, title={VL-Rethinker: Incentivizing Self-Reflection of Vision-Language Models with Reinforcement Learning}, author = {Wang, Haozhe and Qu, Chao and Huang, Zuming and Chu, Wei and Lin,Fangzhen and Chen, Wenhu}, journal={arXiv preprint arXiv:2504.08837}, year={2025} }