遇见数据集

DCAgent3/aider_polyglot_rl__24GPU_base_lr5e_6__exp_rpt_pymethods2test_large__GLM_4_7_swe6628e7d2

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

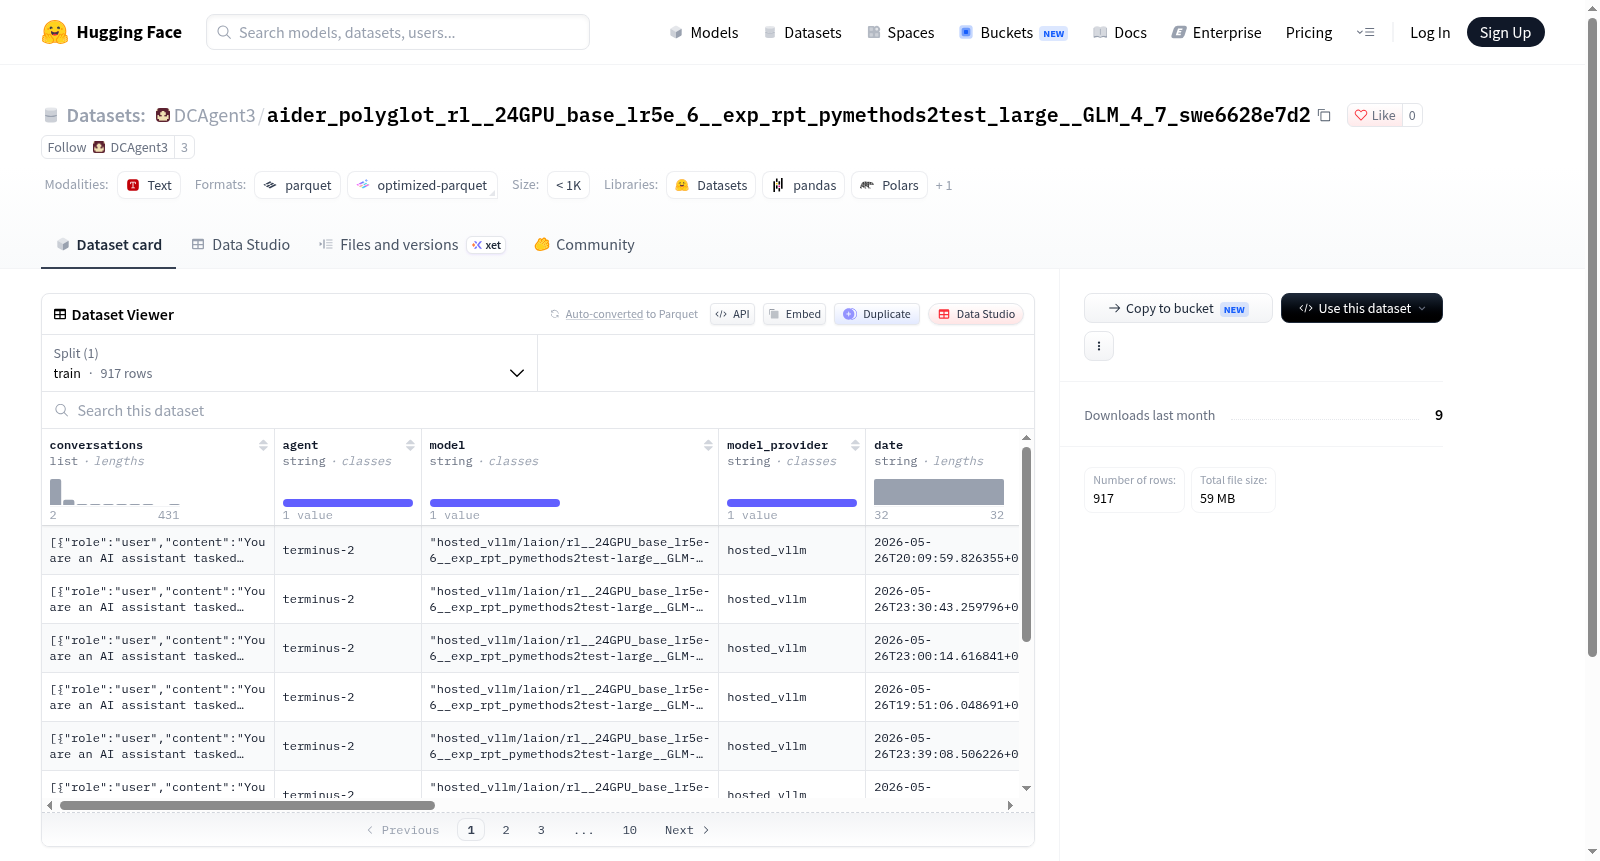
该数据集包含多轮对话记录,涉及代理(agent)、模型(model)和模型提供商(model_provider),并关联任务(task)、日期(date)、运行ID(run_id)、试验名称(trial_name)、结果(result)和验证器输出(verifier_output)等信息。数据特征包括对话内容(conversations,含角色和内容)、episode(可能表示任务片段)和trace_source(可能表示数据来源)。数据集主要用于记录和分析AI模型或代理在特定任务中的交互对话和性能评估,适用于对话系统研究、模型测试或AI行为分析。数据分割为训练集(train),包含917个示例。

This dataset contains multi-turn conversation records involving agents, models, and model providers, with associated information such as task, date, run ID, trial name, result, and verifier output. Features include conversations (with role and content), episode (possibly indicating task segments), and trace_source (possibly indicating data origin). The dataset is primarily used for recording and analyzing interactive dialogues and performance evaluations of AI models or agents in specific tasks, suitable for dialogue system research, model testing, or AI behavior analysis. The data is split into a training set (train) with 917 examples.
提供机构:
DCAgent3
搜集汇总
数据集介绍
DCAgent3/aider_polyglot_rl__24GPU_base_lr5e_6__exp_rpt_pymethods2test_large__GLM_4_7_swe6628e7d2 数据集图片
构建方式
在代码生成与强化学习交叉领域,面向多语言编程任务的智能体训练数据构建尤为关键。该数据集依托Aider Polyglot多语言编程基准,通过24块GPU的大规模分布式训练流程,对基础学习率为5e-6的强化学习策略进行系统采样。实验以Pymethods2test任务为核心,采用GLM-4-7B模型与SWE-bench 6628e7d2配置的智能体交互,将每一轮对话、验证器输出及最终结果完整记录,最终汇聚为917条训练片段。
特点
数据集以对话序列为核心载体,完整保存智能体与模型间的角色交替、内容流转以及验证器反馈,并附带智能体类型、模型标识、服务提供方、任务名称、运行标识与试验名称等元信息。其规模适中,涵盖多语言编程场景下的任务求解轨迹,既包含成功经验也保留失败信号,为分析策略行为与结果之间的关联提供了细粒度素材。
使用方法
使用者可借助Hugging Face数据集接口直接加载默认配置下的训练划分,按conversations字段解析多轮对话结构,结合result与verifier_output评估智能体表现。该数据适用于强化学习策略的离线分析、奖励建模以及多语言代码生成智能体的行为研究,亦可用于训练过程的可解释性探索与错误模式挖掘。
背景与挑战
背景概述
随着代码生成与程序理解成为人工智能研究的关键方向,多语言编程基准Aider Polyglot旨在系统评估模型跨语言代码合成与调试能力。该数据集aider_polyglot_rl__24GPU_base_lr5e_6__exp_rpt_pymethods2test_large__GLM_4_7_swe6628e7d2由GLM-4团队构建,系基于Aider Polyglot基准的强化学习训练轨迹集合,包含917条训练样本,涵盖对话历史、智能体标识、模型运行结果及验证器输出等丰富字段。其核心研究问题在于探索大规模强化学习能否提升模型在多语言编程任务上的泛化与鲁棒性。该工作为代码生成领域的基准评测提供了细粒度的过程性数据,对推动可复现的编程智能体研究具有参考意义。
当前挑战
该数据集所应对的领域问题在于多语言代码生成的准确性与一致性评估,传统基准往往侧重单一语言或静态测试,难以刻画模型在跨语言、多轮交互场景下的真实表现。构建过程中面临诸多挑战:其一,强化学习训练轨迹的采集需在24 GPU规模下保持稳定,对计算资源与同步机制要求严苛;其二,多语言任务涵盖Python等多种语言,模型需适应不同语法范式与库生态,数据标注与验证成本高昂;其三,从对话到验证器输出的全链路记录需确保时间戳、角色与结果等字段的一致性与完整性,避免噪声干扰后续分析;其四,训练与推理阶段的分布偏移可能导致过拟合,如何设计奖励信号以平衡探索与利用仍是未决难题。
常用场景
经典使用场景
在多语言代码生成与程序理解的研究中,该数据集承担着强化学习驱动的代码代理训练与评测基准的角色。其经典使用场景为:以Python方法到测试用例的转换任务(pymethods2test)为核心,借助多轮对话形式模拟代码代理与环境的交互轨迹,进而评估和优化代理在复杂编程任务中的推理与执行能力。研究人员常将其用于训练和比较不同规模的模型(如GLM系列)在代码生成、调试与验证闭环中的表现,尤其侧重于利用24块GPU进行大规模并行学习时的策略稳定性研究。
实际应用
在实际软件开发与教育场景中,该数据集支持构建智能编程助手,能够根据自然语言描述或方法签名自动生成单元测试、修复代码缺陷或补全函数实现。其蕴含的多轮对话与验证反馈机制,可被直接用于搭建自动化代码审查工具,帮助开发团队快速定位逻辑错误并生成修复建议。此外,在编程教学平台中,该数据集可用于训练自适应辅导系统,根据学习者的代码提交历史提供针对性的调试指导,从而提升编程教育的效率与交互体验。
衍生相关工作
围绕该数据集,学界与工业界衍生出一系列经典工作,主要涵盖基于强化学习的代码生成策略优化、多语言程序翻译的迁移学习,以及结合验证器反馈的迭代式代码精炼。例如,后续研究常以此为基础探索不同奖励塑形方法对代理行为的影响,或将其扩展至更广泛的软件工程任务,如缺陷定位与自动补丁生成。这些工作不仅验证了数据集在跨任务迁移中的有效性,也促进了代码大模型在真实开发流程中的落地,形成了从数据构建到算法改进再到应用部署的良性循环。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务