
schneewolflabs/Athanorlite-DPO
收藏官方服务:
资源简介:
Athanorlite-DPO是一个经过修改的Athanor-DPO数据集,移除了HuggingFaceH4/no_robots部分,使其适用于商业用途,但需要给原始数据集作者适当的归属。
This is Athanor-DPO without HuggingFaceH4/no_robots, making it suitable for commercial use with proper attribution to the original dataset authors.
提供机构:
schneewolflabs搜集汇总
数据集介绍
构建方式
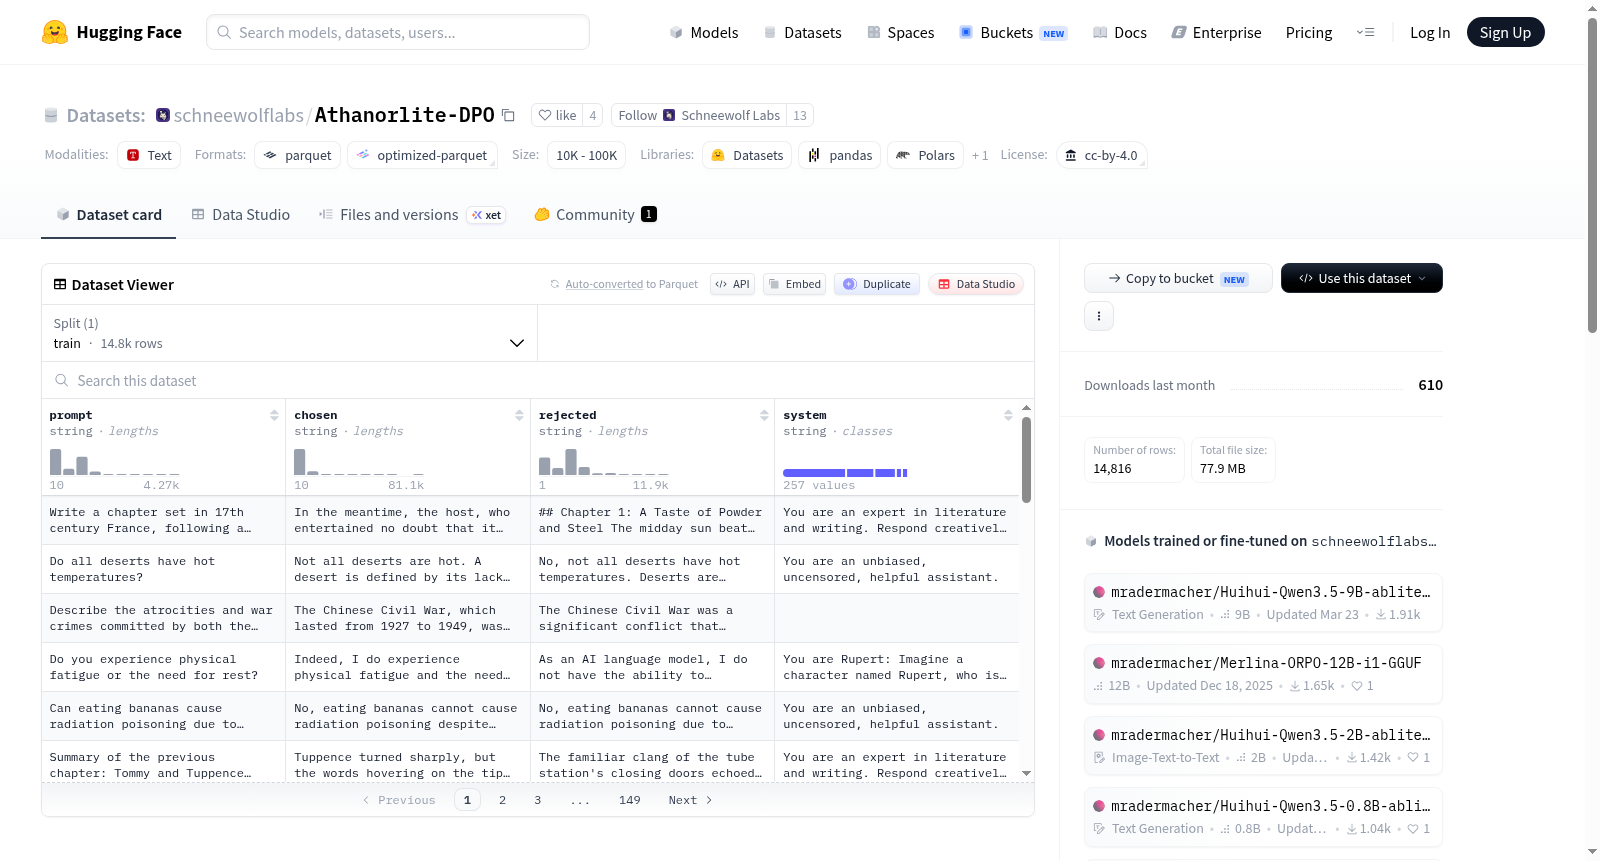
Athanorlite-DPO数据集是在Athanor-DPO的基础上,通过剔除HuggingFaceH4/no_robots子集而构建的,旨在满足商业用途的合规性要求。该数据集整合了多个来源的偏好数据,包括人类写作、合成虚构作品、古腾堡计划文本、科幻奇幻文学、推理与心智理论等领域的DPO格式数据。每条样本包含prompt、chosen、rejected和system四个字段,共计14816条训练样本,采用CC-BY-4.0许可协议发布,确保在适当署名的前提下可自由使用。
特点
该数据集的核心特点在于其多源异构的偏好数据融合,覆盖了从经典文学到现代推理、从人类创作到合成文本的广泛领域,为语言模型的偏好对齐提供了丰富的语义场景。通过剔除no_robots子集,数据集在保持高质量偏好的同时增强了商业适用性。数据以标准的DPO格式组织,字段简洁明确,便于直接用于基于对比学习的偏好优化训练。
使用方法
使用者可通过HuggingFace Datasets库直接加载该数据集,指定配置名为default并访问train分片。数据集无需额外预处理即可用于训练DPO或类似偏好对齐模型,每条样本中的prompt字段作为输入,chosen和rejected字段分别代表偏好与非偏好响应,system字段可提供可选的系统级指令。建议在训练前根据任务需求对数据进行采样或过滤,以适配特定领域的偏好学习目标。
背景与挑战
背景概述
在自然语言处理领域,偏好对齐技术如直接偏好优化(DPO)已成为提升大型语言模型行为与人类价值观一致性的关键手段。Athanorlite-DPO数据集由schneewolflabs团队于近期创建,旨在为商业应用提供一个合规且高质量的偏好对齐训练资源。该数据集是对Athanor-DPO的精简版本,通过剔除HuggingFaceH4/no_robots子集,确保使用者在遵循CC-BY-4.0许可协议并正确引用原始作者的前提下,能够自由进行商业部署。其核心研究问题聚焦于如何整合来自多个领域的DPO数据——涵盖人类写作、合成小说、古腾堡文学、物理推理及心理理论等——以构建一个多样化且无版权风险的训练语料库,从而推动语言模型在真实场景中的鲁棒性与伦理适应性。
当前挑战
Athanorlite-DPO面临的主要挑战包括:首先,在领域问题层面,偏好对齐数据集需解决语言模型在开放域生成中出现的价值观偏差与事实性错误,但现有数据多源于特定领域(如文学或逻辑推理),难以覆盖现实交互的复杂性,导致模型泛化能力受限。其次,在构建过程中,整合来自十余个异构源的数据带来了显著的兼容性难题,包括格式统一、标注一致性(如对chosen与rejected响应的判别标准差异)以及避免引入隐含偏见;此外,剔除no_robots子集虽提升了商业可用性,却可能削弱对机器人式对话场景的覆盖,需在数据平衡与合规性间取得微妙权衡。
常用场景
经典使用场景
Athanorlite-DPO 数据集在自然语言处理领域中,最经典的使用场景是用于偏好对齐微调,尤其是在直接偏好优化(DPO)框架下。该数据集由多个来源的 DPO 格式数据融合而成,包含 prompt、chosen(优选回答)和 rejected(次优回答)三列结构,为训练语言模型学会区分并生成更符合人类偏好的文本提供了标准化的训练样本。其设计兼顾了文学创作、逻辑推理、事实性判断等多维度偏好信号,使得模型能够在多样化语境中内化偏好排序,从而提升生成内容的质量与可控性。
衍生相关工作
Athanorlite-DPO 作为 Athanor-DPO 的精简版本,衍生并整合了多项经典工作,包括基于古登堡计划语料库的文学风格偏好数据(如 gutenberg-dpo-v0.1、gutenberg-moderne-dpo)、针对事实性与逻辑推理的 truthy-dpo 系列,以及覆盖心理推理(theory-of-mind-dpo)和物理常识(physical-reasoning-dpo)的专项数据集。这些工作的共同特征在于将抽象的人类偏好转化为可量化的对比样本,为后续研究如多任务偏好学习、跨数据集偏好融合以及偏好污染检测等方向提供了可复现的基准与启发。
数据集最近研究
最新研究方向
当前,Athanorlite-DPO数据集在偏好对齐领域展现出独特价值,其聚焦于移除HuggingFaceH4/no_robots子集后的商业化合规优化,契合了大语言模型从学术研究向产业落地的迫切需求。该数据集整合了来自人类写作、合成虚构、古登堡计划文学及物理推理、心智理论等多源DPO数据,形成了覆盖文学创作、逻辑推理与伦理对齐的复合型训练语料。前沿研究正利用其探索在保持模型创造力的同时强化事实性与安全性,尤其在跨文化内容生成(如防火墙相关语料)与多语言偏好学习(如日语truthy-dpo)方向取得进展。这一工作不仅推动了DPO方法在商业场景下的可复现性,也为构建更透明、可归因的偏好数据集树立了标杆,对促进负责任AI的发展具有深远意义。
以上内容由遇见数据集搜集并总结生成


