遇见数据集

Ethosoft/OpenR1TurkishReasoning

收藏
Hugging Face2026-05-26 更新2026-05-31 收录
官方服务:

资源简介:

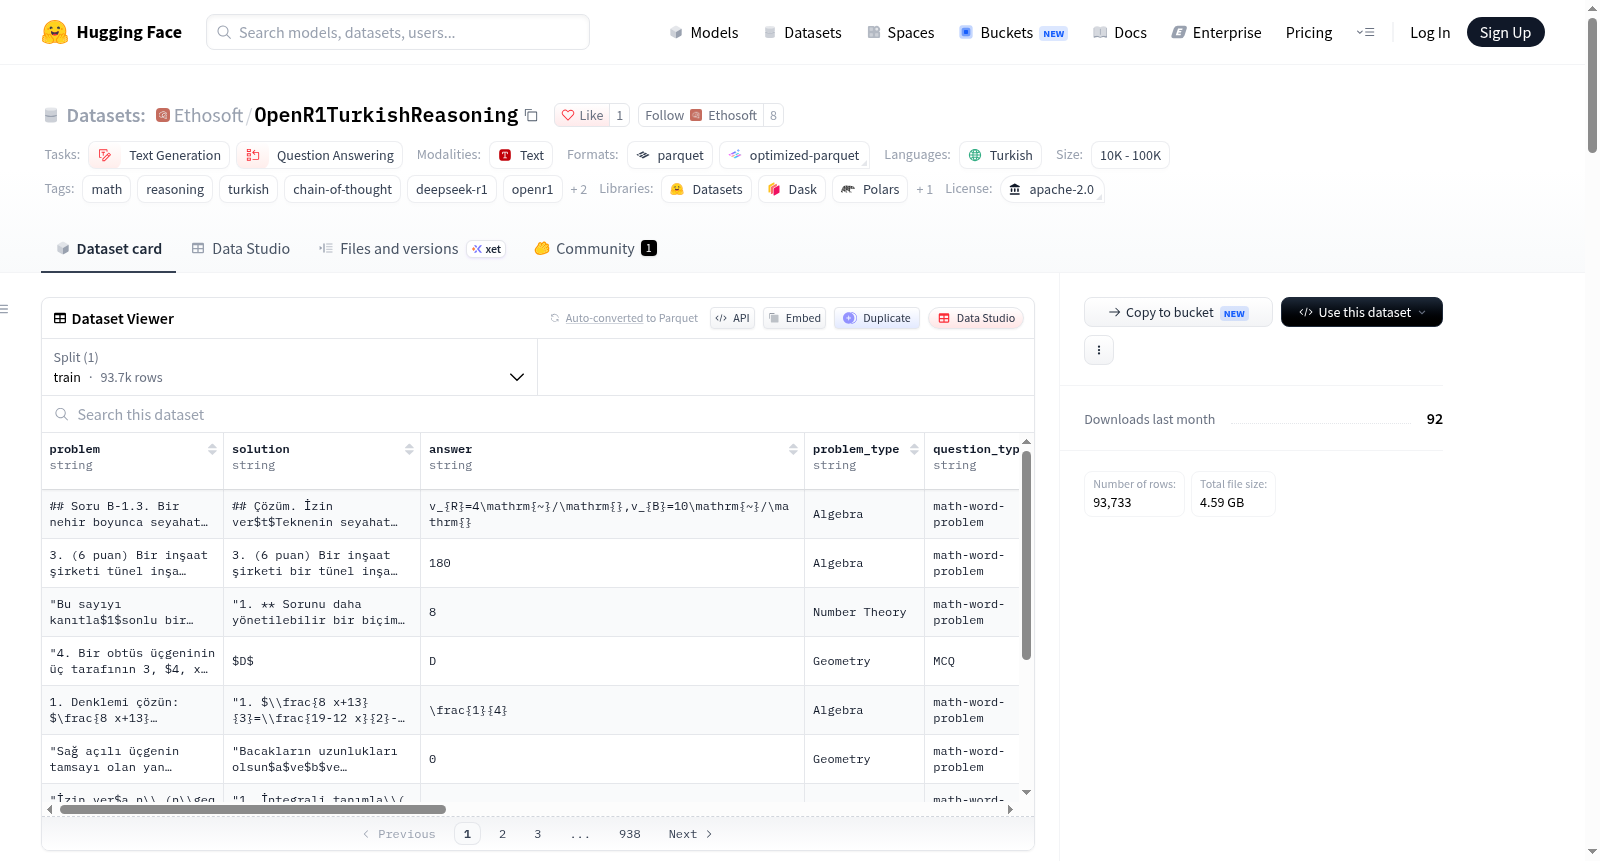
OpenR1-Math-220k Türkçe是土耳其语中第一个且最全面的数学推理数据集,包含93,733个训练样本。该数据集是open-r1/OpenR1-Math-220k数据集中default分割的训练数据的土耳其语翻译版本,填补了土耳其语数学推理领域的关键空白。数据集涵盖代数、几何、数论、微积分、组合数学、预微积分和中级代数等多个数学领域,采用链式思维推理方法。每个样本包含以下字段:问题(土耳其语)、解决方案/推理轨迹(土耳其语)、最终答案、问题类型、问题格式、原始来源、消息(适用于监督微调的聊天格式)、由DeepSeek R1生成的推理轨迹以及数学验证正确性标签。数据集旨在促进土耳其语数学大型语言模型、土耳其语STEM教育工具和多语言推理模型的开发,覆盖从奥林匹克竞赛题目、竞赛数学到教科书问题的广泛难度范围。数据集基于Apache 2.0许可证发布。

OpenR1-Math-220k Türkçe is the first and most comprehensive mathematical reasoning dataset in Turkish, containing 93,733 training examples. It is a Turkish translation of the training data from the default split of the open-r1/OpenR1-Math-220k dataset, addressing a critical gap in Turkish mathematical reasoning. The dataset covers various mathematical domains including algebra, geometry, number theory, calculus, combinatorics, precalculus, and intermediate algebra, utilizing chain-of-thought reasoning. Each example includes the following fields: problem (in Turkish), solution/reasoning trace (in Turkish), final answer, problem type, question format, original source, messages (chat-formatted for supervised fine-tuning), reasoning traces generated by DeepSeek R1, and mathematical correctness verification labels. The dataset is designed to advance the development of Turkish mathematical LLMs, Turkish STEM educational tools, and multilingual reasoning models, encompassing a wide range of difficulties from olympiad problems, competition mathematics, to textbook exercises. It is released under the Apache 2.0 license.
提供机构:
Ethosoft
搜集汇总
数据集介绍
Ethosoft/OpenR1TurkishReasoning 数据集图片
构建方式
该数据集源自英文开放数学推理资源OpenR1-Math-220k的default训练分划,涵盖了93,733条数学问题记录,每条均经过严格的翻译流程转化为土耳其语。原始数据基于NuminaMath 1.5中的40万道问题,由DeepSeek R1模型生成2至4条推理路径,并借助Math Verify与Llama-3.3-70B-Instruct进行正确性校验。翻译过程保留了问题、分步解答、最终答案及推理痕迹等核心字段,确保土耳其语版本在语义上与源数据一致,为低资源语言环境下的推理研究提供了可直接利用的平行语料。
特点
该数据集是土耳其语中首个且规模最大的数学推理语料库,专为链式思维训练设计。每条样本包含问题、分步解答、答案、问题类型、来源、UUID以及由DeepSeek R1生成的推理痕迹和数学验证标签,覆盖代数、几何、数论、微积分、组合数学等多个子领域,难度横跨竞赛数学与教材习题。messages字段以对话格式封装问题与解答,便于直接用于监督微调,同时提供正确性计数与多模型验证结果,增强了数据在推理任务中的可靠性与可解释性。
使用方法
研究者和开发者可通过Hugging Face的datasets库以单行代码加载该数据集,并直接访问训练分划中的全部字段。针对监督微调场景,可直接提取messages列,将其作为对话模板输入,其中用户角色对应土耳其语问题,助手角色对应分步解答,从而训练模型生成连贯的推理链。此外,generations与correctness_math_verify等字段可用于强化学习或拒绝采样策略,帮助筛选高质量推理路径。该数据集还支持多语言推理模型的迁移学习,为土耳其语STEM教育工具和数学问答系统提供基础资源。
背景与挑战
背景概述
近年来,大语言模型在数学推理任务中的表现日益成为衡量其认知能力的重要标尺,然而高质量、长格式且经数学验证的推理语料仍高度集中于英语世界。为弥合土耳其语与英语之间的推理资源鸿沟,Ethosoft于2026年在伊斯坦布尔发布了OpenR1TurkishReasoning数据集,该数据集以Hugging Face Open R1团队发布的OpenR1-Math-220k为蓝本,将其中93,733条训练样本完整译为土耳其语。此举不仅填补了土耳其语在链式思维数学推理领域的空白,亦为土耳其语STEM教育工具及多语言推理模型的研发奠定了数据基石,对促进低资源语言的推理能力研究具有深远影响。
当前挑战
该数据集所直面的领域问题,在于土耳其语大语言模型在复杂数学推理任务中长期受制于高质量长链思维语料的匮乏,尤其缺乏经严格数学验证的竞赛级与教材级问题求解轨迹。构建过程中的核心挑战则在于:如何在翻译中精准保留数学符号、公式结构及分步推理的逻辑严密性,避免语义漂移;如何对多源异构的原始题目进行土耳其语术语的标准化对齐;以及如何确保DeepSeek R1生成的多条推理路径在翻译后仍可通过Math Verify等工具的自动验证,从而维持与原始英文数据集同等的正确性标注水准。
常用场景
经典使用场景
在大语言模型面向数学推理能力的微调与评测实践中,该数据集最经典的使用场景是作为土耳其语监督微调(SFT)的高质量语料来源。借助messages字段中problem与solution构成的对话对,研究者可直接将其套用对话模板,训练模型习得逐步推理的链式思维;同时,problem_type与question_type的细粒度标注,亦使按代数、几何、数论等主题的分层采样与消融实验成为可能。
解决学术问题
该数据集主要回应了土耳其语长格式推理语料长期匮乏这一核心学术困境,使低资源语言下的数学推理研究不再受制于英语中心的数据格局。它为跨语言推理迁移、链式思维蒸馏以及多语言数学能力评估提供了可复现的实验基准,推动了非英语语境中推理模型训练方法学的系统检验,对语言公平性与多语言人工智能的发展具有实质意义。
衍生相关工作
该数据集由OpenR1-Math-220k的default分割翻译而来,而后者又衍生自NuminaMath 1.5中的四十万道题目,并借助DeepSeek R1生成多条推理轨迹、经Math Verify与Llama-3.3-70B-Instruct验证。围绕这一谱系,已涌现出一系列面向OpenR1的复现与扩展研究,土耳其语版本则进一步启发了其他低资源语言的翻译与推理数据构建工作。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务