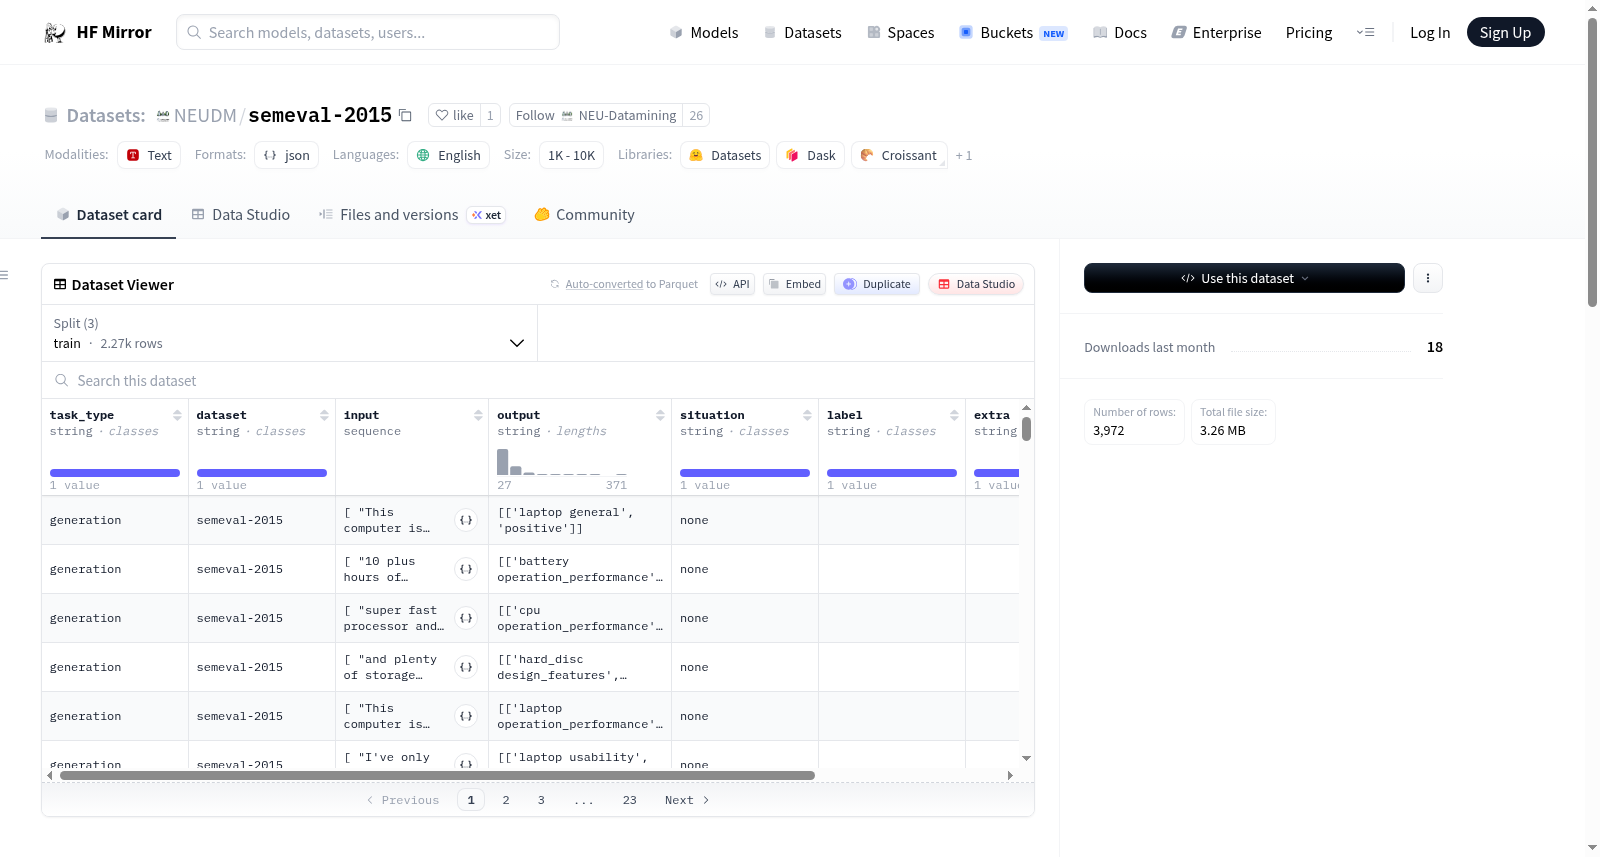
NEUDM/semeval-2015
收藏资源简介:
该数据集属于ABSA(基于方面的情感分析)领域,主要包含两个主题的数据:笔记本电脑和餐厅。笔记本电脑数据集抽取的是方面类别和情感极性的二元组,而餐厅数据集抽取的是方面术语、方面类别和情感极性的三元组。数据集被改造为生成任务,模型需要按照特定格式生成抽取结果。示例展示了如何从句子中抽取方面术语、方面类别、情感极性和观点词。原始数据集来源于SemEval-2015 Task 12,当前SOTA模型在SemEval2015-Restaurant数据集上的表现由HAABSA++模型取得,准确率为81.7。
该数据集属于ABSA(基于方面的情感分析)领域,主要包含两个主题的数据:笔记本电脑和餐厅。笔记本电脑数据集抽取的是方面类别和情感极性的二元组,而餐厅数据集抽取的是方面术语、方面类别和情感极性的三元组。数据集被改造为生成任务,模型需要按照特定格式生成抽取结果。示例展示了如何从句子中抽取方面术语、方面类别、情感极性和观点词。原始数据集来源于SemEval-2015 Task 12,当前SOTA模型在SemEval2015-Restaurant数据集上的表现由HAABSA++模型取得,准确率为81.7。
数据集概述
数据集类型
- ABSA (Aspect-Based Sentiment Analysis) 数据集
数据集内容
- 数据集包含多个子集,如
acos,semeval-2015等,每个子集针对不同的主题和抽取元素。 semeval-2015数据集进一步分为laptop和restaurant两个子主题,分别抽取不同的信息:laptop:抽取方面类别和情感极性的二元组。restaurant:抽取方面术语、方面类别和情感极性的三元组。
数据集格式
- 数据以 JSONL 格式存储,每条数据包含以下字段:
task_type: 任务类型,如 "generation"。dataset: 数据集名称。input: 输入句子。output: 抽取结果,如四元组 [方面术语, 方面类别, 情感极性, 观点词]。instruction: 任务说明,包括任务目标、输入输出格式及示例。
数据集示例
json { "task_type": "generation", "dataset": "acos", "input": ["the computer has difficulty switching between tablet and computer ."], "output": "[[computer, laptop usability, negative, difficulty]]", "instruction": "Task: Extracting aspect terms and their corresponding aspect categories, sentiment polarities, and opinion words. Input: A sentence Output: A list of 4-tuples, where each tuple contains the extracted aspect term, its aspect category, sentiment polarity, and opinion words (if any). Supplement: "Null" means that there is no occurrence in the sentence." }
数据集特点
- 每个数据集的
instruction模板相同,但内容有细微差异,部分数据集存在同一数据集不同数据instruction内容不同的情况。