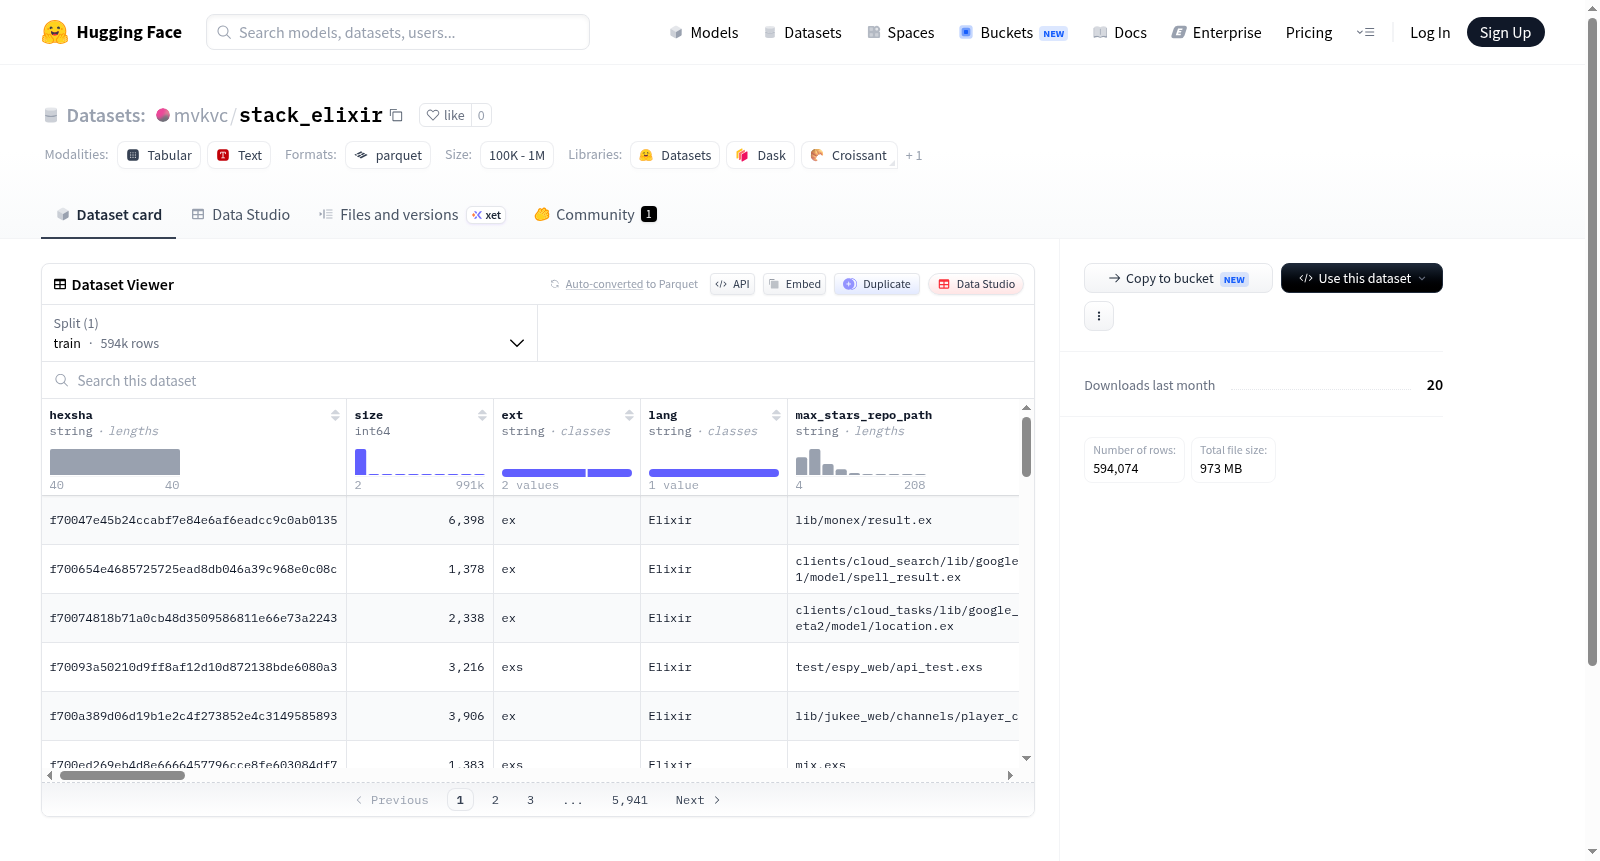
mvkvc/stack_elixir
收藏资源简介:
--- dataset_info: features: - name: hexsha dtype: string - name: size dtype: int64 - name: ext dtype: string - name: lang dtype: string - name: max_stars_repo_path dtype: string - name: max_stars_repo_name dtype: string - name: max_stars_repo_head_hexsha dtype: string - name: max_stars_repo_licenses sequence: string - name: max_stars_count dtype: int64 - name: max_stars_repo_stars_event_min_datetime dtype: string - name: max_stars_repo_stars_event_max_datetime dtype: string - name: max_issues_repo_path dtype: string - name: max_issues_repo_name dtype: string - name: max_issues_repo_head_hexsha dtype: string - name: max_issues_repo_licenses sequence: string - name: max_issues_count dtype: int64 - name: max_issues_repo_issues_event_min_datetime dtype: string - name: max_issues_repo_issues_event_max_datetime dtype: string - name: max_forks_repo_path dtype: string - name: max_forks_repo_name dtype: string - name: max_forks_repo_head_hexsha dtype: string - name: max_forks_repo_licenses sequence: string - name: max_forks_count dtype: int64 - name: max_forks_repo_forks_event_min_datetime dtype: string - name: max_forks_repo_forks_event_max_datetime dtype: string - name: content dtype: string - name: avg_line_length dtype: float64 - name: max_line_length dtype: int64 - name: alphanum_fraction dtype: float64 splits: - name: train num_bytes: 2590151574 num_examples: 594074 download_size: 973079076 dataset_size: 2590151574 configs: - config_name: default data_files: - split: train path: data/train-* --- # Dataset Card for "stack_elixir" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)
--- dataset_info: 数据集信息 features: - 字段名:提交哈希值(hexsha) 数据类型:字符串(string) - 字段名:大小(size) 数据类型:64位整型(int64) - 字段名:文件扩展名(ext) 数据类型:字符串(string) - 字段名:语言(lang) 数据类型:字符串(string) - 字段名:最高星标仓库路径(max_stars_repo_path) 数据类型:字符串(string) - 字段名:最高星标仓库名称(max_stars_repo_name) 数据类型:字符串(string) - 字段名:最高星标仓库HEAD提交哈希(max_stars_repo_head_hexsha) 数据类型:字符串(string) - 字段名:最高星标仓库许可证列表(max_stars_repo_licenses) 数据类型:字符串序列(sequence<string>) - 字段名:最高星标数量(max_stars_count) 数据类型:64位整型(int64) - 字段名:最高星标仓库星标事件最早时间戳(max_stars_repo_stars_event_min_datetime) 数据类型:字符串(string) - 字段名:最高星标仓库星标事件最晚时间戳(max_stars_repo_stars_event_max_datetime) 数据类型:字符串(string) - 字段名:最高议题数仓库路径(max_issues_repo_path) 数据类型:字符串(string) - 字段名:最高议题数仓库名称(max_issues_repo_name) 数据类型:字符串(string) - 字段名:最高议题数仓库HEAD提交哈希(max_issues_repo_head_hexsha) 数据类型:字符串(string) - 字段名:最高议题数仓库许可证列表(max_issues_repo_licenses) 数据类型:字符串序列(sequence<string>) - 字段名:最高议题数量(max_issues_count) 数据类型:64位整型(int64) - 字段名:最高议题数仓库议题事件最早时间戳(max_issues_repo_issues_event_min_datetime) 数据类型:字符串(string) - 字段名:最高议题数仓库议题事件最晚时间戳(max_issues_repo_issues_event_max_datetime) 数据类型:字符串(string) - 字段名:最高复刻数仓库路径(max_forks_repo_path) 数据类型:字符串(string) - 字段名:最高复刻数仓库名称(max_forks_repo_name) 数据类型:字符串(string) - 字段名:最高复刻数仓库HEAD提交哈希(max_forks_repo_head_hexsha) 数据类型:字符串(string) - 字段名:最高复刻数仓库许可证列表(max_forks_repo_licenses) 数据类型:字符串序列(sequence<string>) - 字段名:最高复刻数量(max_forks_count) 数据类型:64位整型(int64) - 字段名:最高复刻数仓库复刻事件最早时间戳(max_forks_repo_forks_event_min_datetime) 数据类型:字符串(string) - 字段名:最高复刻数仓库复刻事件最晚时间戳(max_forks_repo_forks_event_max_datetime) 数据类型:字符串(string) - 字段名:文件内容(content) 数据类型:字符串(string) - 字段名:平均行长度(avg_line_length) 数据类型:64位浮点型(float64) - 字段名:最大行长度(max_line_length) 数据类型:64位整型(int64) - 字段名:字母数字字符占比(alphanum_fraction) 数据类型:64位浮点型(float64) splits: 数据划分 - 划分名称:训练集(train) 字节数:2590151574 样本数量:594074 download_size: 下载大小:973079076 dataset_size: 数据集大小:2590151574 configs: 配置项 - 配置名称:默认配置(default) data_files: 数据文件 - split: 划分:训练集(train) path: 路径:数据/train-* --- # 「stack_elixir」数据集卡片 [需补充更多信息](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)
数据集概述
数据集信息
- 特征列表:
hexsha: 字符串类型size: 64位整数类型ext: 字符串类型lang: 字符串类型max_stars_repo_path: 字符串类型max_stars_repo_name: 字符串类型max_stars_repo_head_hexsha: 字符串类型max_stars_repo_licenses: 字符串序列类型max_stars_count: 64位整数类型max_stars_repo_stars_event_min_datetime: 字符串类型max_stars_repo_stars_event_max_datetime: 字符串类型max_issues_repo_path: 字符串类型max_issues_repo_name: 字符串类型max_issues_repo_head_hexsha: 字符串类型max_issues_repo_licenses: 字符串序列类型max_issues_count: 64位整数类型max_issues_repo_issues_event_min_datetime: 字符串类型max_issues_repo_issues_event_max_datetime: 字符串类型max_forks_repo_path: 字符串类型max_forks_repo_name: 字符串类型max_forks_repo_head_hexsha: 字符串类型max_forks_repo_licenses: 字符串序列类型max_forks_count: 64位整数类型max_forks_repo_forks_event_min_datetime: 字符串类型max_forks_repo_forks_event_max_datetime: 字符串类型content: 字符串类型avg_line_length: 64位浮点数类型max_line_length: 64位整数类型alphanum_fraction: 64位浮点数类型
数据分割
- 训练集:
- 字节数: 2590151574
- 样本数: 594074
数据集大小
- 下载大小: 973079076 字节
- 数据集大小: 2590151574 字节
配置
- 配置名称: default
- 数据文件:
- 分割: train
- 路径: data/train-*
- 数据文件: