
penfever/a3-rl-DCAgent_exp_rpt_e2egit-v2
收藏官方服务:
资源简介:
该数据集包含多轮对话记录和相关元数据,用于AI模型训练或评估,字段包括对话内容、角色、代理、模型、任务、结果等,共7168个训练示例。
This dataset contains multi-turn conversation records and related metadata for AI model training or evaluation, with fields including conversation content, role, agent, model, task, result, etc., totaling 7168 training examples.
提供机构:
penfever搜集汇总
数据集介绍
构建方式
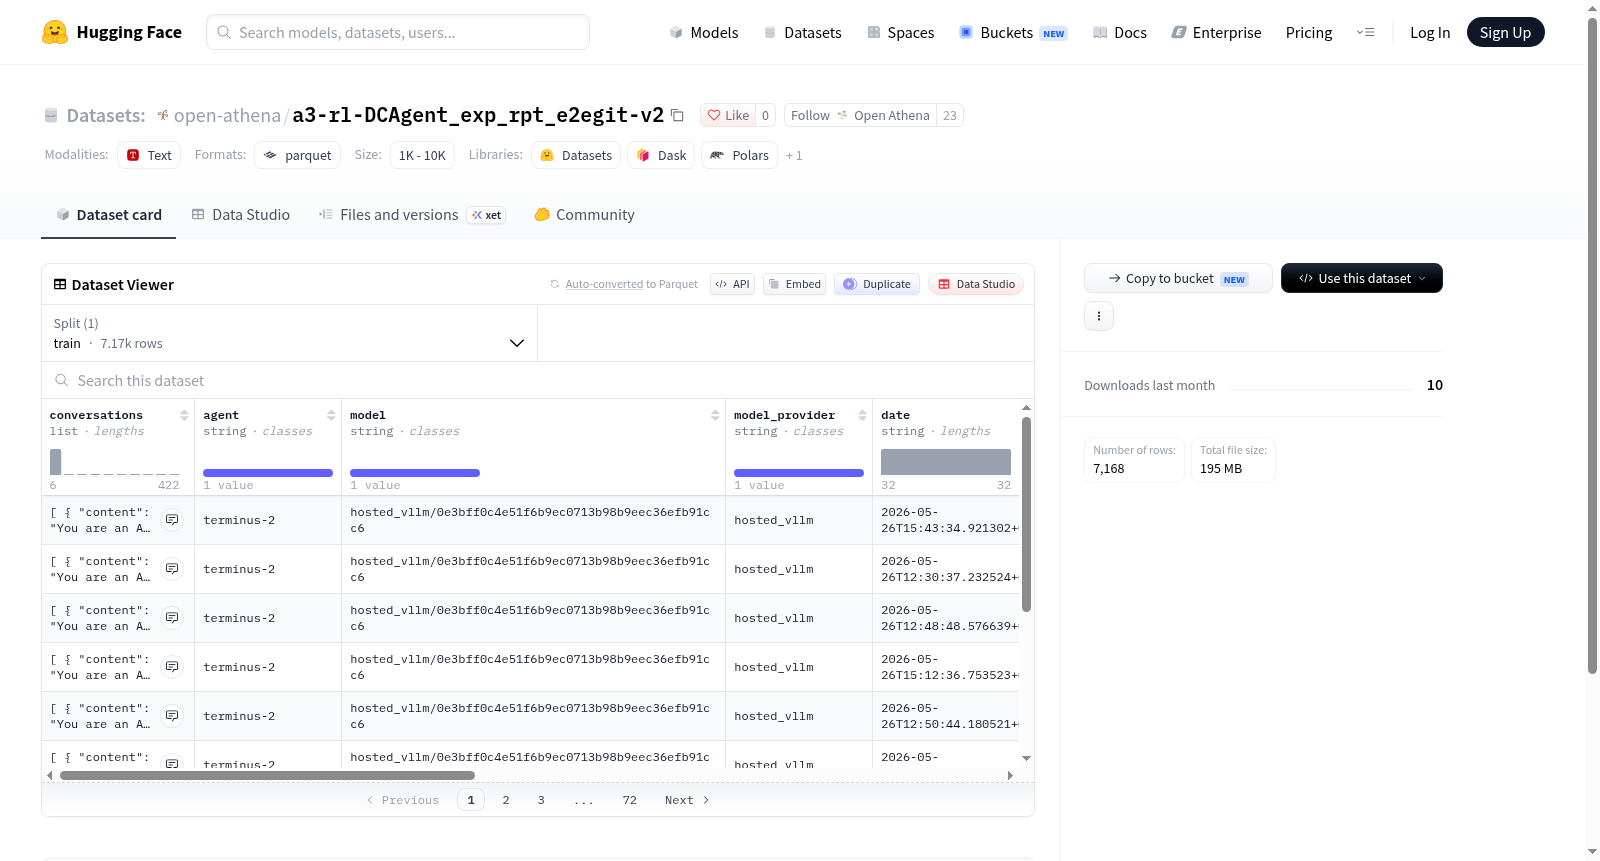
该数据集面向强化学习驱动的智能体训练场景,构建过程围绕对话轨迹与执行结果的结构化记录展开。每一轮交互以conversations字段保存对话内容与角色信息,并同步关联agent、model及model_provider等元数据,用以标识生成主体与模型来源。任务执行过程中的episode、run_id、trial_name与task字段共同构建出可追溯的实验单元,使同一任务下的多次尝试能够被精确定位。最终,result与verifier_output字段对执行结果进行记录与校验,形成从对话生成到结果验证的完整数据链条。
特点
该数据集在结构设计上兼顾对话语义信息与实验过程信息,既包含多轮对话内容,又保留智能体运行时的上下文标识。agent、model与model_provider等字段为分析不同智能体与模型组合的表现差异提供依据,date字段则赋予数据以时间维度。episode、run_id与trial_name构成层次化的实验标识体系,有助于区分同一任务的不同运行实例。result与verifier_output的并列存在,使最终结果与验证反馈能够相互对照,提升数据在评估场景中的可用性。
使用方法
该数据集以train划分提供7168条样本,采用默认配置加载后可直接用于智能体行为分析、对话策略评估或强化学习训练实验。研究者可通过conversations字段提取多轮交互内容,结合agent与model字段筛选特定智能体或模型产生的数据。利用task、episode与run_id等字段,可将样本按任务或运行批次进行分组,进而比较不同试验的result与verifier_output。该数据集亦可用于构建监督学习或奖励建模所需的状态-动作-结果样本对,服务于智能体决策能力的迭代优化。
背景与挑战
背景概述
强化学习在复杂决策任务中的进展依赖于高质量交互数据的支撑。a3-rl-DCAgent_exp_rpt_e2egit-v2数据集于2024年前后由相关研究团队构建,聚焦于基于语言模型的多轮对话代理在动态环境中的决策与执行能力评估。该数据集汇集了7168条训练样本,涵盖对话内容、代理类型、模型来源、任务描述及验证输出等多维信息,核心研究问题在于探索语言代理在端到端任务中的规划、推理与执行一致性。其结构化记录与验证机制为强化学习训练与评估提供了可复现的基准,对推动自主代理在复杂任务中的学习与优化具有参考价值。
当前挑战
该数据集所应对的领域问题在于语言代理在真实动态环境中的决策鲁棒性与泛化能力,要求代理在多轮交互中维持目标一致性并生成可验证的行动序列。构建过程中的主要挑战包括:确保多源模型与代理的对话轨迹在语义与逻辑上保持一致,设计有效的验证器输出以自动判别任务完成质量,以及平衡数据规模与任务多样性以覆盖广泛的决策场景。此外,如何在不同模型提供方之间统一数据格式与评估标准,亦构成数据集构建中的关键难题。
常用场景
经典使用场景
在智能体强化学习的研究中,a3-rl-DCAgent_exp_rpt_e2egit-v2数据集扮演着关键的角色,它通过多轮对话形式记录智能体与环境的交互轨迹,每一轮对话包含角色标注和内容文本,并辅以模型类型、任务描述、执行时间等元数据。该数据集最经典的使用场景是训练和评估基于对话的决策智能体,尤其是在需要复杂推理和多步交互的任务中,研究者利用这些真实或模拟的交互样本来优化策略,从而提升智能体在动态环境中的适应能力。
解决学术问题
该数据集有效解决了强化学习领域长期存在的交互数据稀缺与标准化评估难题。传统研究常受限于单一环境或少量样本,难以泛化,而该数据集提供了大规模、多任务、多模型的对话交互记录,且包含验证器输出和结果标签,为算法比较和可复现研究奠定了基础。其意义在于推动了对话式决策智能体的基准测试,促进了跨模型、跨任务的泛化性研究,并为离线强化学习和模仿学习提供了丰富的素材。
衍生相关工作
基于该数据集,研究者已衍生出多项经典工作,包括用于对话策略优化的离线强化学习算法、基于Transformer的序列决策模型,以及多智能体协作框架。这些工作进一步探索了从对话历史中提取状态表示、奖励建模和策略迁移的方法,并推动了相关基准测试和竞赛的开展,如对话决策挑战赛,从而丰富了强化学习与自然语言处理交叉领域的研究生态。
以上内容由遇见数据集搜集并总结生成


