
open-source-metrics/pip
收藏官方服务:
资源简介:
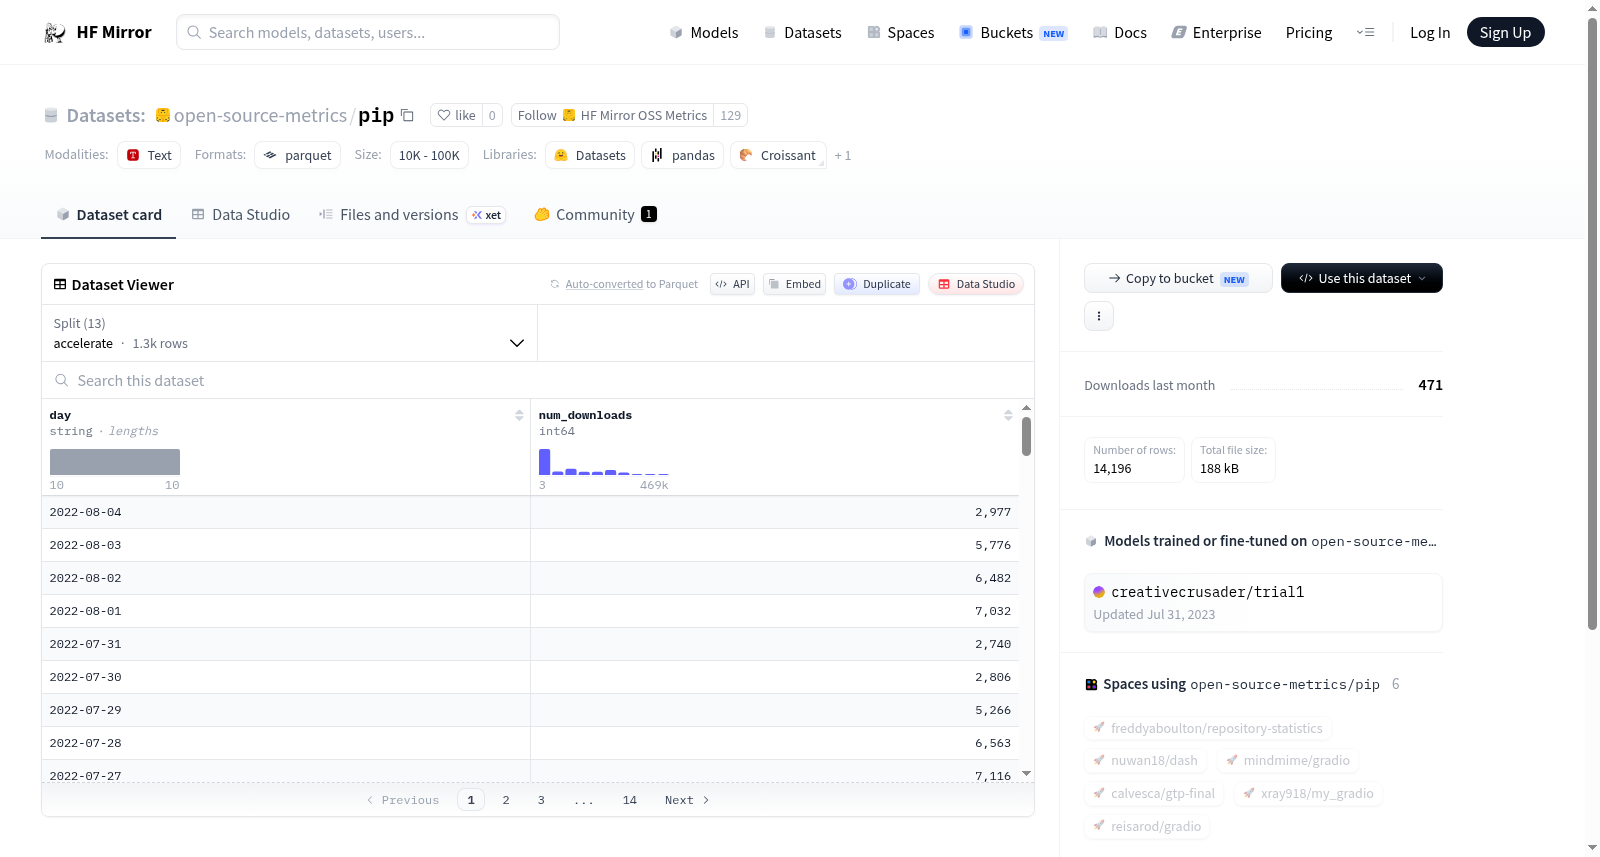
该数据集记录了不同HuggingFace库的下载情况,包括下载日期(day)和下载次数(num_downloads)。数据集被分割为多个部分,每个部分对应一个特定的HuggingFace库,如accelerate、datasets、diffusers等。每个分割部分包含一定数量的字节和示例。
This dataset records the download statistics of various HuggingFace libraries, including the download date (day) and the number of downloads (num_downloads). The dataset is divided into multiple splits, each corresponding to a specific HuggingFace library, such as accelerate, datasets, diffusers, etc. Each split contains a certain number of bytes and examples.
提供机构:
open-source-metrics原始信息汇总
数据集概述
数据集特征
- day: 数据类型为字符串(string)。
- num_downloads: 数据类型为整数(int64)。
数据集分割
- accelerate: 包含1197个示例,总字节数为26334。
- datasets: 包含1197个示例,总字节数为26334。
- diffusers: 包含714个示例,总字节数为15708。
- evaluate: 包含832个示例,总字节数为18304。
- gradio: 包含1350个示例,总字节数为29700。
- huggingface_hub: 包含1237个示例,总字节数为27214。
- optimum: 包含969个示例,总字节数为21318。
- peft: 包含480个示例,总字节数为10560。
- pytorch_image_models: 包含1350个示例,总字节数为29700。
- safetensors: 包含535个示例,总字节数为11770。
- tokenizers: 包含1350个示例,总字节数为29700。
- transformers: 包含1381个示例,总字节数为30382。
- sentence_transformers: 包含213个示例,总字节数为4686。
数据集大小
- 下载大小: 163911字节。
- 数据集大小: 281710字节。
配置文件
- config_name: default
- data_files:
- 每个分割对应的数据文件路径,如
data/accelerate-*至data/sentence_transformers-*。
- 每个分割对应的数据文件路径,如
搜集汇总
数据集介绍
背景与挑战
背景概述
该数据集是一个开源指标数据集,主要记录多个开源项目(如accelerate、transformers等)的每日下载量时间序列数据,覆盖2022年4月至8月期间。数据集规模较小,包含14,196行数据,以parquet格式存储,适用于文本分析和时间序列预测任务,已被用于模型训练和GitHub仓库统计等应用场景。
以上内容由遇见数据集搜集并总结生成


