
climba/t2i-nla-caption-50kprompt-training-data-public
收藏官方服务:
资源简介:
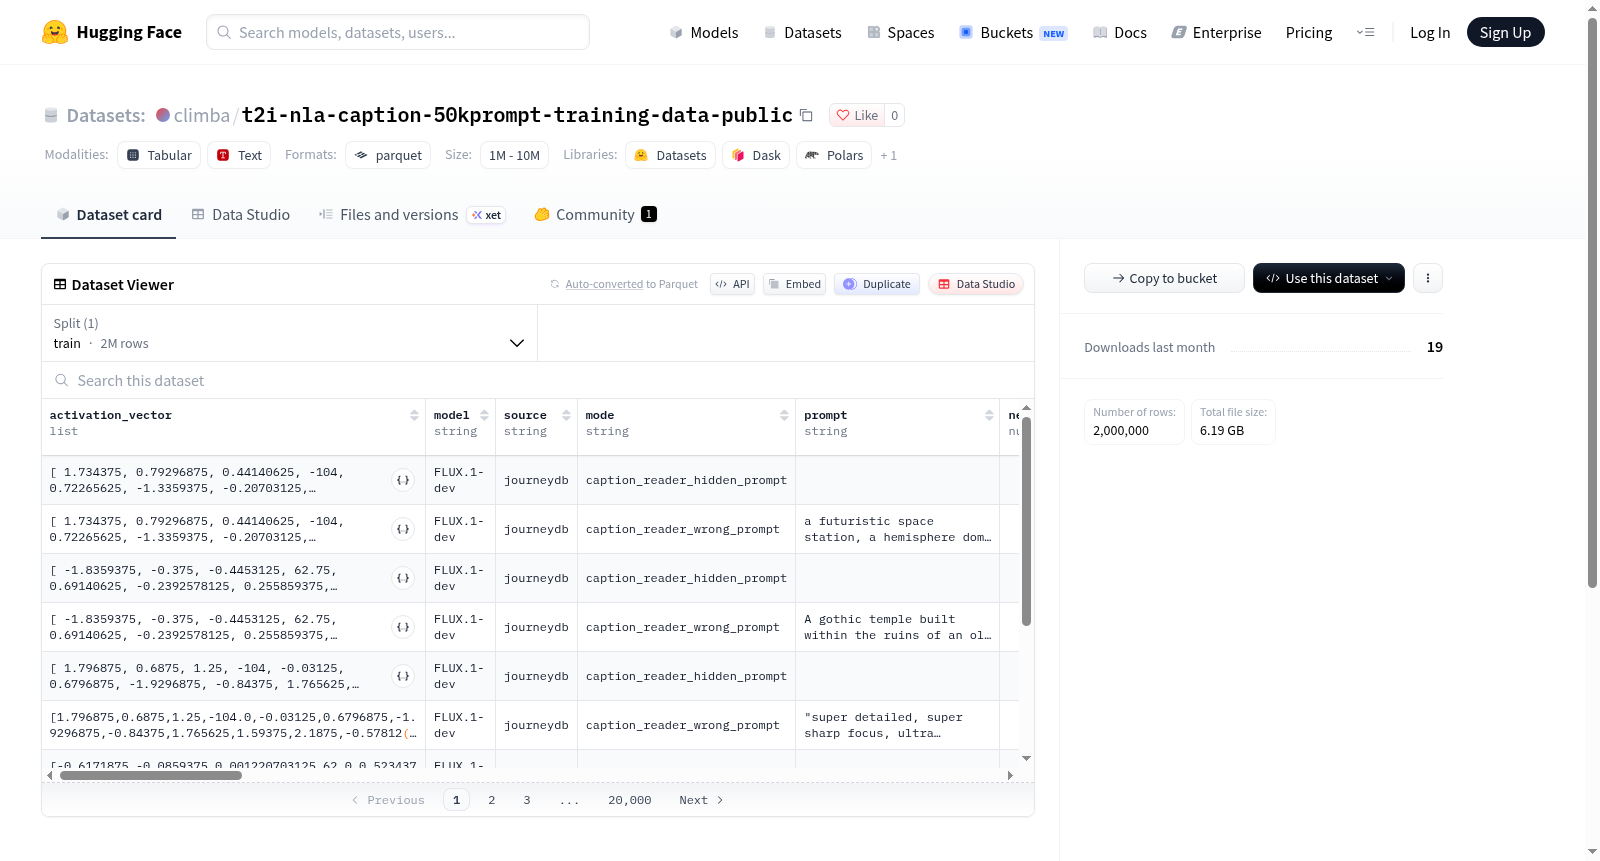
--- pretty_name: T2I-NLA Caption 50k-Prompt Training Data --- # T2I-NLA Caption 50k-Prompt Training Data Public backup of final T2I-NLA reader training data. Broader caption-data training set from the 50k-prompt caption-reader run. This repository is intended to make final-reader retraining possible after the original server is no longer available. See `manifest.json` for the original local path, size, and associated reader models.
T2I-NLA Caption 50k-Prompt Training Data is a public backup of final T2I-NLA reader training data, from the 50k-prompt caption-reader run, and is a broader caption-data training set. This repository is intended to make final-reader retraining possible after the original server is no longer available.
提供机构:
climba搜集汇总
数据集介绍
构建方式
该数据集的构建依托于大规模文本到图像生成任务中的语义对齐研究,旨在为T2I-NLA读取器提供可复现的训练资源。其核心数据来源于50k提示词驱动的标题生成运行过程,通过系统化采集与筛选,将更广泛标题训练集中的样本进行整理与固化。构建流程强调最终读取器模型的再训练需求,在原始服务器不可用后,以公共备份形式保存完整训练数据,并借助manifest.json记录原始本地路径、数据规模及关联读取器模型信息,从而保障数据溯源与重建的可行性。
特点
数据集聚焦于文本到图像生成中的标题-提示语义关联,规模设定为50k提示词级别,具有明确的领域针对性与训练完备性。其显著特征在于作为公开备份,确保在原始服务器失效后仍能支持最终读取器的重新训练,提升研究的可重复性。数据以标题-读取器训练为核心组织方式,附带清单文件详细记载路径、大小及模型关联,便于使用者理解数据来源与结构,同时保持与原始训练流程的一致性。
使用方法
使用该数据集时,研究者可依据manifest.json中提供的原始本地路径、数据集大小及关联读取器模型信息,将数据还原至相应训练环境。其典型用途为对T2I-NLA最终读取器进行再训练或微调,适用于文本到图像生成中的标题语义理解与对齐任务。加载数据后,可按照原有50k提示词标题-读取器训练流程配置模型参数,开展训练与评估,亦可基于该公共备份进行消融实验或跨模型比较,以验证读取器性能。
背景与挑战
背景概述
文本到图像生成模型的语义对齐研究催生了T2I-NLA Caption 50k-Prompt训练数据集,该数据集由相关研究团队于生成式人工智能快速演进时期构建,旨在为图像描述读取器提供大规模、高质量的训练语料。其核心研究问题在于如何借助五万条提示词所对应的描述数据,提升模型对文本与图像间细粒度语义关联的建模能力。该数据集作为公开备份,确保了原始服务器退役后读取器模型仍可复现训练,对多模态表征学习与跨模态生成任务具有基础性支撑作用,推动了可复现研究范式的发展。
当前挑战
该数据集所应对的领域问题在于文本到图像生成中语义一致性与描述忠实度的联合优化,即如何让模型从大规模提示词-描述对中习得稳定且可泛化的跨模态映射,避免模式 collapse 与语义漂移。构建过程中面临的挑战包括:五万条提示词与描述配对的质量控制与去噪,确保标注粒度能支撑细粒度读取器训练;数据规模与多样性之间的平衡,防止长尾语义被稀释;以及原始训练环境不可复现时,如何通过清单文件完整保留路径、模型关联信息以支持精确复现。这些挑战共同构成了多模态训练数据工程中的典型难题。
常用场景
经典使用场景
在文本到图像生成领域,该数据集作为关键的训练资源,经典应用于训练图像描述读取模型,即从生成的图像中逆向生成高质量文本描述。它通过提供5万条提示对应的丰富标注数据,支撑模型学习提示与图像语义之间的细粒度映射,常用于评估和优化文本到图像系统的语义一致性。
实际应用
在实际应用中,该数据集支撑了内容创作、电商图像描述自动生成、辅助视觉障碍者理解图像等场景。开发者可利用它微调读取模型,提升文本到图像工具的输出质量,并用于构建更智能的图像检索与编辑系统,促进人机交互的便捷性。
衍生相关工作
基于该数据集,后续研究衍生出多种读取模型架构与评估指标,如改进的注意力机制和对比学习框架。相关经典工作包括在文本到图像生成任务中引入读取反馈的迭代优化方法,以及跨模态预训练模型的微调策略,这些工作进一步拓展了数据集在生成与理解联合任务中的应用边界。
以上内容由遇见数据集搜集并总结生成


