turkic-nlp-corpus
收藏资源简介:
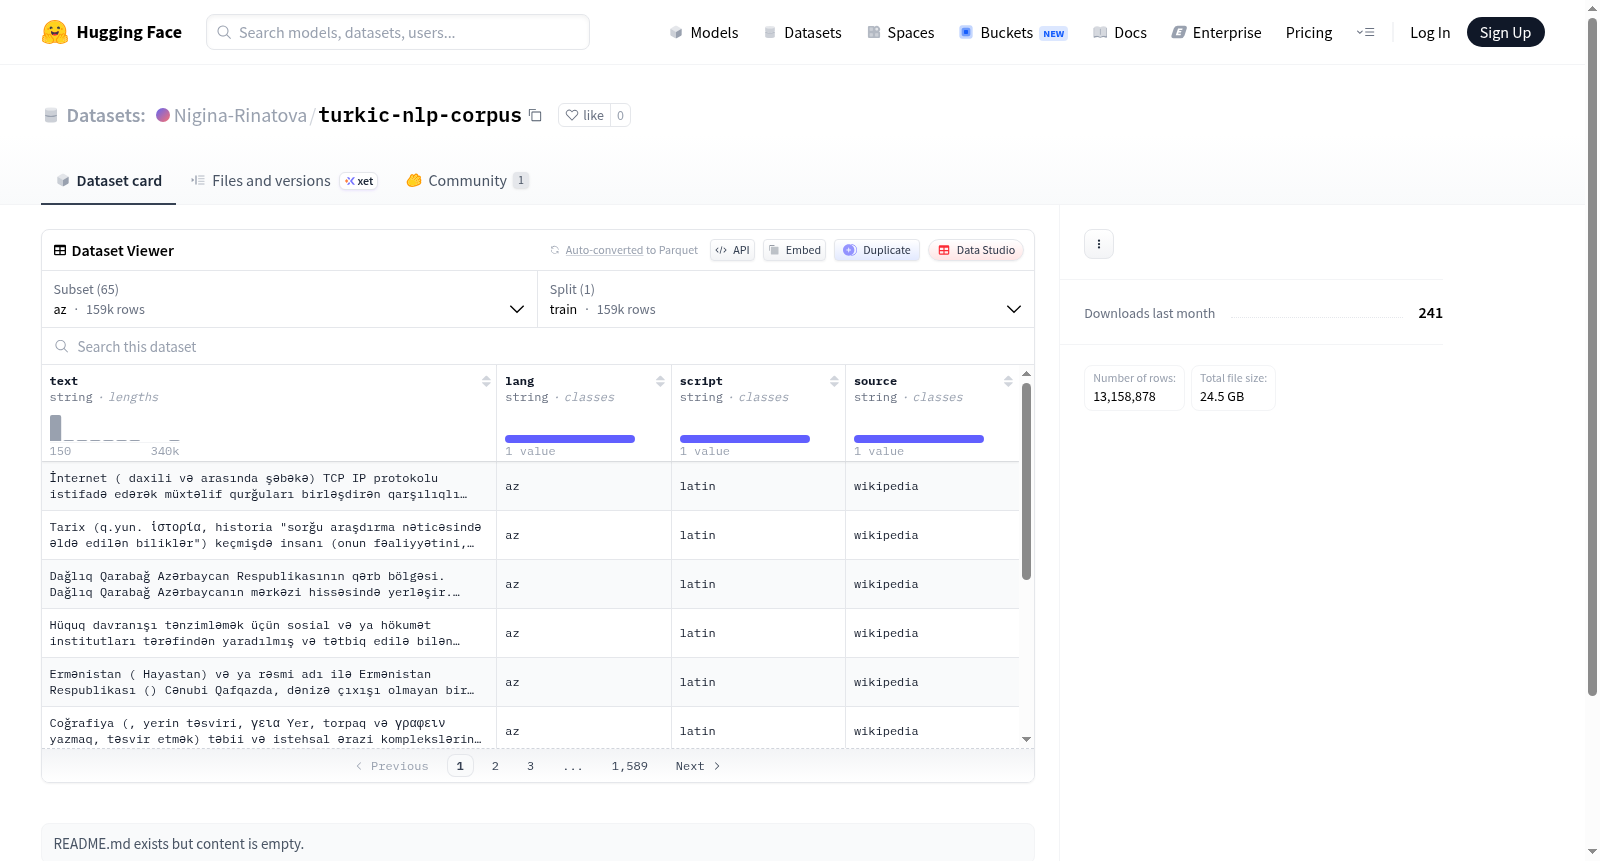
该数据集是一个多语言文本语料库,涵盖突厥语系及周边地区的多种语言,包括阿塞拜疆语(az)、巴什基尔语(ba)、哈萨克语(kk)、吉尔吉斯语(ky)、土库曼语(tk)、土耳其语(tr)、鞑靼语(tt)、维吾尔语(ug)和乌兹别克语(uz)等。每个语言配置包含四个核心特征字段:text(原始文本内容)、lang(ISO语言代码)、script(文字体系,如拉丁或西里尔字母)和source(数据来源标识)。数据集规模因语言而异,例如哈萨克语(kk)配置包含约44.7万条样本,阿塞拜疆语(az)配置约15.9万条,乌兹别克语(uz)配置约44.2万条。部分语言还提供了基于CC100多语言网络语料库的子集变体(如az_cc100系列)。该数据集适用于多语言自然语言处理任务,如语言建模、机器翻译、文本分类等,尤其适合针对突厥语系语言的模型训练与研究。
This dataset is a multilingual text corpus covering various languages of the Turkic language family and surrounding regions, including Azerbaijani (az), Bashkir (ba), Kazakh (kk), Kyrgyz (ky), Turkmen (tk), Turkish (tr), Tatar (tt), Uyghur (ug), and Uzbek (uz). Each language configuration includes four core feature fields: text (original text content), lang (ISO language code), script (writing system, such as Latin or Cyrillic script), and source (data source identifier). The dataset size varies by language; for example, the Kazakh (kk) configuration contains approximately 447,000 samples, Azerbaijani (az) about 159,000, and Uzbek (uz) about 442,000. Some languages also provide subset variants based on the CC100 multilingual web corpus (e.g., az_cc100 series). This dataset is suitable for multilingual natural language processing tasks, such as language modeling, machine translation, text classification, and is particularly well-suited for model training and research on Turkic languages.
好的,这是关于数据集 turkic-nlp-corpus 的详细总结。
数据集概述:turkic-nlp-corpus
该数据集是一个专门用于突厥语系自然语言处理的文本语料库。它汇集了多种突厥语族语言的文本数据,旨在为相关语言的 NLP 研究提供资源。
语言与语种配置
数据集包含以下语言子集,每个子集对应一个独立的配置(config):
| 配置名 | 语言 | 说明 |
|---|---|---|
az |
阿塞拜疆语 | 主要语料 |
az_cc100_* |
阿塞拜疆语 | 从 CC-100 语料库中提取的 33 个分片 |
ba |
巴什基尔语 | 主要语料 |
kk |
哈萨克语 | 主要语料 |
kk_cc100_* |
哈萨克语 | 从 CC-100 语料库中提取的 19 个分片 |
ky |
吉尔吉斯语 | 主要语料 |
ky_cc100 |
吉尔吉斯语 | 从 CC-100 语料库中提取的完整数据 |
tk |
土库曼语 | 主要语料 |
tr |
土耳其语 | 主要语料 |
tr_cc100 |
土耳其语 | 从 CC-100 语料库中提取的样本 |
tt |
鞑靼语 | 主要语料 |
ug |
维吾尔语 | 主要语料 |
ug_cc100 |
维吾尔语 | 从 CC-100 语料库中提取的完整数据 |
uz |
乌兹别克语 | 主要语料 |
uz_cc100 |
乌兹别克语 | 从 CC-100 语料库中提取的完整数据 |
数据格式与特征
所有配置的数据结构完全一致,每条数据包含以下四个字段:
text: 文本内容(字符串类型)。lang: 语言标签(字符串类型)。script: 文字系统标签(字符串类型)。source: 数据来源标签(字符串类型)。
数据规模
数据集仅包含 train(训练)分割。各主要语言配置的规模概览如下:
- 阿塞拜疆语 (az): 共 158,878 个样本,数据集大小约 386 MB。
- 哈萨克语 (kk): 共 446,770 个样本,数据集大小约 683 MB。
- 吉尔吉斯语 (ky): 共 76,171 个样本,数据集大小约 144 MB。
- 土耳其语 (tr): 共 382,390 个样本,数据集大小约 862 MB。
- 鞑靼语 (tt): 共 907,902 个样本,数据集大小约 868 MB。
- 乌兹别克语 (uz): 共 442,444 个样本,数据集大小约 950 MB。
其他配置(如 tk 土库曼语、ug 维吾尔语等)的样本量相对较小。来自 CC-100 语料库的配置规模各异,其中 ky_cc100(吉尔吉斯语)、uz_cc100(乌兹别克语)和部分哈萨克语/阿塞拜疆语分片数据量较大。