遇见数据集

coastalcph/pararel_patterns

收藏
Hugging Face2024-02-12 更新2024-03-04 收录
官方服务:

资源简介:

--- dataset_info: features: - name: relation dtype: string - name: query dtype: string - name: subject dtype: string - name: object dtype: string - name: template dtype: string - name: template_index dtype: int64 - name: candidates sequence: string splits: - name: train num_bytes: 293951032 num_examples: 157656 download_size: 8219151 dataset_size: 293951032 configs: - config_name: default data_files: - split: train path: data/train-* ---

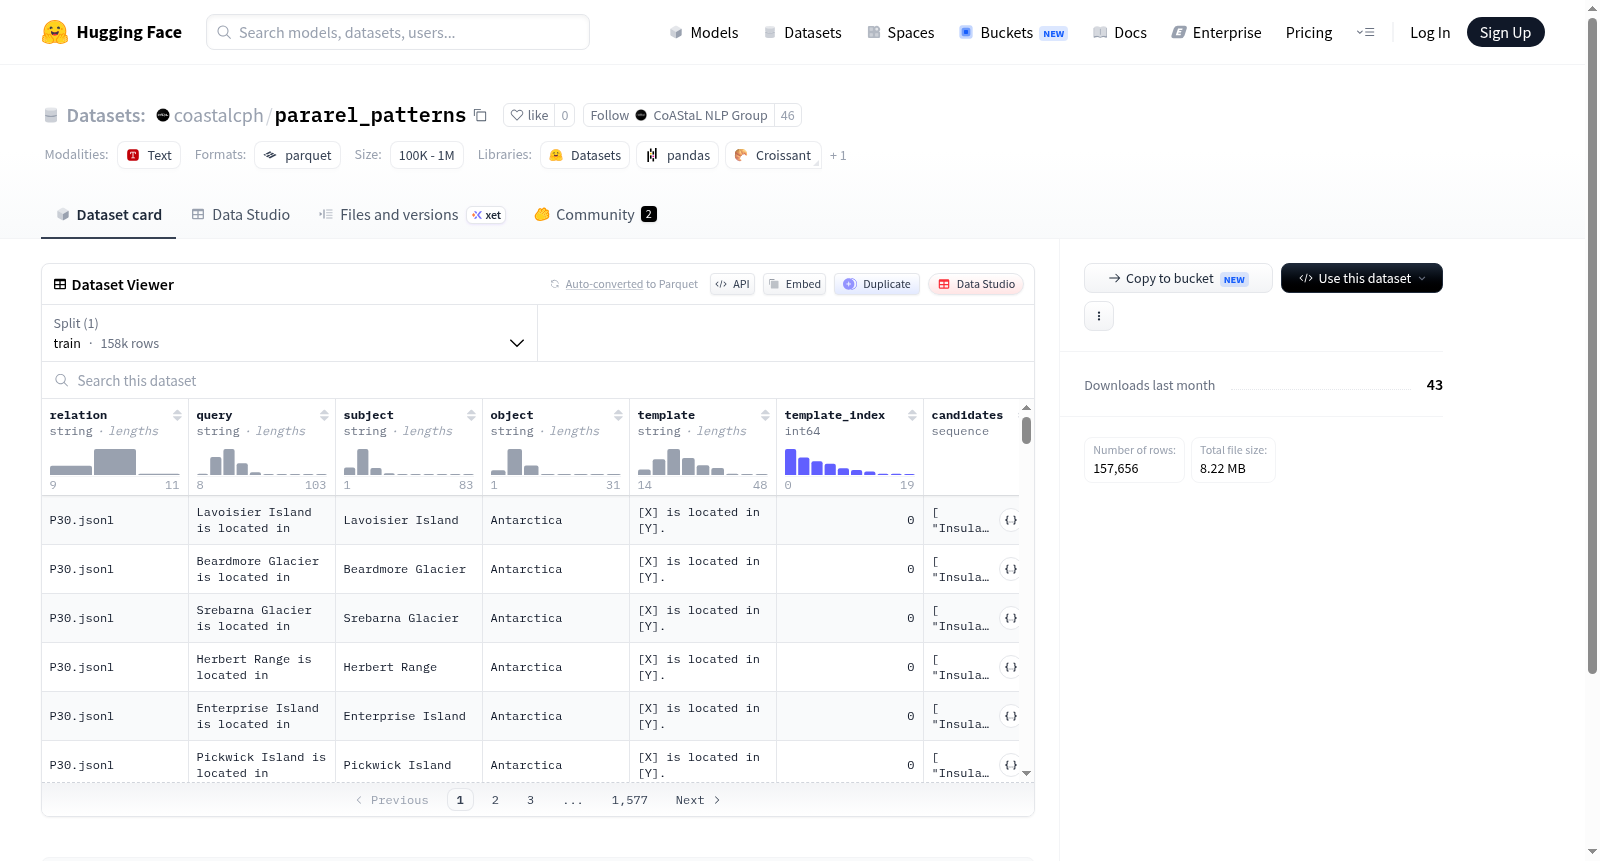
数据集信息(dataset_info): 特征字段(features): - 字段名称:关系(relation),数据类型:字符串 - 字段名称:查询(query),数据类型:字符串 - 字段名称:主体(subject),数据类型:字符串 - 字段名称:客体(object),数据类型:字符串 - 字段名称:模板(template),数据类型:字符串 - 字段名称:模板索引(template_index),数据类型:64位整数 - 字段名称:候选集(candidates),数据类型:字符串序列 数据集划分(splits): - 划分名称:训练集(train),数据字节占用量:293951032,样本总数:157656 下载总大小:8219151 数据集存储总大小:293951032 配置项(configs): - 配置名称:默认配置(default),数据文件配置: - 对应训练集(train)划分,数据文件路径:data/train-*

提供机构:
coastalcph
原始信息汇总

数据集概述

数据集特征

  • relation: 数据类型为字符串。
  • query: 数据类型为字符串。
  • subject: 数据类型为字符串。
  • object: 数据类型为字符串。
  • template: 数据类型为字符串。
  • template_index: 数据类型为整数(int64)。
  • candidates: 数据类型为字符串序列。

数据集分割

  • train: 包含157656个样本,占用293951032字节。

数据集大小

  • 下载大小: 8219151字节。
  • 实际大小: 293951032字节。

配置信息

  • default: 包含训练数据文件,路径为data/train-*。
搜集汇总
数据集介绍
coastalcph/pararel_patterns 数据集图片
构建方式
在知识图谱与自然语言处理交叉领域中,关系抽取任务的性能高度依赖于高质量的模式模板。coastalcph/pararel_patterns数据集基于PARAREL语料库构建,通过系统化地提取与关系对应的自然语言模板,形成了结构化的模式库。每条数据包含关系类型、查询语句、主体、客体、具体模板及其索引,并附有候选实体列表。构建过程注重模板的多样性与覆盖度,确保每种关系对应多种表达方式,从而提升模型在少样本与零样本场景下的泛化能力。
特点
该数据集的核心特色在于其精细的模板化设计。每个样本不仅标注了关系与实体对,还提供了对应的自然语言模板,使得数据集兼具知识图谱的结构性与文本表达的灵活性。模板索引与候选列表的引入,为多模态学习与对抗性训练提供了丰富素材。数据集规模适中,包含约15.8万条样本,覆盖多种关系类型,适合作为关系抽取、模板学习与知识推理任务的基准资源。
使用方法
使用该数据集时,研究者可直接加载HuggingFace上的默认配置,通过'relation'、'query'等字段获取结构化信息。典型应用包括关系分类器的训练与评估,利用'template'字段生成多样化查询语句,或结合'candidates'进行候选实体排序。数据处理时,建议按模板索引分组以分析不同表达对模型性能的影响,也可将模板与实体对组合,构建自然语言推理或问答任务的输入格式。
背景与挑战
背景概述
在自然语言处理领域,知识图谱的构建与推理是支撑智能问答、语义解析等任务的核心技术之一。coastalcph/pararel_patterns数据集由哥本哈根大学自然语言处理研究团队于近年创建,旨在系统性地探索关系抽取中的模式化表达。该数据集聚焦于如何通过多样化模板捕获实体间隐含的语义关系,其核心研究问题在于:传统关系抽取方法依赖于固定模板,而真实文本中关系表达具有高度灵活性与歧义性,如何设计一种既能覆盖广泛关系类型、又能保持模板泛化能力的模式集合。这一工作对推动关系抽取从静态知识库向动态语义理解演进具有重要意义,为后续基于模式的关系推理研究奠定了数据基础。
当前挑战
当前数据集面临的核心挑战体现在两个层面。首先,在领域问题层面,关系抽取任务长期受困于模板稀疏性与语义覆盖不足的矛盾——现有模式可能遗漏低频但关键的关系表达,导致模型在长尾关系上的泛化能力受限。其次,在构建过程中,如何平衡模板的多样性(如句子结构、词汇选择)与一致性(如避免歧义或矛盾模板)成为关键难点。此外,数据集中157656个训练样本虽规模可观,但部分关系类别可能存在模板分布不均,需进一步评估不同关系下模板的语义等价性,以提升数据集在跨领域迁移场景中的鲁棒性。
常用场景
经典使用场景
在自然语言处理领域,coastalcph/pararel_patterns数据集为关系抽取与知识图谱补全研究提供了标准化的模板集合。该数据集围绕特定关系类型,精心设计了多种自然语言表达模式,使得模型能够从非结构化的文本中精准识别并提取出实体间的语义关联。研究者常利用这些模式对预训练语言模型进行知识探测或微调,以评估其编码事实知识的能力。通过将关系映射为多样化的查询模板,该数据集成为检验模型在零样本或少样本场景下关系推理性能的经典基准,推动了常识知识获取与语言理解融合的学术探索。
解决学术问题
该数据集的核心价值在于解决了预训练语言模型中事实知识存储与检索的可解释性难题。传统方法难以量化模型究竟掌握了多少结构化知识,而PARAREL Patterns通过提供关系对应的多种自然语言模板,使得研究者能够系统性地探测模型对特定事实的编码一致性。它帮助学术界厘清了语言模型是否真正理解语义关系,抑或仅仅依赖表面词汇模式进行预测。这一发现对理解神经网络的泛化边界至关重要,并为后续的模型编辑、知识修正以及对抗性攻击防御研究奠定了方法论基础,深刻影响了知识增强型语言模型的设计范式。
衍生相关工作
该数据集衍生了一系列重要研究工作,其中最经典的是基于模板的关系探测方法,它催生了如LAMA(Language Model Analysis)等知识探针工具的改进版本。后续工作如Knowledge Neurons和Calibrated Factuality进一步利用PARAREL Patterns定位模型中存储特定事实的神经元区域,并分析其激活模式。此外,数据集也被用于训练关系分类器,例如在TREX和Google RE基准上微调的模型,显著提升了跨句子关系抽取的性能。这些衍生工作共同构建了从知识评估到模型解释再到知识修正的研究链条,成为当前可解释人工智能领域不可或缺的组成部分。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务