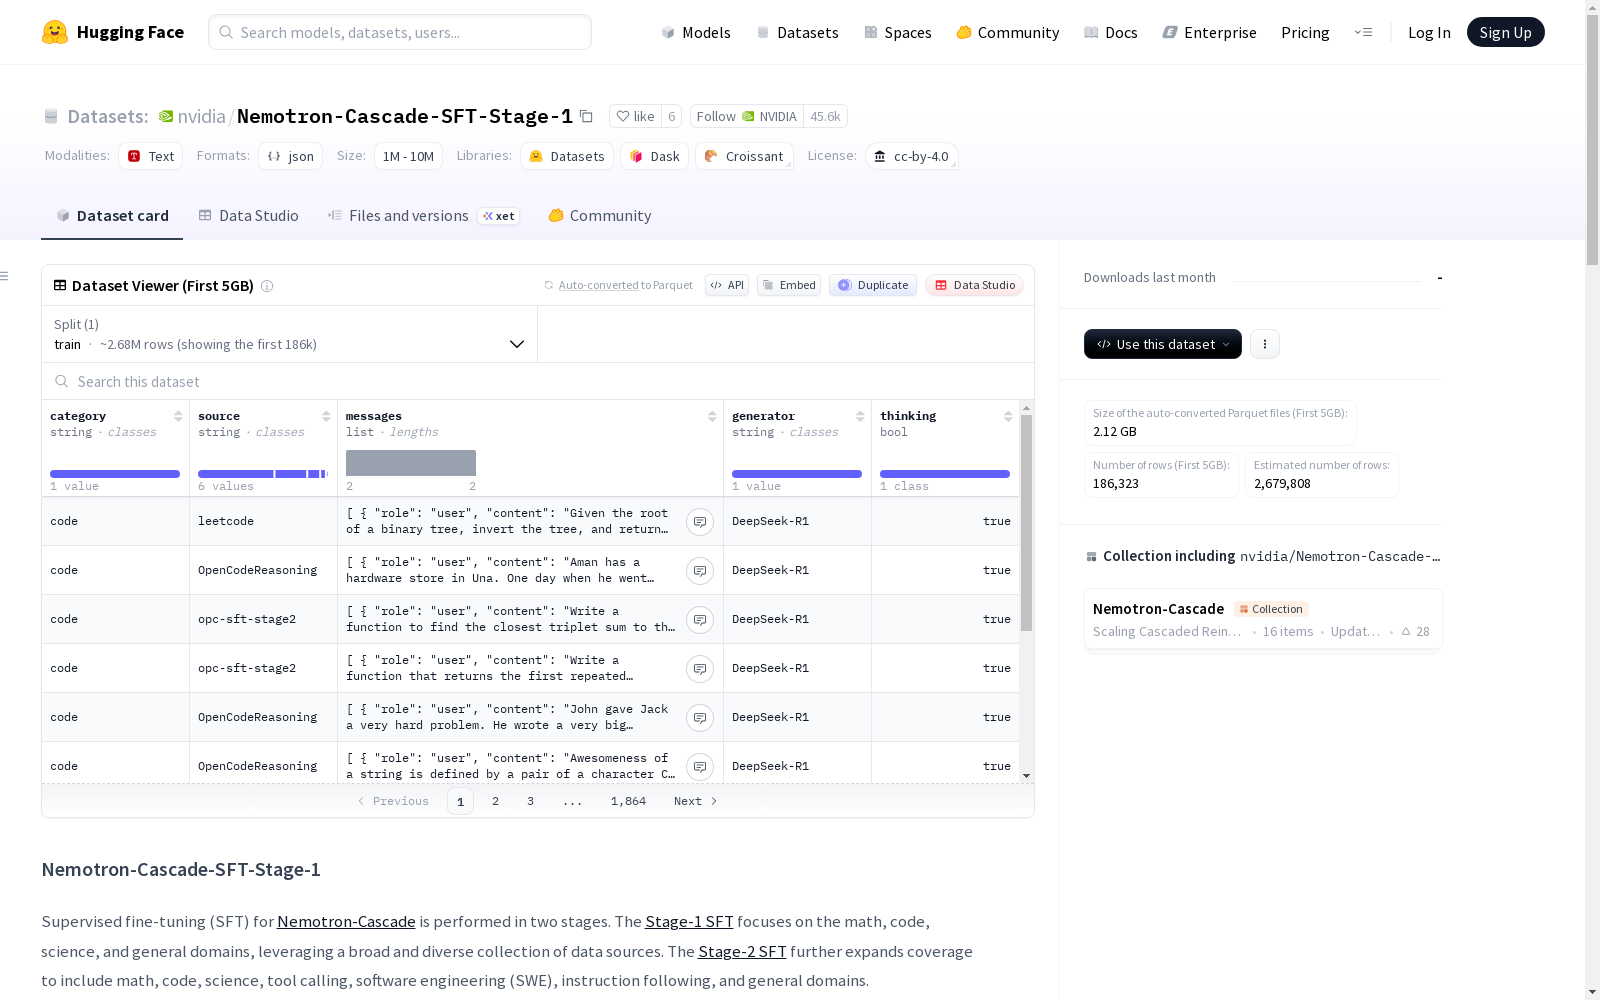
Nemotron-Cascade-SFT-Stage-1
收藏资源简介:
Nemotron-Cascade-SFT-Stage-1数据集是用于Nemotron-Cascade模型有监督微调(SFT)的第一阶段数据集,主要涵盖数学、代码、科学和通用领域。数据集利用了多种数据源,包括OpenMathReasoning、NuminaMath-CoT、OpenCodeReasoning、MagicoderEvolInstruct等。所有回答均由DeepSeek-R1生成,并包含明确的推理过程。数据集还提供了详细的统计信息,展示了各领域的问题数量和样本数量。
Nemotron-Cascade-SFT-Stage-1 数据集概述
数据集简介
本数据集是用于NVIDIA Nemotron-Cascade模型的两阶段监督微调(SFT)中的第一阶段数据集。该阶段主要聚焦于数学、代码、科学和通用领域,利用了广泛且多样化的数据源集合。所有回答均由DeepSeek-R1生成,并包含显式的推理(思考)过程。
领域与数据来源
数学领域
- OpenMathReasoning: 包含270,534个问题,2,147,570个样本。
- NuminaMath-CoT: 包含78,880个问题,521,171个样本。
代码领域
- OpenCodeReasoning: 包含35,374个问题,763,495个样本。
- MagicoderEvolInstruct: 包含27,625个问题,27,625个样本。
- opc-sft-stage2: 包含79,938个问题,323,163个样本。
- leetcode: 包含5,571个问题,126,878个样本。
- TACO: 包含16,726个问题,56,694个样本。
- apps: 包含159个问题,3,736个样本。
科学领域
- s1k: 包含826个问题,1,904个样本。
- synthetic: 包含3,653个问题,80,046个样本。
- Nemotron-Post-Training-Dataset-v1-stem: 包含62,903个问题,213,232个样本。
通用领域
- mmlu auxiliary train: 包含94,039个问题,103,973个样本。
- SlimOrca: 包含294,412个问题,294,412个样本。
- UltraInteract: 包含28,916个问题,28,916个样本。
- GPTeacher: 包含17,192个问题,17,192个样本。
- ShareGPT_Vicuna_unfiltered: 包含133,658个问题,140,870个样本。
- Magpie-Pro-300K-Filtered-H4: 包含269,869个问题,532,884个样本。
- Nemotron-Post-Training-Dataset-v1: 包含44,073个问题,52,857个样本。
许可信息
本数据集采用知识共享署名 4.0 国际许可协议(CC BY 4.0)进行许可。许可协议全文可在 https://creativecommons.org/licenses/by/4.0/legalcode 获取。
发布日期
2025年12月15日
引用格式
@article{Nemotron_Cascade_Scaling_Cascaded_Reinforcement_Learning, title={Nemotron-Cascade: Scaling Cascaded Reinforcement Learning for General-Purpose Reasoning Models}, author={Wang, Boxin and Lee, Chankyu and Lee, Nayeon and Lin, Sheng-Chieh and Dai, Wenliang and Chen, Yang and Chen, Yangyi and Yang, Zhuolin and Liu, Zihan and Shoeybi, Mohammad and Catanzaro, Bryan and Ping, Wei}, year={2025} }