
CALIBRI
收藏资源简介:
CALIBRI数据集由莱茵美因应用科学大学的研究团队开发,旨在支持代码生成大语言模型(LLM)的校准研究。该数据集包含代码生成样本、对应的正确性标签以及令牌似然值,数据来源为最新生成的代码样本,有效降低了数据泄露风险。数据集通过多校准方法,针对代码复杂度、编程语言等因素进行分组校准,显著提升了模型置信度与真实正确性之间的匹配度。其核心应用领域为代码生成质量评估,通过提供细粒度的校准基准,助力提升开发者在代码审查中的效率与准确性。
The CALIBRI dataset was developed by a research team at RheinMain University of Applied Sciences to support calibration research for code-generating Large Language Models (LLMs). This dataset includes code generation samples, corresponding correctness labels, and token likelihood values. Its data is sourced from freshly generated code samples, which effectively mitigates the risk of data leakage. The dataset employs multi-calibration methodologies to conduct grouped calibration based on factors including code complexity and programming languages, significantly improving the alignment between model confidence and actual correctness. Its core application domain is code generation quality assessment. By providing fine-grained calibration benchmarks, it helps enhance the efficiency and accuracy of developers in code review.
CALIBRI 数据集概述
数据集简介
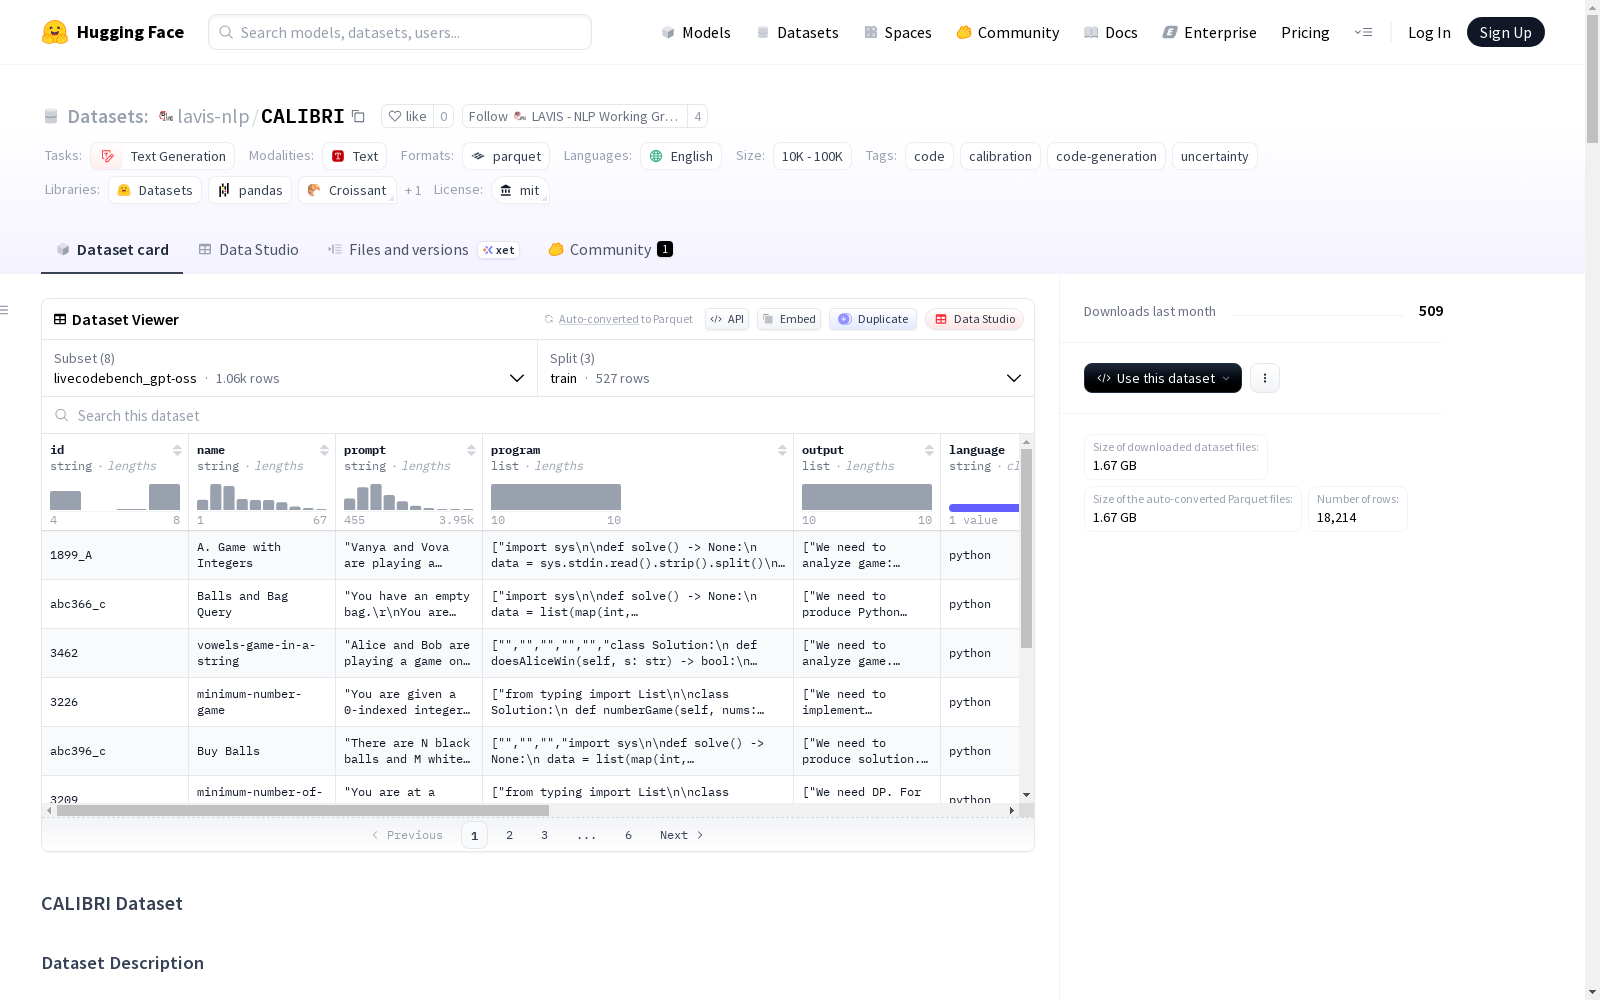
CALIBRI 是一个用于研究基于大语言模型的代码生成校准的综合数据集。它包含来自多个先进语言模型在三个成熟基准测试上的代码生成结果,并附带了用于校准分析的令牌级似然信息以及使用基准测试提供的测试套件生成的正确性标签。每个样本为每个问题提供10种不同的生成结果。
数据集详情
数据集构成
数据集包含8种配置,每种配置对应一个特定的模型与基准测试组合。所有配置均包含训练集、验证集和测试集。
配置列表
- livecodebench_gpt-oss
- 模型: GPT-OSS-20B
- 基准测试: LiveCodeBench
- livecodebench_qwen3
- 模型: Qwen3-Coder-30B-A3B-Instruct
- 基准测试: LiveCodeBench
- mceval_gpt-oss
- 模型: GPT-OSS-20B
- 基准测试: McEval
- mceval_qwen3
- 模型: Qwen3-Coder-30B-A3B-Instruct
- 基准测试: McEval
- mceval_r1-distill
- 模型: DeepSeek-R1-Distill-Qwen-32B
- 基准测试: McEval
- multipl-e_gpt-oss
- 模型: GPT-OSS-20B
- 基准测试: MultiPL-E
- multipl-e_qwen3
- 模型: Qwen3-Coder-30B-A3B-Instruct
- 基准测试: MultiPL-E
- multipl-e_r1-distill
- 模型: DeepSeek-R1-Distill-Qwen-32B
- 基准测试: MultiPL-E
数据字段说明
通用字段(所有基准测试)
id(string): 问题的唯一标识符。prompt(string): 问题描述或函数签名。language(string): 编程语言(例如 "python"、"java")。program(list[string]): 生成的代码解决方案(每个问题10个样本)。is_correct(list[bool]): 每个解决方案是否通过测试套件。token_logprobs(list[list[list[string]]]): 每个生成的令牌级对数概率,以概率/令牌对的形式存储。model(string): 生成代码的模型名称。
LiveCodeBench 特定字段
name(string): 人类可读的问题名称。code_token_idx(list[list[int]]): 起始和结束代码令牌的索引。output(list[string]): 完整的生成内容(包括推理过程)。difficulty(string): 问题难度等级。
McEval 特定字段
output(list[string]): 完整的生成内容(包括推理过程)。difficulty(string): 问题难度等级。
数据规模统计
| 配置名称 | 训练集样本数 | 验证集样本数 | 测试集样本数 | 训练集字节数 | 验证集字节数 | 测试集字节数 | 总大小(字节) |
|---|---|---|---|---|---|---|---|
| livecodebench_gpt-oss | 527 | 264 | 264 | 260,675,054 | 140,233,980 | 132,904,389 | 533,813,423 |
| livecodebench_qwen3 | 527 | 264 | 264 | 207,332,257 | 111,191,870 | 106,361,543 | 424,885,670 |
| mceval_gpt-oss | 853 | 427 | 427 | 303,551,837 | 151,085,271 | 153,387,105 | 608,024,213 |
| mceval_qwen3 | 853 | 427 | 427 | 175,036,630 | 879,055,71 | 90,385,087 | 353,327,288 |
| mceval_r1-distill | 853 | 427 | 427 | 352,895,447 | 178,075,927 | 177,882,943 | 708,854,317 |
| multipl-e_gpt-oss | 1814 | 920 | 927 | 192,412,187 | 93,260,407 | 108,359,223 | 394,031,817 |
| multipl-e_qwen3 | 1814 | 920 | 927 | 87,843,809 | 38,680,366 | 49,219,493 | 175,743,668 |
| multipl-e_r1-distill | 1814 | 920 | 927 | 190,392,589 | 92,138,706 | 103,350,099 | 385,881,394 |
注:上表“样本数”指问题数量。每个问题包含10个生成程序,因此总生成程序数为问题数的10倍。
数据集用途
- 代码生成评估
- 模型校准分析
- 不确定性量化
支持的研究方向
- 代码生成模型的多重校准技术
- 程序合成中的不确定性估计
- 跨不同架构和基准测试的模型校准
- 生成代码的置信度评分
语言
数据集包含多达40种编程语言的代码,具体取决于基准测试配置。
许可信息
本数据集基于 MIT 许可证发布。
引用信息
bibtex @misc{CALIBRI, author = {Viola Campos}, title = {CALIBRI - Replication dataset for the paper Multicalibration for LLM-based Code Generation}, year = {2025}, publisher = {Hugging Face}, howpublished = {url{https://huggingface.co/datasets/lavis-nlp/CALIBRI}} }
- 1Multicalibration for LLM-based Code Generation莱茵美因应用科学大学 · 2025年


