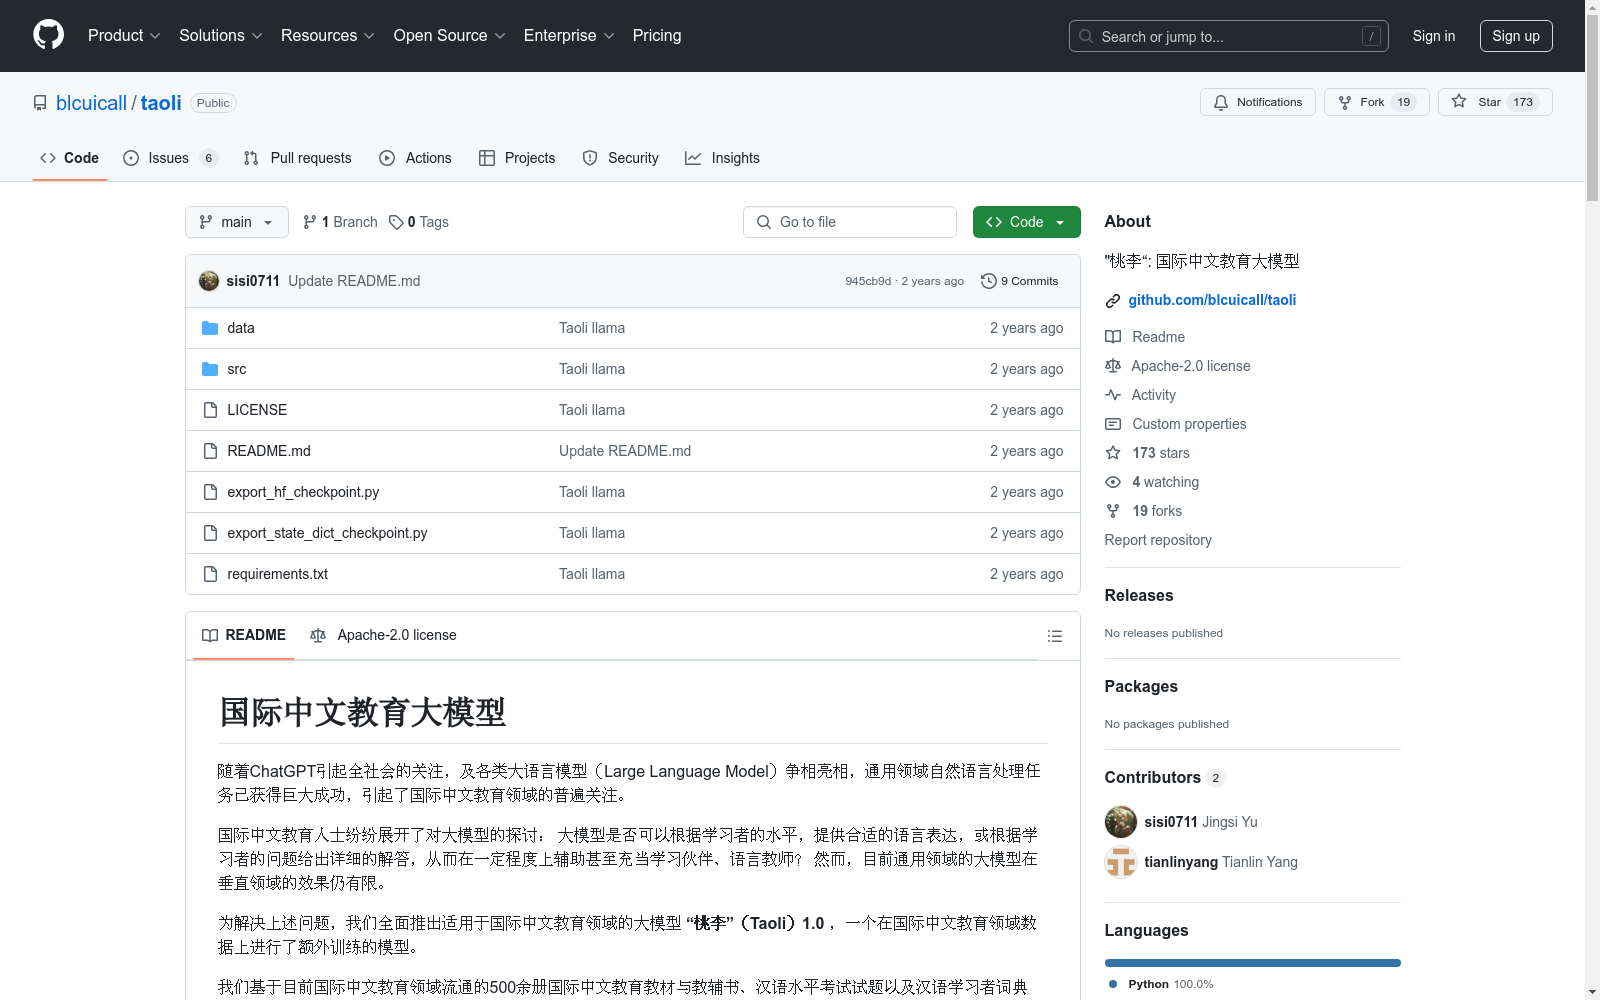
TaoLi_data
收藏资源简介:
Yu等人正在构建一个国际中文教育资源库,其中包含500多本国际中文教材、HSK考试题目、中文词典及其他资源。基于该资源库,TaoLi数据集正在被构建。指令的任务类型包括语法纠错、语义生成、文本简化和受控文本生成,总共包含88,000个实例。其中部分数据由模型生成,可能会存在错误。
Yu et al. are constructing an international Chinese educational resource library, which encompasses over 500 international Chinese textbooks, HSK examination questions, Chinese dictionaries, and other resources. Based on this resource library, the TaoLi dataset is being developed. The tasks of the dataset include grammar correction, semantic generation, text simplification, and controlled text generation, with a total of 88,000 instances. A portion of the data is generated by the model and may contain errors.
国际中文教育大模型 "桃李"(Taoli)1.0 数据集概述
数据集背景
- 针对国际中文教育领域构建的大语言模型
- 旨在解决通用大模型在垂直领域效果有限的问题
- 基于500余册国际中文教育教材、教辅书、汉语水平考试试题及学习者词典构建
数据集内容
通用指令微调数据
- Alpaca-GPT4数据:52k中文,52k英文
国际中文教育指令微调数据
语法改错数据
- 来源:YACLC开发集(最小改动/流利数据)+ HSK作文评分数据(篇章级)
- 示例:提供学习者文本的语法错误修正
释义生成数据
- 来源:现代汉语词典和对外汉语词典
- 示例:词语在特定上下文中的含义解释
文本简化数据
- 来源:Multi-Reference Chinese Text Simplification Dataset
- 规模:723条复杂结构句子(含多参考简化句)
- 示例:将专业文本简化为适合非专业读者阅读
可控文本生成数据
- 来源:汉语国际教育动态语料库(CTC)
- 示例:展示特定语法点在句子中的应用
数据规模
- 总计88,000条高质量国际中文教育问答数据
- 包含:
- 9k语法改错数据
- 4k释义生成数据
- 6k文本简化数据
- 6k可控文本生成数据
模型信息
- 基座模型:LLaMA 7B
- 当前版本:taoli-llama-7b-1.0
- 训练方式:在Chinese-LLaMA-7B基础上进行指令微调
性能表现
考试能力测试(HSK4-6级)
| 考试级别 | Taoli 1.0得分 | GPT-4得分 |
|---|---|---|
| HSK4 | 55 | 78 |
| HSK5 | 60 | 85 |
| HSK6 | 42 | 76 |
合作单位
- 北京语言大学
- 清华大学
- 东北大学
- 北京交通大学
使用限制
- 仅限学术研究用途
- 禁止商业使用
- 生成内容可能存在误差,需自行验证
引用格式
Plaintext @misc{Taoli-LLama, author={Jingsi Yu et al.}, title={Taoli Llama}, year={2023}, howpublished={url{https://github.com/blcuicall/taoli}}, }