synthetic-gsm8k-reflection-405b
收藏资源简介:
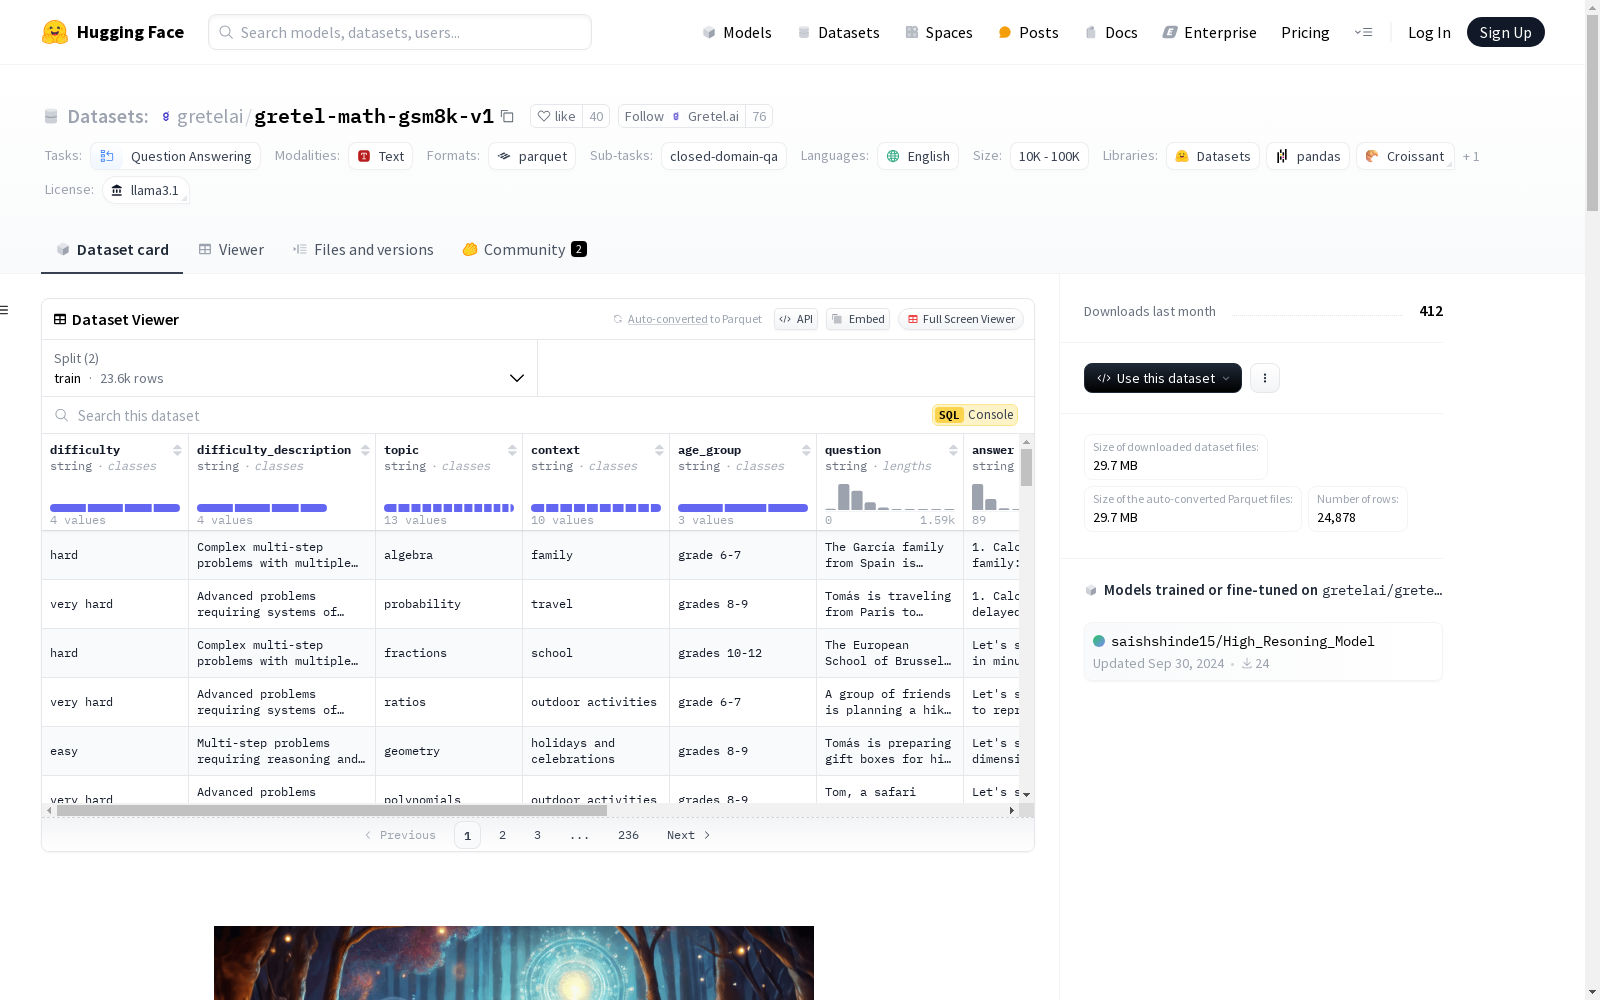
该数据集是一个基于GSM8K数据集的合成版本,使用Gretel Navigator和meta-llama/Meta-Llama-3.1-405B生成。它包含小学级别的推理任务,具有逐步的反思和解决方案,专注于多步骤推理问题。数据集具有以下特点:合成生成、综合的合成数据管道、反思提示、训练和测试集、多样化的现实世界情境、按难度分类。数据集的列包括难度、难度描述、主题、上下文、年龄组、文化、问题、答案、答案反思和答案输出。数据集的统计和分布显示了主题和难度的分布。
This dataset is a synthetic variant based on the GSM8K dataset, generated using Gretel Navigator and meta-llama/Meta-Llama-3.1-405B. It contains primary-school-level reasoning tasks with step-by-step reflections and solutions, focusing on multi-step reasoning problems. This dataset has the following characteristics: synthetic generation, a comprehensive synthetic data pipeline, reflection prompting, training and test splits, diverse real-world scenarios, and classification by difficulty level. The columns of the dataset include difficulty, difficulty description, topic, context, age group, culture, question, answer, answer reflection, and answer output. The statistics and distribution of the dataset reflect the breakdown of topics and difficulty levels.
gretelai/synthetic-gsm8k-reflection-405b
概述
- 语言: 英语
- 许可: llama3.1
- 多语言性: 单语种
- 数据集大小: 1K<n<10K
- 数据来源: 原始数据
- 任务类别: 问答
- 任务ID: 封闭领域问答
- PapersWithCode ID: gsm8k
数据集描述
- 生成方式: 使用Gretel Navigator和meta-llama/Meta-Llama-3.1-405B生成的合成数据集,灵感来自GSM8K数据集。
- 内容: 包含小学级别的推理任务,具有逐步的反思和解决方案,专注于多步推理问题。
关键特性
- 合成生成: 使用Gretel Navigator,利用反思技术生成
question和answer字段。 - 综合合成数据管道: 仅存储
answer字段的反思,捕捉逐步的思维过程。使用上下文标签确保多样性,并使用LLM作为判断来验证输出质量。所有计算均使用Python的sympy库严格验证。 - 反思提示: 包括结构化推理,使用
<thinking>、<reflection>和<output>标签捕捉AI的内部决策过程。 - 训练与测试集: 包含300个示例的测试集,按主题和难度分层。
- 多样化的现实世界情境: 涵盖广泛的主题,确保模型在反映现实世界场景的问题上进行训练。
- 按难度分类: 问题分为三个难度级别——中等、困难和非常困难,允许更细粒度的评估。
数据集列描述
difficulty: 问题的难度级别。difficulty_description: 问题的复杂性和所需推理的描述。topic: 问题的主题或学科。context: 问题设置的上下文。age_group: 问题的目标年龄或年级。culture: 问题中反映的文化背景或环境。question: 向模型提出的问题或问题。answer: 问题的最终解决方案。answer_reflection: 逐步的思维过程,包括思考和反思。answer_output: 反思问题后的最终输出。
数据集统计和分布
-
主题分布:
主题 训练集 测试集 代数 138 22 算术 181 28 复利 141 22 数据解释 154 23 指数增长/衰减 122 19 分数 143 21 几何 137 20 优化 139 21 百分比 202 31 多项式 109 16 概率 162 24 比例 166 25 比率 184 28 -
难度分布:
难度 训练集 测试集 困难 659 100 中等 737 112 非常困难 582 88
引用和使用
-
引用:
@dataset{gretelai_gsm8k_synthetic, author = {Gretel AI}, title = {Synthetically Generated Reasoning Dataset (GSM8k-inspired) with enhanced diversity using Gretel Navigator and meta-llama/Meta-Llama-3.1-405B}, year = {2024}, month = {9}, publisher = {Gretel}, howpublished = {https://huggingface.co/gretelai/synthetic-gsm8k-reflection-405b}, }