
ruMTEB
收藏官方服务:
资源简介:
ruMTEB数据集由SaluteDevices机构创建,是一个专注于俄语的文本嵌入评估基准,扩展了原有的MTEB基准。该数据集包含23个任务,覆盖了从文本分类到信息检索等多个领域。数据集的创建过程中,研究者对原始数据进行了清洗和格式化,确保了数据的质量和适用性。ruMTEB主要用于评估和改进俄语嵌入模型,特别是在多语言环境下的性能。
The ruMTEB dataset, developed by SaluteDevices, is a Russian-focused text embedding evaluation benchmark that extends the original MTEB benchmark. It consists of 23 tasks spanning diverse domains including text classification, information retrieval and more. During its construction, researchers cleaned and formatted the raw data to ensure the dataset's quality and applicability. The primary purpose of ruMTEB is to evaluate and improve Russian-language embedding models, especially their performance in multilingual environments.
提供机构:
SaluteDevices创建时间:
2024-08-22
搜集汇总
数据集介绍
构建方式
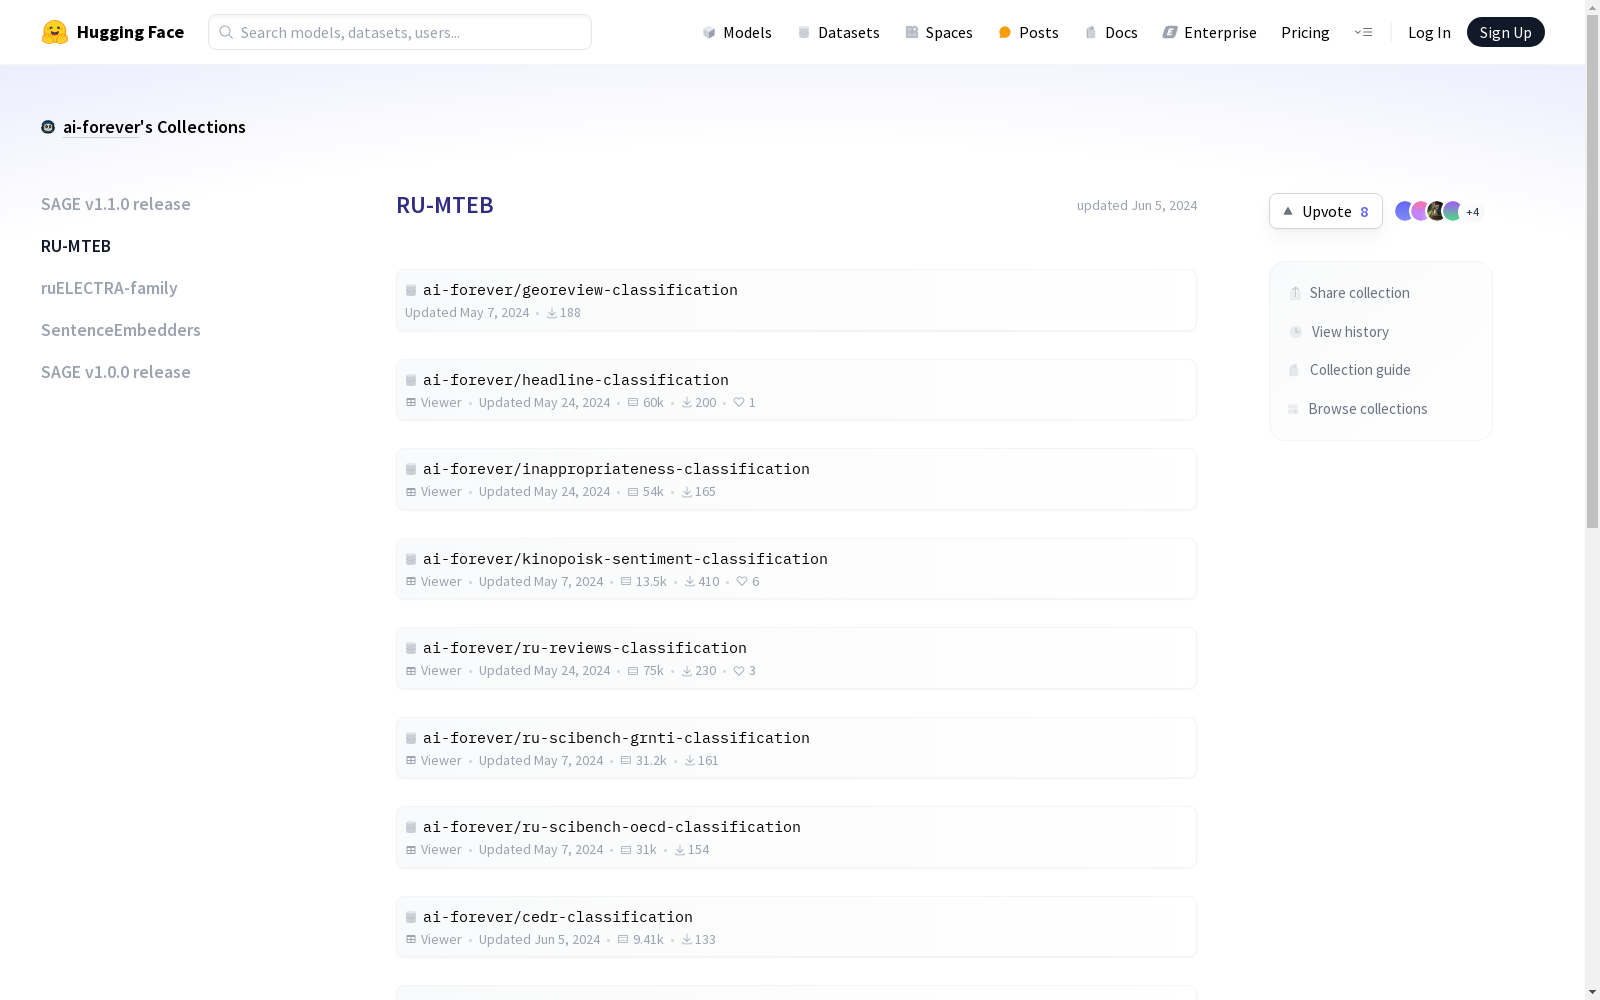
ruMTEB数据集的构建方式是针对俄语文本嵌入模型的研究,旨在提供一个全面的俄语文本嵌入评估框架。该数据集扩展了Massive Text Embedding Benchmark (MTEB),包括七种类型的任务,如语义文本相似性、文本分类、重排和检索。数据集由23个数据集组成,分为7个任务类别,包括分类、聚类、多标签分类、成对分类、重排、检索和语义文本相似性。为了构建这个数据集,研究人员使用了基于ruBERT模型的新模型ru-en-RoSBERTa,并将其与现有的俄语和双语模型进行了比较。ruMTEB框架提供了开源代码,并集成了原始框架,以及一个公共排行榜。
使用方法
使用ruMTEB数据集的方法相对简单。首先,研究人员需要下载ruMTEB框架和相关的数据集。然后,他们可以使用框架中的评估工具来评估他们的文本嵌入模型。评估过程包括将模型应用于数据集中的任务,并计算模型在每个任务上的性能指标。最后,研究人员可以将他们的模型结果与排行榜上的其他模型进行比较,以评估他们的模型的性能。此外,研究人员还可以使用ruMTEB数据集来训练和微调他们的文本嵌入模型,以提高模型的性能。
背景与挑战
背景概述
在自然语言处理(NLP)领域,文本嵌入模型在信息检索、评估语义文本相似性等任务中发挥着关键作用。然而,针对俄语语言的文本嵌入模型相对较少,且现有模型大多基于过时的训练语料库。为了解决这一问题,研究人员提出了一个新的俄语文本嵌入模型ru-en-RoSBERTa,并建立了ruMTEB基准,该基准是MTEB的俄语版本,包括语义文本相似性、文本分类、重排序和检索等七个类别的任务。ruMTEB基准旨在为俄语文本嵌入模型的评估提供一个全面的框架,并推动俄语NLP领域的发展。
当前挑战
ruMTEB基准面临着一些挑战。首先,由于训练数据主要来自互联网领域,因此可能包含英语和俄语来源的各种刻板印象和偏见。其次,模型的上下文长度限制为512,这可能会影响其在长文本上的表现。此外,由于资源限制,ru-en-RoSBERTa的训练过程中省略了对比预训练阶段,这可能会影响其在检索相关任务上的表现。最后,由于ruMTEB基准是一个协作项目,数据集的质量可能不均匀,且可能存在数据泄露的风险。
常用场景
经典使用场景
ruMTEB数据集在自然语言处理(NLP)领域扮演着关键角色,它通过创建文本嵌入,被广泛应用于信息检索和评估语义文本相似度等任务中。该数据集专注于俄语,引入了新的俄语嵌入模型ru-en-RoSBERTa,并扩展了Massive Text Embedding Benchmark(MTEB)的俄语版本ruMTEB。ruMTEB包括七个任务类别,如语义文本相似度、文本分类、重排和检索等。该数据集的发布为评估俄语文本嵌入模型提供了宝贵的资源,有助于推动俄语NLP领域的发展。
解决学术问题
ruMTEB数据集的提出解决了俄语文本嵌入模型评估资源的缺乏问题。现有的俄语模型大多基于较旧版本的ruBERT模型,且缺乏多语言的知识迁移能力。ruMTEB数据集的发布,为俄语文本嵌入模型提供了全面的评估标准,有助于推动俄语NLP领域的研究与发展。
实际应用
ruMTEB数据集在实际应用场景中具有广泛的应用前景。例如,在信息检索领域,该数据集可以帮助提高检索的准确性和效率;在文本分类领域,可以用于识别和分类文本内容;在语义文本相似度评估中,可以用于评估文本之间的相似程度。此外,ruMTEB数据集还可以用于其他NLP任务,如文本重排、检索和聚类等。
数据集最近研究
最新研究方向
ruMTEB数据集的最新研究方向集中在俄语文本嵌入模型的开发与评估上。该研究提出了ru-en-RoSBERTa模型,这是一个专注于俄语的嵌入模型,同时也支持英语,以便进行跨语言的知识迁移。此外,ruMTEB基准测试的提出填补了俄语嵌入模型评估资源的空白,它包含了23个文本嵌入任务,覆盖了分类、聚类、多标签分类、配对分类、重排序、检索和语义文本相似度等方面。通过在ruMTEB基准测试上的评估,ru-en-RoSBERTa模型展现出了与现有先进模型相媲美的性能,特别是在语义文本相似度任务上。这一研究对于俄语自然语言处理领域具有重要意义,不仅提供了新的评估工具,还为俄语文本嵌入模型的发展提供了新的思路和方法。
相关研究论文
- 1The Russian-focused embedders' exploration: ruMTEB benchmark and Russian embedding model designSaluteDevices · 2024年
以上内容由遇见数据集搜集并总结生成


