遇见数据集

AppealCase

收藏
Hugging Face2025-05-25 更新2025-05-26 收录
官方服务:

资源简介:

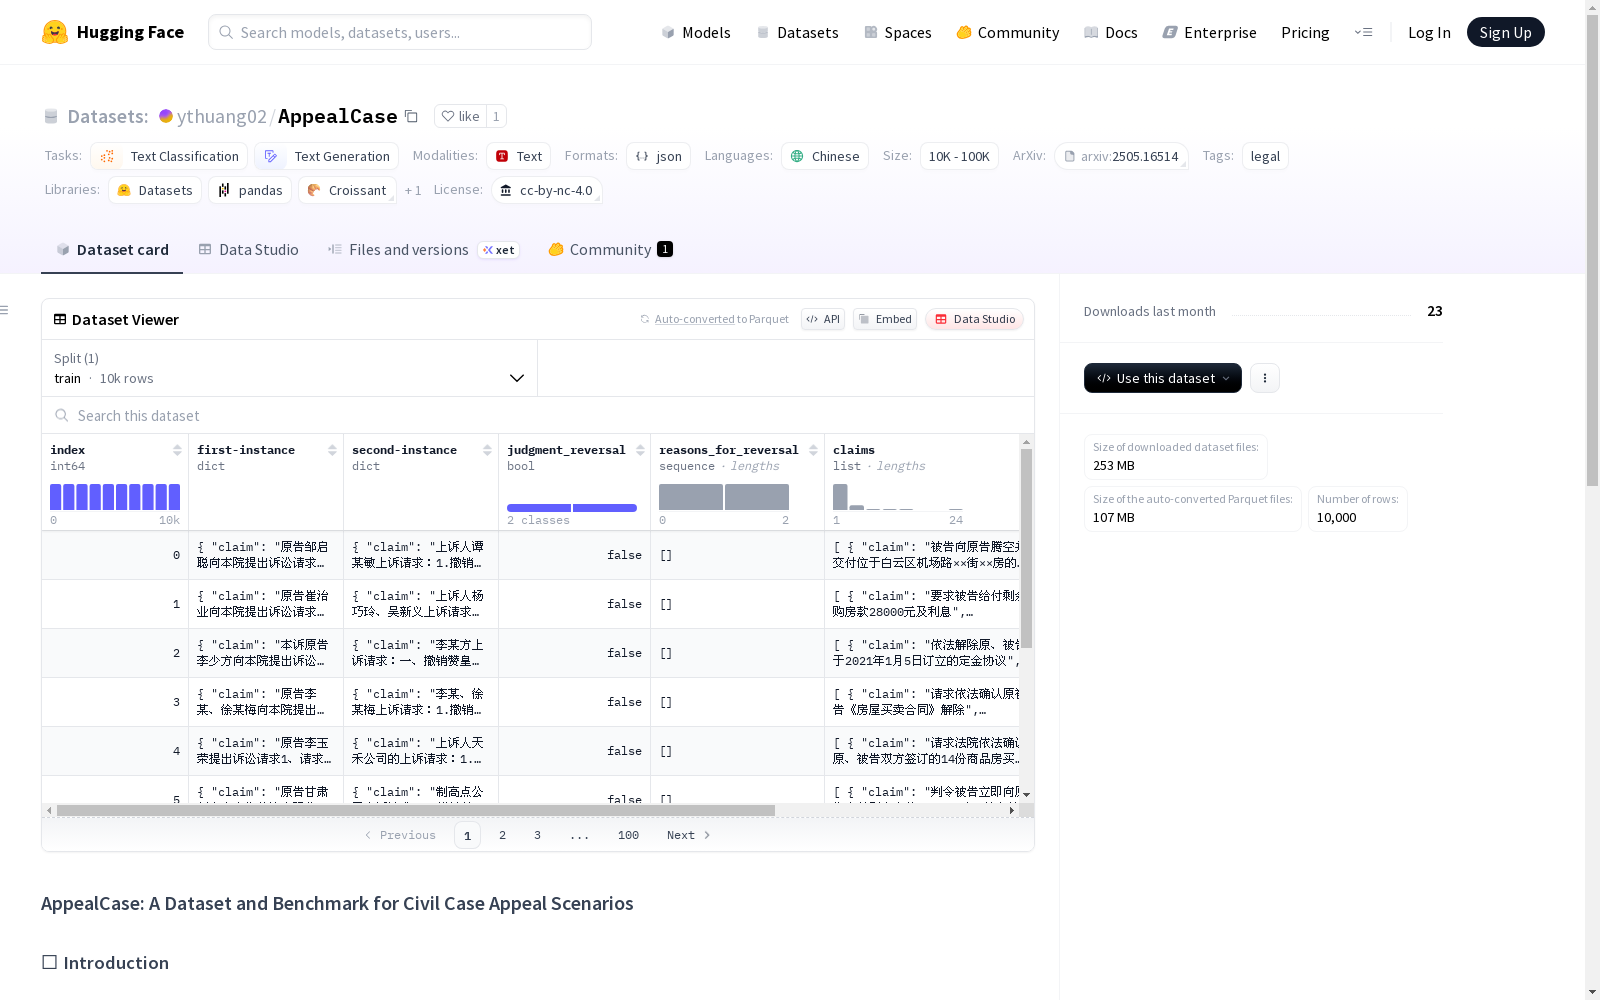
AppealCase数据集是一个大规模的资源,专为支持上诉判决场景下的法律人工智能研究而设计。该数据集包含了10,000对匹配的初审和终审民事案件,涵盖了91种不同的民事案由。数据集经过结构化标注,标注内容包括判决是否被推翻、推翻的原因、诉讼请求、法律条文以及新信息。数据集以JSON格式存储,便于加载和解析,并遵循CC BY-NC 4.0许可。

The AppealCase dataset is a large-scale resource specifically designed to support legal artificial intelligence research in the context of appellate judgments. This dataset contains 10,000 matched pairs of first-instance and final-instance civil cases, covering 91 distinct civil case causes of action. The dataset is structurally annotated, with annotations covering whether the judgment was overturned, the reasons for the overturn, litigation claims, legal provisions, and new information. The dataset is stored in JSON format for easy loading and parsing, and is licensed under CC BY-NC 4.0.

创建时间:
2025-05-23
原始信息汇总

AppealCase数据集概述

基本信息

  • 许可证: CC BY-NC 4.0
  • 任务类别: 文本分类、文本生成
  • 语言: 中文
  • 标签: 法律
  • 规模: 10K<n<100K

数据集介绍

  • 名称: AppealCase
  • 简介: 首个针对上诉判决场景设计的大规模资源,旨在支持LegalAI研究。填补了上诉程序研究的空白。
  • 数据来源: 中国裁判文书网
  • 案例数量: 10,000对匹配的一审和二审民事案件
  • 覆盖范围: 91种民事案由
  • 标注内容: 判决逆转、逆转原因、诉求、法律条款和新信息

数据结构

  • 格式: JSON结构化格式
  • 配置:
    • 默认配置:
      • 数据文件:
        • 训练集: "AppealCase/AppealCase.json"

相关资源

  • GitHub链接: https://github.com/ythuang02/AppealCase
  • 论文链接: https://arxiv.org/abs/2505.16514

引用

bibtex @article{huang2025appealcase, title={{AppealCase}: A dataset and benchmark for civil case appeal scenarios}, author={Huang, Yuting and Guo, Meitong and Wu, Yiquan and Li, Ang and Liu, Xiaozhong and Yin, Keting and Sun, Changlong and Wu, Fei and Kuang, Kun}, journal={arXiv preprint arXiv:2505.16514}, year={2025} }
搜集汇总
数据集介绍
AppealCase 数据集图片
构建方式
在司法智能研究领域,AppealCase数据集开创性地构建了面向民事上诉场景的专业资源。研究团队从中国裁判文书网系统采集了10,000组匹配的一审与二审民事案件,涵盖91种案由类型。通过设计结构化标注体系,对判决逆转情况、改判原因、诉讼请求、法律条款及新证据等要素进行了系统标注,形成标准化的JSON格式数据。这种构建方式既确保了案例的司法代表性,又为上诉程序的专项研究提供了可靠基础。
使用方法
研究者可通过标准JSON接口便捷加载数据,每个案例对包含原审与上诉审的完整文书及结构化标签。该数据集支持文本分类、法律条文生成、判决预测等多类任务,特别适合上诉结果预测、司法错误模式分析等专项研究。使用建议先通过案由分类筛选目标领域案例,再结合改判标签开展对比分析。为遵守许可协议,任何衍生应用需明确标注数据来源并限制于非商业用途。
背景与挑战
背景概述
AppealCase数据集由黄玉婷等研究人员于2025年构建,旨在填补法律人工智能领域在上诉判决场景中的研究空白。该数据集从中国裁判文书网精选了10,000对匹配的一审和二审民事案例,涵盖91种案由,并设计了结构化标注方案。作为首个专注于上诉程序的大规模法律资源,该数据集突破了传统LegalAI研究集中于初审案件的局限,为探索司法纠错机制和公平性保障提供了重要基础。其创新性的任务设计和精细标注为法律文本挖掘、判决预测等研究开辟了新方向。
当前挑战
构建AppealCase数据集面临双重挑战。在领域问题层面,上诉案件涉及复杂的法律推理过程,需准确识别判决逆转原因、新证据采纳等细微差别,这对模型的理解深度提出极高要求。在构建过程中,从非结构化裁判文书中提取匹配的案例对需要克服数据稀疏性难题,而保持91种案由的均衡分布又需精心设计采样策略。此外,法律条款的动态更新特性要求标注体系具备足够的扩展性和适应性,这对数据集的长期维护构成持续挑战。
常用场景
经典使用场景
在司法智能研究领域,AppealCase数据集为上诉判决场景提供了独特的研究视角。该数据集通过匹配一审和二审民事案件,为研究者提供了分析判决逆转模式、上诉理由分类以及法律条款适用变化的标准化平台。其结构化标注体系特别适合探索上诉程序中新证据引入对判决结果的影响机制,成为法律文本挖掘领域的基准测试集。
解决学术问题
该数据集有效解决了司法人工智能领域长期存在的上诉程序研究数据匮乏问题。通过系统标注判决逆转原因和新信息要素,使研究者能够定量分析司法纠错机制的有效性,为构建上诉结果预测模型提供了数据基础。其覆盖91种案由的设计,显著提升了法律智能系统在复杂场景下的泛化能力研究。
实际应用
在司法实务中,AppealCase支持开发上诉风险评估系统,帮助律师预测案件改判可能性。法律科技公司可基于该数据集构建智能法律助手,为当事人提供上诉策略建议。法院系统亦可利用其分析司法裁判尺度,辅助法官统一法律适用标准,特别是在消费者权益保护、劳动争议等高频上诉领域体现显著价值。
数据集最近研究
最新研究方向
随着人工智能技术在司法领域的深入应用,AppealCase数据集的推出为上诉案件智能分析开辟了新的研究方向。该数据集聚焦于民事案件上诉场景,填补了传统LegalAI研究中一审与二审关联性分析的空白。当前研究热点集中在基于大语言模型的上诉结果预测、判决逆转原因自动识别,以及法律条文适用性分析等方向。该数据集的结构化标注体系为开发具有因果推理能力的法律AI系统提供了重要支撑,其91种案由覆盖范围更是为跨领域司法知识迁移研究创造了条件。2025年arXiv论文的发表引发了学界对上诉审司法智能化的广泛讨论,特别是在如何利用AI技术辅助法官发现一审裁判错误、提高司法公正性方面展现出巨大潜力。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务