遇见数据集

SargeZT/coco-stuff-captioned-multi

收藏
Hugging Face2023-08-03 更新2024-03-04 收录
官方服务:

资源简介:

--- configs: - config_name: default data_files: - split: test path: data/test-* - split: train path: data/train-* dataset_info: features: - name: image dtype: image - name: segmented dtype: image - name: caption dtype: string - name: gray_image dtype: image - name: softedge dtype: image - name: depth dtype: image - name: canny dtype: image - name: binary dtype: image - name: color dtype: image splits: - name: test num_bytes: 6925042.0 num_examples: 8 - name: train num_bytes: 7013965619.0 num_examples: 9000 download_size: 7008916049 dataset_size: 7020890661.0 --- # Dataset Card for "coco-stuff-captioned-multi" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

配置项: - 配置名称:default 数据文件: - 数据集拆分:测试集(test),路径:data/test-* - 数据集拆分:训练集(train),路径:data/train-* 数据集信息: 特征: - 名称:图像(image),数据类型:图像(image) - 名称:分割图像(segmented),数据类型:图像(image) - 名称:图像标题(caption),数据类型:字符串(string) - 名称:灰度图像(gray_image),数据类型:图像(image) - 名称:软边缘图(softedge),数据类型:图像(image) - 名称:深度图(depth),数据类型:图像(image) - 名称:Canny边缘图(canny),数据类型:图像(image) - 名称:二值图像(binary),数据类型:图像(image) - 名称:彩色图像(color),数据类型:图像(image) 数据集拆分: - 名称:测试集(test),占用字节数:6925042.0,样本数量:8 - 名称:训练集(train),占用字节数:7013965619.0,样本数量:9000 下载大小:7008916049 数据集总大小:7020890661.0 # 「coco-stuff-captioned-multi」数据集卡片 [需补充更多信息](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

提供机构:
SargeZT
原始信息汇总

数据集概述

配置信息

  • 默认配置 (config_name: default)
    • 测试数据 (split: test):
      • 路径: data/test-*
    • 训练数据 (split: train):
      • 路径: data/train-*

数据集特征

  • 图像 (name: image, dtype: image)
  • 分割图像 (name: segmented, dtype: image)
  • 标题 (name: caption, dtype: string)
  • 灰度图像 (name: gray_image, dtype: image)
  • 边缘图像 (name: softedge, dtype: image)
  • 深度图像 (name: depth, dtype: image)
  • 边缘检测图像 (name: canny, dtype: image)
  • 二值图像 (name: binary, dtype: image)
  • 彩色图像 (name: color, dtype: image)

数据集分割信息

  • 测试集 (name: test)
    • 示例数量: 8
    • 数据大小: 6925042.0 字节
  • 训练集 (name: train)
    • 示例数量: 9000
    • 数据大小: 7013965619.0 字节

数据集大小

  • 下载大小: 7008916049 字节
  • 数据集总大小: 7020890661.0 字节
搜集汇总
数据集介绍
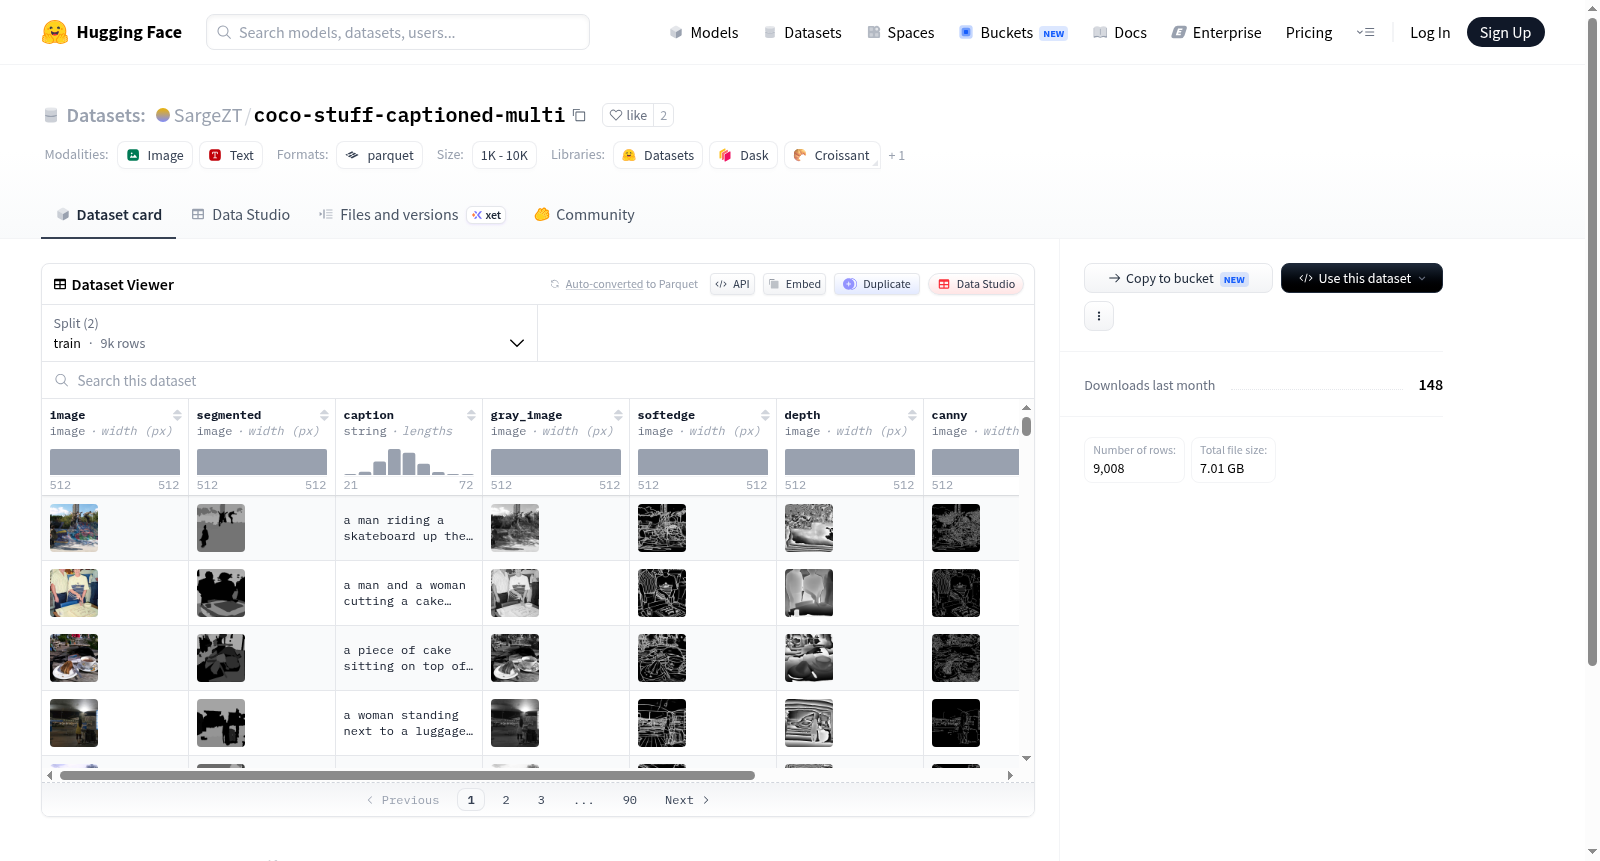
SargeZT/coco-stuff-captioned-multi 数据集图片
构建方式
在计算机视觉与自然语言处理交叉领域,精细化的多模态数据集对于推动图像生成与理解任务至关重要。SargeZT/coco-stuff-captioned-multi数据集基于经典的COCO-Stuff数据集构建,通过扩展与增强,为每个图像样本提供了丰富的条件控制信息。构建时,原始图像被配以语义分割图、灰度图、软边缘图、深度图、Canny边缘图、二值图以及彩色图等多种视觉表征,同时保留对应的文本描述,从而形成一个结构化的多条件学习资源。
特点
该数据集的核心特色在于其多模态、多条件的并行呈现。每个样本包含原始图像、九种不同类型的处理图像以及一个文本描述,覆盖了从低级边缘信息到高级语义分割的多个视觉层次。这种设计使得模型能够同时学习图像内容与其多种变换形式之间的映射关系,尤其适用于ControlNet等条件生成模型的训练。数据集包含9000个训练样本和8个测试样本,规模适中,便于研究者进行快速迭代与验证。
使用方法
使用该数据集时,研究者可通过HuggingFace Datasets库直接加载,指定'default'配置即可获取包含'image'、'segmented'、'caption'等十个字段的样本。训练时,可将文本描述作为条件输入,配合任意一种或多种图像表征(如深度图或软边缘图)作为控制信号,用于训练图像生成模型。测试集规模较小,适合用于模型效果的定性评估,而完整的训练集则可支撑基于扩散模型或GAN的条件图像合成实验。
背景与挑战
背景概述
在计算机视觉与自然语言处理交叉领域,图像描述生成(Image Captioning)一直是研究的核心课题,旨在让机器能够理解图像内容并生成符合语义的自然语言描述。SargeZT/coco-stuff-captioned-multi数据集应运而生,其构建基于广泛使用的COCO-Stuff数据集,通过扩充多模态信息与精细化标注,为图像描述任务提供了更加丰富的训练资源。该数据集创建于近年,由SargeZT等研究人员主导,核心研究问题在于如何利用语义分割、深度图、边缘检测等多模态辅助信号提升描述生成的质量与鲁棒性。数据集包含9000个训练样本和8个测试样本,每个样本不仅提供原始图像与描述,还附带了灰度图、软边缘、深度图、Canny边缘、二值图及彩色图等多种视觉表征,显著推动了多模态融合描述生成研究的发展。
当前挑战
当前该数据集面临的主要挑战包括:其一,在领域问题层面,图像描述生成任务需应对场景理解中的细粒度语义歧义,例如复杂场景中多个物体的空间关系描述、遮挡情况下的内容推断等,传统单模态描述模型难以充分利用多模态辅助信息;其二,在构建过程中,数据集规模相对有限(仅9000个训练样本),且测试集样本极少(8个),这限制了模型泛化能力的评估与大规模预训练策略的应用;其三,多模态信息的对齐与融合存在技术难点,如深度图与边缘图在光照变化下的噪声干扰,以及不同模态特征之间的尺度不一致问题,增加了模型设计的复杂性。
常用场景
经典使用场景
COCO-Stuff-Captioned-Multi数据集在计算机视觉与自然语言处理交叉领域中占据重要地位,其经典使用场景聚焦于多模态生成任务。该数据集为每张图像提供了原始图像、语义分割图、灰度图、软边缘图、深度图、Canny边缘图、二值图及色彩图等多种视觉表征,并配以对应的文本描述。这种多模态对齐特性使其成为训练可控图像生成模型(如基于文本引导的图像编辑与风格迁移)的理想选择,研究者可借助这些条件信号实现从文本到图像各层次特征的精准映射。
解决学术问题
该数据集有效解决了多条件图像生成中训练数据匮乏的学术难题。传统数据集往往仅提供单一模态的文本-图像对,难以支持对图像结构、深度、边缘等细粒度语义的控制。COCO-Stuff-Captioned-Multi通过系统性地提供八种互补的视觉条件,使得研究者能够探索不同表征对生成结果的影响机制,推动了可控生成领域从粗粒度语义匹配向细粒度结构约束的范式转变。其意义在于为解耦图像表征学习提供了标准化基准,促进了文本引导下的多模态融合理论发展。
衍生相关工作
基于COCO-Stuff-Captioned-Multi数据集,学术界涌现了一系列经典工作。其中,可控扩散模型(如ControlNet系列)常以此类多条件数据集作为训练基础,验证不同控制信号对生成质量的影响;多模态提示学习研究则利用其丰富的视觉表征,探索文本与图像条件间的协同优化策略。此外,该数据集还催生了关于条件生成中模态平衡与冲突消解的理论分析,推动了图像生成领域从单条件控制向多条件融合的演进。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务