CuREV
收藏资源简介:
CuREV是一个为提高代码审查质量而精心策划的代码审查数据集,用于改善语言模型在代码审查下游任务(如评论生成和代码优化)的性能。
CuREV is a meticulously curated code review dataset crafted to improve code review quality and enhance the performance of language models on downstream code review tasks such as comment generation and code optimization.
CuREV数据集概述
数据集名称
CuREV: Curating Review Comments for Improved Code Review Automation
数据集简介
CuREV是一个经过优化的代码审查评论数据集,旨在提高数据质量并改善语言模型在代码审查下游任务(如评论生成和代码优化)的性能。
主要贡献
- 数据中心化的评估框架
- 用于提高评论质量的审查数据集优化管道
- 对优化后数据集在下游任务中的性能评估
数据集结构
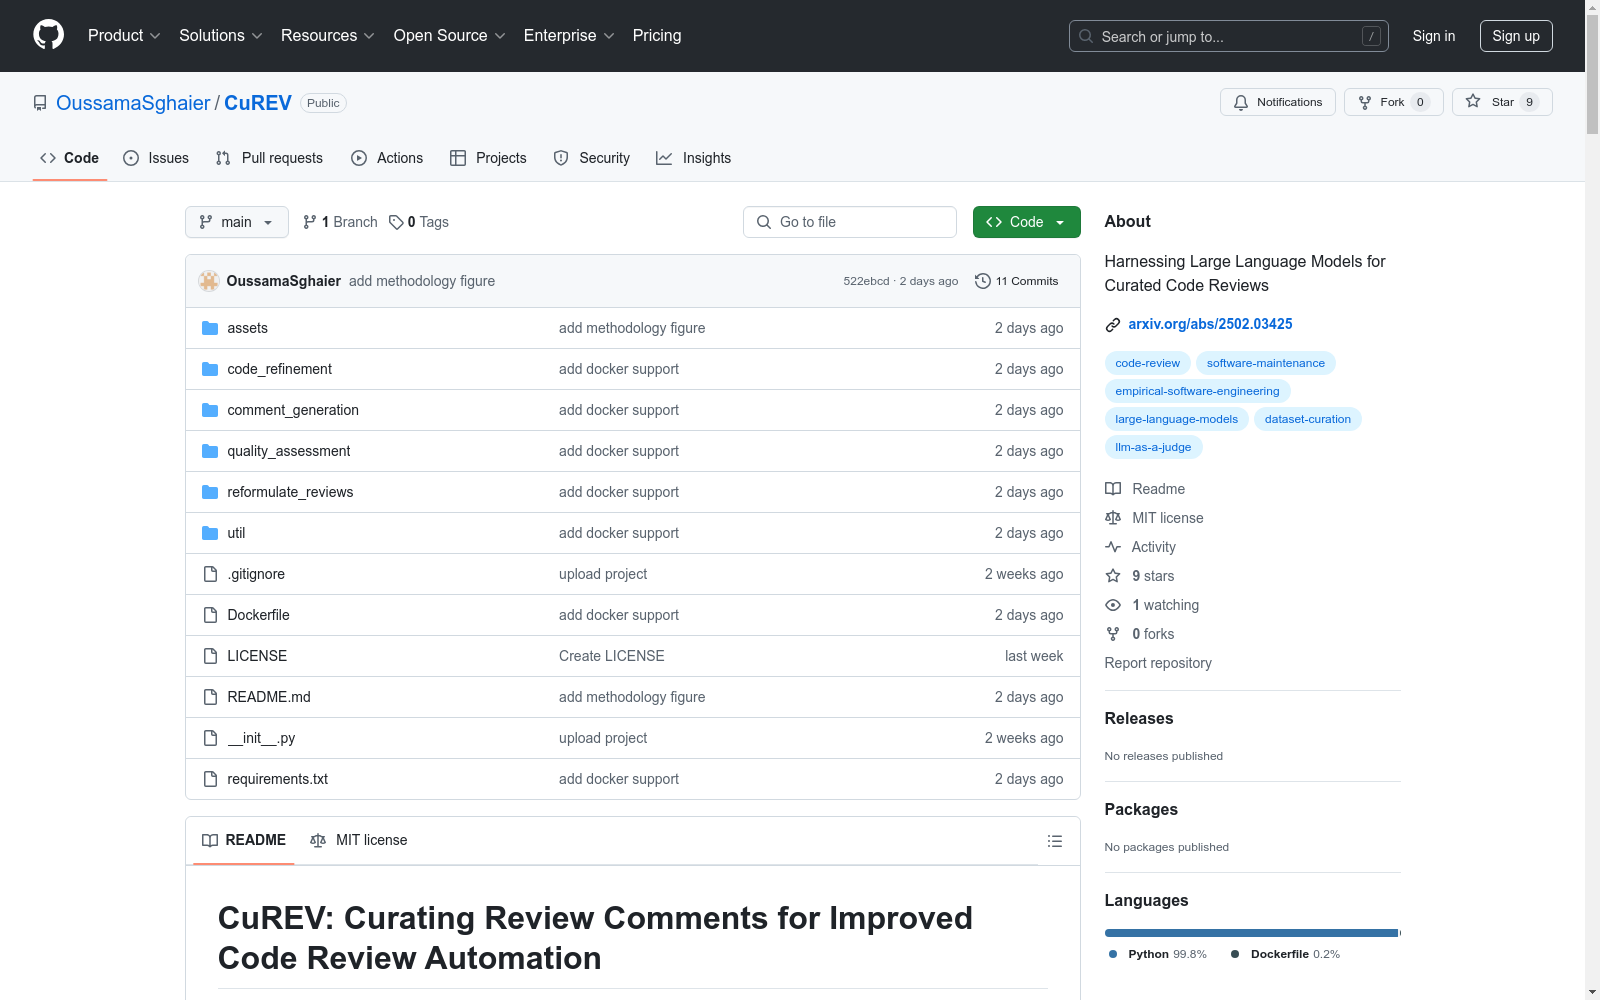
数据集包含以下目录结构:
code_refinement/:代码优化包comment_generation/:评论生成包quality_assessment/:质量评估研究包data_curation/:数据优化包util/:辅助和配置包data/:数据集和结果文件夹models/:大型语言模型文件夹requirements.txt:项目所需的Python库
环境设置
支持两种环境设置方法:Python虚拟环境和Docker。
数据来源
原始代码审查数据集可在Zenodo获取。实验需要将Code_Refinement.zip下载到data/文件夹,并使用util.dataset中的create_HFdataset方法合并jsonl文件为HuggingFace数据集。
模型
使用Llama-3.1-70B模型在本地机器上生成准确的判断。可以选择相同或兼容ExLlamaV2的量化模型,并将其放置在models/文件夹下。
评估框架
评估框架包括分类方案和评分标准,用于对代码审查评论的类型、性质、礼貌性、相关性、清晰度和简洁性进行分类和评估。
数据集优化
CuREV数据集的优化实验和相关代码位于data_curation/文件夹中。
下游任务
- 评论生成:使用
comment_generation/文件夹中的脚本进行训练和评估。 - 代码优化:使用
code_refinement/文件夹中的脚本进行训练和评估。
贡献者
Oussama Ben Sghaier, Martin Weyssow, Houari Sahraoui
引用
bibtex @misc{sghaier2025harnessinglargelanguagemodels, title={Harnessing Large Language Models for Curated Code Reviews}, author={Oussama Ben Sghaier and Martin Weyssow and Houari Sahraoui}, year={2025}, eprint={2502.03425}, archivePrefix={arXiv}, primaryClass={cs.SE}, url={https://arxiv.org/abs/2502.03425}, }