
coderm-ef-trajectories-o4-mini-qwen3-30b
收藏官方服务:
资源简介:
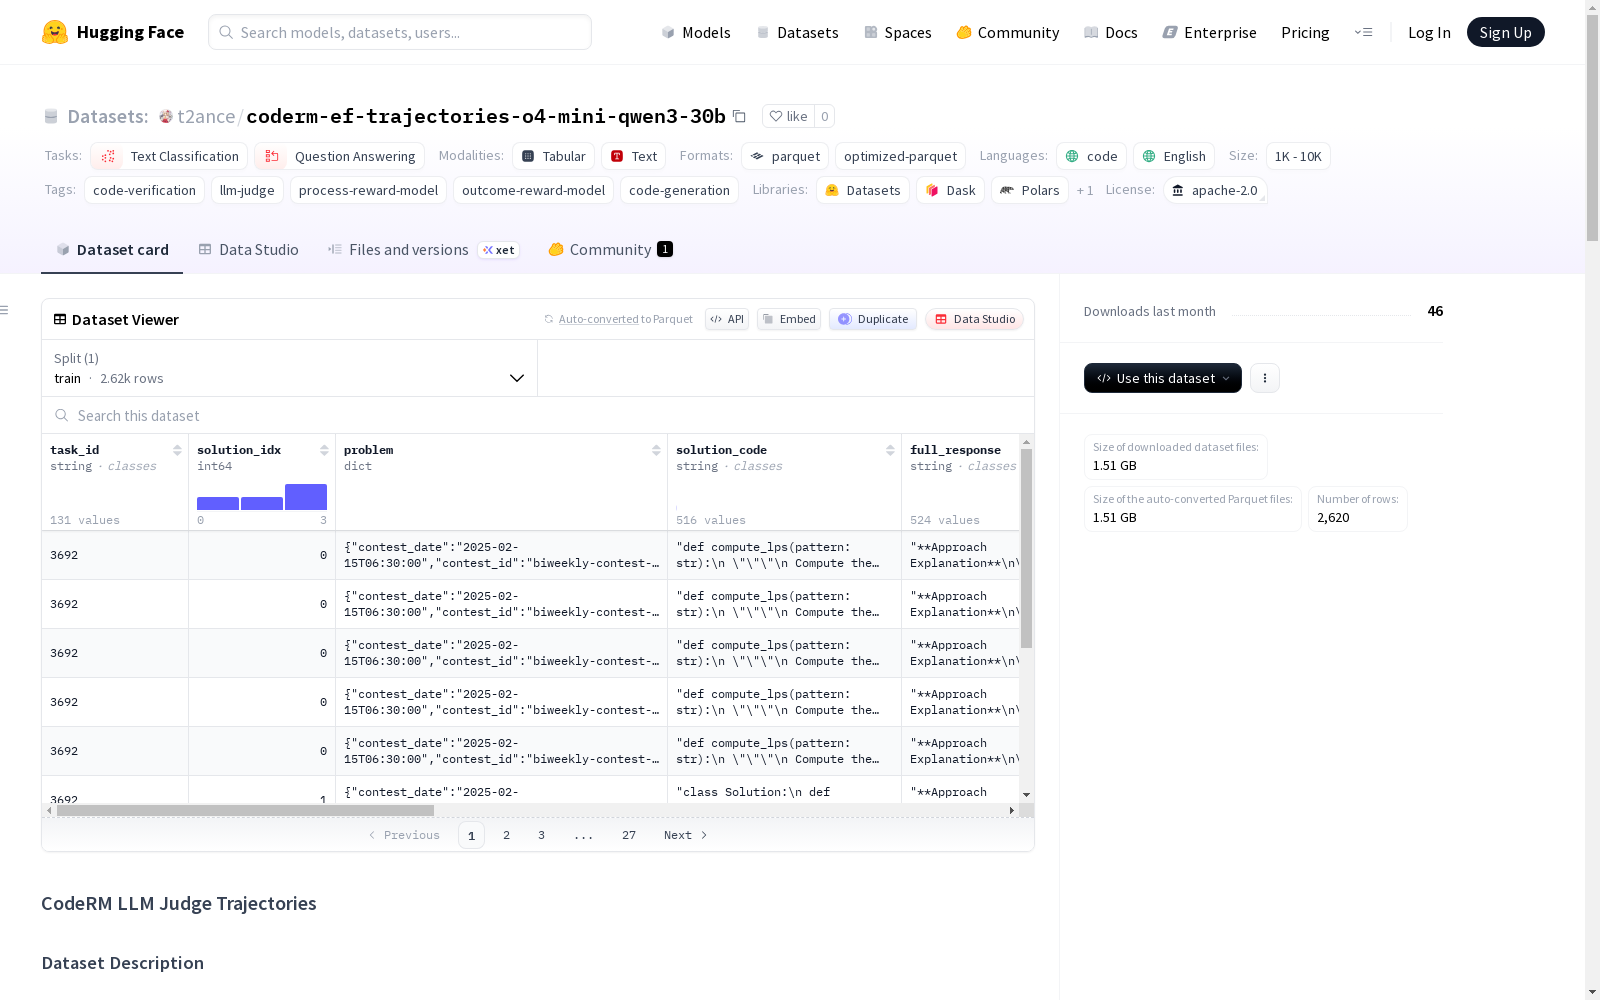
该数据集包含LLM法官验证编程问题代码解决方案的轨迹。每个轨迹都记录了完整的评估过程:问题、候选解决方案、法官推理、预测的正确性分数和实际执行结果。数据集适用于训练结果奖励模型、最佳选择、校准分析、错误分析和验证器集成等多种用途。数据集结构详细,包含任务ID、解决方案代码、法官响应等多个字段。数据集统计信息显示总轨迹数为2620,法官模型为Qwen/Qwen3-Coder-30B-A3B-Instruct,平台包括atcoder和leetcode,难度分布为简单620、中等780、困难1220。
创建时间:
2025-12-17
原始信息汇总
CodeRM LLM Judge Trajectories 数据集概述
数据集基本信息
- 数据集名称:CodeRM LLM Judge Trajectories
- 许可证:Apache 2.0
- 任务类别:文本分类、问答
- 语言:代码、英语
- 数据规模:1K<n<10K
- 标签:代码验证、LLM评判、过程奖励模型、结果奖励模型、代码生成
- 简称:CodeRM LLM Judge Trajectories
数据集描述
该数据集包含一个大型语言模型评判器验证编程问题代码解决方案的轨迹。每个轨迹捕获完整的评估过程:问题、候选解决方案、评判推理、预测的正确性分数以及真实执行结果。
主要用途
- 训练结果奖励模型:学习预测给定问题和解决方案的通过概率。
- 最佳N选择:使用验证器分数从N个候选方案中选择最佳解决方案。
- 校准分析:研究预测概率与实际通过率之间的一致性。
- 错误分析:识别失败模式以改进提示。
- 验证器集成:结合多个评判模型以提高准确性。
数据集统计
- 总轨迹数:2620
- 评判模型:Qwen/Qwen3-Coder-30B-A3B-Instruct
- 问题平台:atcoder, leetcode
- 难度分布:
- 简单:620
- 中等:780
- 困难:1220
数据结构
字段说明
- task_id:问题标识符。
- solution_idx:该问题的解决方案索引。
- problem:完整的问题规范,包含标题、内容、平台、难度和公共测试用例。
- solution_code:提取的可执行代码。
- full_response:包含推理的完整LLM响应。
- judge_prompt:发送给评判器的系统消息和用户消息列表。
- judge_response:原始评判输出。
- actual_passed:真实执行结果。
- num_tests_passed:通过的测试数量。
- num_tests_total:测试总数。
- execution_metadata:错误信息、超时等元数据。
- judge_model:评判模型标识符。
- timestamp:ISO时间戳。
- token_usage:令牌计数。
- inference_time:推理时间(秒)。
使用方法
python from datasets import load_dataset
dataset = load_dataset("t2ance/coderm-ef-trajectories-o4-mini-qwen3-30b")
数据收集
- 评判模型:Qwen/Qwen3-Coder-30B-A3B-Instruct,温度0.0,最大令牌数4096。
- 提示模板:评判器接收问题陈述、测试用例、解决方案生成器的完整响应以及提取的可执行代码,任务为预测代码是否通过所有测试。
- 评判响应格式:
<judgement>YES</judgement>或<judgement>NO</judgement>。 - 真实标签:解决方案针对测试用例执行,标签为1(通过所有测试)或0(失败任何测试)。
引用
bibtex @misc{coderm-llm-judge-trajectories, title={CodeRM LLM Judge Trajectories}, year={2025}, publisher={Hugging Face}, url={https://huggingface.co/datasets/t2ance/coderm-ef-trajectories-o4-mini-qwen3-30b} }
搜集汇总
数据集介绍
构建方式
在代码生成与验证的研究领域中,该数据集的构建采用了严谨的自动化流程。其核心在于利用大型语言模型Qwen/Qwen3-Coder-30B-A3B-Instruct作为评判者,对来自AtCoder和LeetCode等平台的编程问题解决方案进行系统性评估。构建过程首先向评判模型呈现完整的问题描述、测试用例以及候选解决方案的代码与推理过程,要求其预测代码能否通过所有测试。评判模型的输出被规范地封装在特定标签内,以提取二元判断。与此同时,每个解决方案均通过实际执行获得真实通过率作为基准真值,从而形成一条包含问题、解决方案、评判推理、预测分数与执行结果的完整评估轨迹。
特点
该数据集在代码智能评估领域展现出鲜明的结构性特征。其收录了2620条详尽的评估轨迹,每条轨迹均封装了从问题定义到最终验证的完整上下文信息,包括原始问题规格、可执行代码、评判模型的完整推理过程以及真实的执行元数据。数据覆盖了从易到难的多种难度级别,且专注于代码验证与奖励模型训练等特定下游任务。数据集的结构化字段设计精良,不仅包含基础的标识与代码,还深度整合了评判提示、令牌使用量、推理时间等过程性元数据,为研究模型决策透明度、预测校准度以及错误模式分析提供了多维度的数据支撑。
使用方法
在实践应用中,该数据集为代码生成模型的性能优化与评估提供了关键资源。研究者可通过Hugging Face的`datasets`库直接加载数据集,便捷地遍历每一条评估轨迹。数据可直接用于训练结果奖励模型,以学习根据问题和解决方案预测其通过概率。此外,其支持在多个候选解决方案中进行择优筛选,或用于分析模型预测概率与实际通过率之间的校准关系。通过深入剖析评判模型的推理响应与真实执行结果的差异,能够识别系统性错误模式,进而指导提示工程改进或构建更精准的验证器集成模型。
背景与挑战
背景概述
在人工智能与软件工程交叉领域,代码生成与验证是核心研究问题。CodeRM LLM Judge Trajectories数据集由研究团队于2025年构建并发布,旨在系统记录大型语言模型作为评判者对编程问题解决方案的完整评估轨迹。该数据集聚焦于代码验证任务,通过捕获问题描述、候选解决方案、评判模型推理过程、预测正确性分数以及真实执行结果,为训练结果奖励模型、优化解决方案选择策略以及分析模型校准性提供了关键数据支撑。其构建基于Qwen3-Coder-30B模型,覆盖了多种在线编程平台的不同难度题目,显著推动了自动化代码评估与智能编程助手领域的研究进展。
当前挑战
该数据集致力于解决代码生成领域中自动化验证的挑战,即如何准确预测给定代码解决方案能否通过全部测试用例。这一任务面临模型推理与真实执行结果对齐的困难,包括评判模型对复杂代码逻辑的理解偏差、对边缘案例的覆盖不足,以及概率预测与实际通过率之间的校准误差。在数据构建过程中,挑战主要体现在确保评判提示的标准化与可复现性,从模型响应中精确提取二元判断标签,以及高效执行大量代码以获取可靠的真实结果,同时需处理不同编程平台测试用例的异构性与执行环境的一致性。
常用场景
经典使用场景
在代码生成与验证的研究领域,该数据集为训练结果奖励模型提供了关键资源。通过捕捉大型语言模型法官对编程问题解决方案的完整评估轨迹,包括问题描述、候选代码、法官推理及执行结果,研究人员能够构建精准的预测模型,以评估给定代码在特定问题上的通过概率。这一过程不仅支持从多个候选方案中筛选最优解,还促进了验证器校准与错误模式分析,为自动化代码质量评估奠定了数据基础。
解决学术问题
该数据集有效应对了代码生成系统中验证环节的若干核心学术挑战。它通过提供详尽的法官推理轨迹与真实执行结果,解决了预测模型与实际情况之间的校准偏差问题,使研究者能够深入分析模型判断的置信度与真实通过率的一致性。此外,数据集支持对代码失败模式的系统性识别,为改进提示工程与模型优化提供了实证依据,从而提升了自动化代码验证的可靠性与可解释性。
衍生相关工作
围绕该数据集,已衍生出一系列聚焦于代码验证与奖励建模的经典研究工作。例如,基于轨迹数据训练的结果奖励模型被广泛应用于强化学习框架,以优化代码生成策略;同时,多法官模型集成方法通过结合不同模型的判断,显著提升了验证的整体准确性。这些工作进一步推动了代码生成领域中对可靠性、效率与泛化能力的探索,形成了持续演进的研究脉络。
以上内容由遇见数据集搜集并总结生成


