
SwayStar123/FFHQ_1024_DC-AE_f64
收藏官方服务:
资源简介:
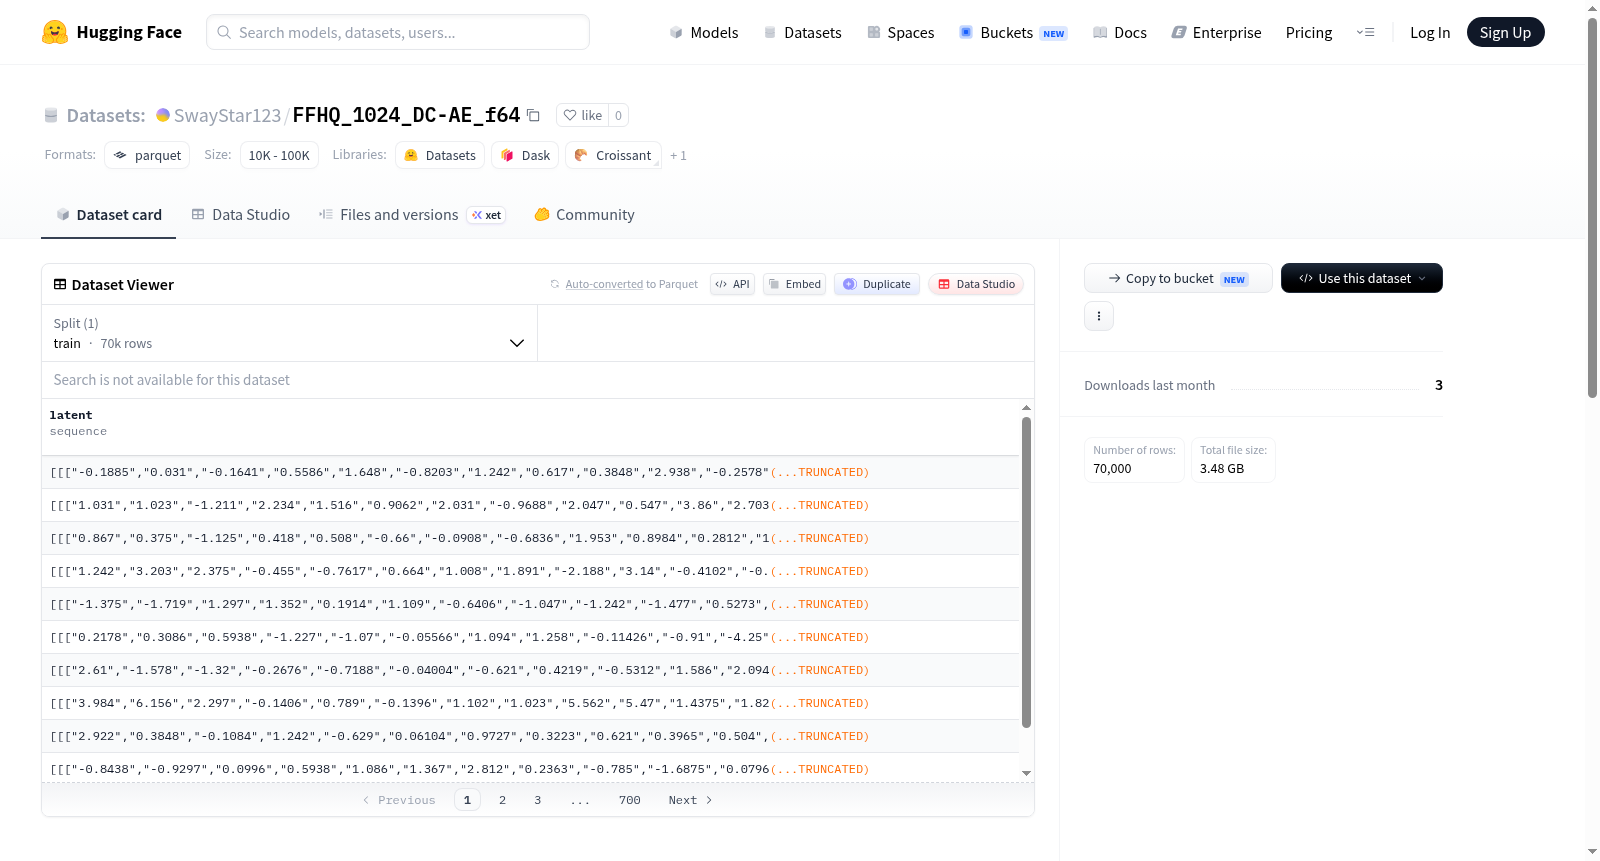
该数据集是FFHQ Dataset的编码版本,使用了dc-ae-f64c128-mix-1.0自动编码器进行编码。数据集包含一个名为latent的特征,其结构为嵌套的浮点数序列。数据集分为训练集,包含70,000个样本,总大小为5,197,080,000字节。
This dataset is an encoded version of the FFHQ Dataset, using the dc-ae-f64c128-mix-1.0 auto encoder. The dataset contains a feature named latent, which is a nested sequence of float16 values. The dataset is split into a training set with 70,000 examples and a total size of 5,197,080,000 bytes.
提供机构:
SwayStar123搜集汇总
数据集介绍
构建方式
在生成式模型与图像压缩领域,潜在空间表征的构建对于高效数据表示至关重要。SwayStar123/FFHQ_1024_DC-AE_f64数据集基于广泛使用的FFHQ人脸数据集构建,其核心创新在于利用dc-ae-f64c128-mix-1.0自编码器对原始1024×1024分辨率的人脸图像进行编码,将高维像素空间映射至紧凑的64维潜在空间。该自编码器采用混合精度训练策略,确保了编码质量与计算效率的平衡。整个数据集包含70000个训练样本,每个样本以float16格式存储潜在编码,显著降低了存储需求,同时保留了人脸图像的语义与结构信息。
使用方法
使用该数据集时,需首先通过HuggingFace Datasets库加载训练集,随后将潜在编码转换为PyTorch张量并指定设备与数据类型。关键步骤是实例化对应的dc-ae-f64c128-mix-1.0自编码器,并确保其运行在bfloat16模式下以避免质量损失。解码过程通过调用自编码器的decode方法完成,输出需经反归一化处理以恢复至[0,1]范围。最终,可利用torchvision工具保存或可视化重建图像。该流程适用于图像生成、特征提取及潜在空间插值等下游任务,开发者可根据需求灵活调整批处理大小与精度设置。
背景与挑战
背景概述
在生成式人工智能领域,高保真图像生成与高效潜空间表示的研究一直是推动视觉合成技术发展的核心动力。FFHQ(Flickr-Faces-High-Quality)作为经典的人脸数据集,自2019年由NVIDIA团队发布以来,凭借其70000张高质量、多样化的人脸图像,成为图像生成模型(如StyleGAN系列)训练与评估的基准。SwayStar123/FFHQ_1024_DC-AE_f64数据集在此基础上进行了创新性扩展,利用dc-ae-f64c128-mix-1.0自编码器将原始1024×1024分辨率图像编码为紧凑的64维潜变量,旨在探索更高效的图像压缩与重建范式。该数据集由SwayStar123团队于2024年创建,核心研究问题在于验证离散编码自编码器(DC-AE)在保持高视觉质量的同时,能否实现显著降维,从而为下游任务(如潜扩散模型)提供更轻量的输入表示。其影响力体现在为大规模图像生成任务开辟了新的技术路径,推动了潜空间压缩与解码效率的边界。
当前挑战
该数据集面临的核心挑战首先源于领域问题:如何在极低维度(64维)的潜空间中保留人脸图像的细粒度语义特征(如肤色、表情、发丝纹理),避免因过度压缩导致的细节丢失或伪影,这直接关系到生成模型在人物身份保持与多样性的表现。其次,构建过程中遭遇显著技术难点:dc-ae-f64c128-mix-1.0自编码器对数值精度极为敏感,使用float16推理会导致重建质量严重退化,必须采用bfloat16精度,这对硬件兼容性与计算资源提出额外要求;同时,70,000个样本的编码过程需平衡压缩效率与计算开销,确保潜变量在保持高保真度的前提下实现跨样本一致性,这对编码器的泛化能力与训练稳定性构成严峻考验。
常用场景
经典使用场景
在生成式模型与图像压缩领域,SwayStar123/FFHQ_1024_DC-AE_f64数据集扮演着核心角色。该数据集基于FFHQ高清人脸图像,采用DC-AE(离散编码自编码器)进行高效编码,将原始像素空间映射至紧凑的潜变量空间。研究者常利用其提供的预计算潜变量,直接训练或微调扩散模型、自回归生成模型等,省去重复编码的计算开销,显著提升实验效率。这一经典使用场景为探索高质量人脸生成与可控编辑奠定了数据基础。
解决学术问题
该数据集直面潜变量生成模型中“编码-解码失配”与“计算瓶颈”两大难题。传统方法需在训练时频繁调用编码器,导致显存与时间成本高昂;而FFHQ_1024_DC-AE_f64通过离线编码,提供了稳定且可复用的潜变量表示,使研究者能专注于生成模型架构创新。它解决了大规模人脸数据在离散潜空间中的高效表征问题,推动了潜变量扩散模型、VQGAN等工作的性能突破,成为评估生成质量与压缩效率的标杆基准。
实际应用
在实际应用中,该数据集赋能了高保真人脸编辑与合成系统。基于其潜变量,开发者可构建实时人脸属性操控工具,如年龄变换、表情迁移或发型修改,无需重新训练复杂模型。同时,在数字人构建、虚拟主播生成、隐私保护的人脸匿名化等场景中,该数据集提供的紧凑编码格式降低了部署算力需求,使得移动端或边缘设备上的高质量人脸生成成为可能,加速了生成式AI从实验室走向产业落地。
数据集最近研究
最新研究方向
在生成式人工智能与图像合成领域,FFHQ数据集长久以来作为高保真人脸图像研究的基准资源,驱动了从StyleGAN到扩散模型的诸多突破。最新研究趋势聚焦于将FFHQ与高效潜空间编码器结合,例如SwayStar123/FFHQ_1024_DC-AE_f64通过DC-AE(深度压缩自编码器)将1024分辨率的人脸图像压缩至64维潜变量,显著降低了计算开销与存储需求,同时保持解码重建质量。这一方向与当下边缘设备部署、实时图像编辑及隐私保护场景紧密关联——潜空间表示不仅支持更快的生成速度,还能通过解耦特征实现细粒度操控,如年龄、表情的连续变换。该数据集的发布标志着人脸生成研究从单纯追求视觉质量向效率与可控性并重的范式转移,为轻量化生成模型、联邦学习中的本地化推理以及低带宽传输应用提供了关键基础设施,其影响延伸至数字人、虚拟现实和AI辅助设计等前沿领域。
以上内容由遇见数据集搜集并总结生成


