遇见数据集

CVasNLPExperiments/VQAv2_sample_validation_google_flan_t5_xxl_mode_D_PNP_GENERIC_Q_rices_ns_100

收藏
Hugging Face2023-06-08 更新2024-03-04 收录
官方服务:

资源简介:

--- dataset_info: features: - name: id dtype: int64 - name: prompt sequence: string - name: question dtype: string - name: true_label sequence: string - name: prediction dtype: string splits: - name: fewshot_0_clip_tags_LAION_ViT_H_14_2B_with_openai_Attributes_LAION_ViT_H_14_2B_descriptors_text_davinci_003_full_DETA_detections_deta_swin_large_o365_coco_classes_caption_all_patches_Salesforce_blip_image_captioning_large_clean_ num_bytes: 1172541 num_examples: 100 download_size: 164191 dataset_size: 1172541 --- # Dataset Card for "VQAv2_sample_validation_google_flan_t5_xxl_mode_D_PNP_GENERIC_Q_rices_ns_100" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

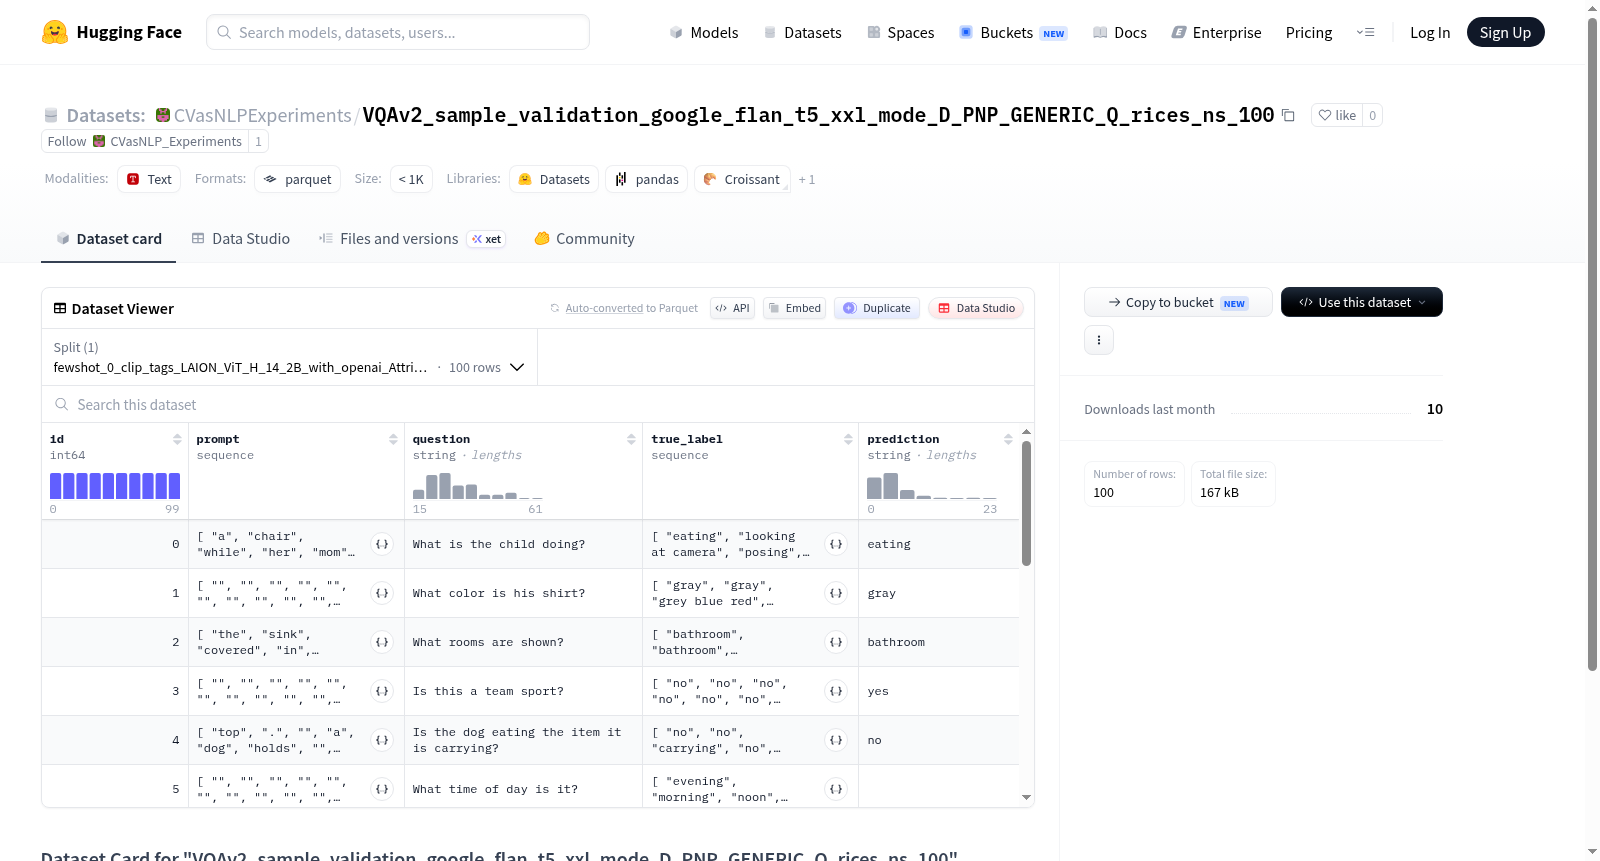
数据集信息: 特征: - 字段名:id,数据类型:int64 - 字段名:prompt,数据类型为字符串序列 - 字段名:question,数据类型为字符串 - 字段名:true_label,数据类型为字符串序列 - 字段名:prediction,数据类型为字符串 数据集拆分: - 拆分名称:fewshot_0_clip_tags_LAION_ViT_H_14_2B_with_openai_Attributes_LAION_ViT_H_14_2B_descriptors_text_davinci_003_full_DETA_detections_deta_swin_large_o365_coco_classes_caption_all_patches_Salesforce_blip_image_captioning_large_clean_,数据占用字节数:1172541,样本数量:100 下载大小:164191字节,数据集总占用大小:1172541字节 # 数据集卡片:"VQAv2_sample_validation_google_flan_t5_xxl_mode_D_PNP_GENERIC_Q_rices_ns_100" [需补充更多信息](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)

提供机构:
CVasNLPExperiments
原始信息汇总

数据集概述

数据集名称

  • VQAv2_sample_validation_google_flan_t5_xxl_mode_D_PNP_GENERIC_Q_rices_ns_100

数据集特征

  • id: 整数类型 (int64)
  • prompt: 字符串序列
  • question: 字符串类型
  • true_label: 字符串序列
  • prediction: 字符串类型

数据集分割

  • 分割名称: fewshot_0_clip_tags_LAION_ViT_H_14_2B_with_openai_Attributes_LAION_ViT_H_14_2B_descriptors_text_davinci_003_full_DETA_detections_deta_swin_large_o365_coco_classes_caption_all_patches_Salesforce_blip_image_captioning_large_clean_
  • 数据大小: 1172541 字节
  • 示例数量: 100

数据集大小

  • 下载大小: 164191 字节
  • 数据集大小: 1172541 字节
搜集汇总
数据集介绍
CVasNLPExperiments/VQAv2_sample_validation_google_flan_t5_xxl_mode_D_PNP_GENERIC_Q_rices_ns_100 数据集图片
构建方式
该数据集源自VQAv2验证集的一个子集,旨在评估多模态大模型在视觉问答任务上的表现。构建过程中,首先从原始VQAv2验证集中随机抽取100个样本,确保样本的多样性和代表性。随后,为每个样本生成多个提示(prompt),并利用谷歌的flan-t5-xxl模型在特定模式(Mode D)下进行推理,结合PNP(Prompting with Negative Prompts)策略和GENERIC_Q(通用问题)范式,同时采用RICES(Retrieval-based In-Context Example Selection)方法从100个负样本中选取上下文示例。最终,数据集包含每个样本的ID、问题、真实标签、模型预测以及对应的提示序列,形成结构化的评估数据。
使用方法
该数据集主要用于评估和比较多模态大模型在视觉问答任务上的表现。使用时,可加载数据集中的'fewshot_0_clip_tags_LAION_ViT_H_14_2B_with_openai_Attributes_LAION_ViT_H_14_2B_descriptors_text_davinci_003_full_DETA_detections_deta_swin_large_o365_coco_classes_caption_all_patches_Salesforce_blip_image_captioning_large_clean_'拆分。通过对比每个样本的true_label和prediction字段,可计算模型准确率等指标。同时,利用prompt字段分析不同提示设计对预测结果的影响,或将其作为少样本学习的测试基准。由于数据集基于HuggingFace格式存储,用户可直接使用datasets库加载,并配合其他视觉特征文件进行多模态任务的深入分析。
背景与挑战
背景概述
视觉问答(VQA)作为多模态理解领域的核心任务,旨在通过图像与文本的联合推理来回答自然语言问题。VQAv2数据集作为该领域的基准之一,显著提升了模型对视觉内容与语义关联的推理能力,其引入的平衡采样策略有效缓解了原始VQA数据集中的偏见问题。本数据集由CVasNLPExperiments团队于近期构建,基于VQAv2验证集样本,结合Google Flan-T5-XXL大语言模型与多种视觉语言技术(如RICES检索、CLIP标签、BLIP描述等),探索了生成式多模态推理的范式。其核心研究问题聚焦于如何通过指令微调与上下文学习,提升模型在复杂视觉场景中的零样本推理表现,对推动多模态大模型在细粒度理解与可解释性方面具有重要参考价值。
当前挑战
当前数据集面临的核心挑战包括:1)领域问题层面,视觉问答任务需克服图像中对象关系、空间布局及隐含语义的歧义性,例如模型易受语言先验干扰而忽视视觉证据,导致对反事实问题的误判;2)构建过程中,多模态特征的融合与对齐存在技术难点,如不同视觉编码器(CLIP、DETA)与语言模型(Flan-T5)的表示空间差异需通过提示工程与检索增强(如RICES)进行协调,但采样策略的稳定性与泛化性仍受限于小样本规模(100例验证样本);3)评估维度上,现有指标难以全面衡量模型对视觉细节的敏感度与逻辑一致性,且生成式输出缺乏对错误传播的鲁棒性分析机制。
常用场景
经典使用场景
在视觉问答(VQA)领域,VQAv2_sample_validation_google_flan_t5_xxl_mode_D_PNP_GENERIC_Q_rices_ns_100数据集为多模态大语言模型的评估与优化提供了关键基准。该数据集采撷自VQAv2验证集,通过引入基于RICES(Retrieval-based In-Context Example Selection)的上下文示例选择策略,结合Flan-T5-XXL模型在特定推理模式下的输出,构建了一个用于校验模型预测与真实标签一致性的样本集合。其经典使用场景聚焦于零样本或少样本情景下模型推理能力的剖析,尤其适用于探究提示工程、上下文学习及检索增强生成等技术对视觉-语言联合理解的影响。研究者能够借助该数据集验证模型在复杂视觉场景中回答自然语言问题的稳健性,从而推动多模态推理范式的演进。
解决学术问题
该数据集直面视觉问答任务中模型泛化性与可解释性不足的学术挑战。传统VQA模型常因训练数据偏差而陷入语言捷径,难以真正理解视觉内容。通过提供包含检索增强提示与多源视觉标签(如CLIP属性、DETA检测框、BLIP字幕)的样本,该数据集支持研究者解耦模型对视觉线索与语言先验的依赖,量化上下文示例选择对推理准确率的增益。它解决了如何系统性评估大语言模型在视觉输入下的鲁棒性这一核心问题,揭示了提示设计、示例质量与模型规模之间的复杂交互。这一工作对构建更可信、更具常识推理能力的多模态系统具有范式意义,为后续研究如何缓解分布外偏移、提升跨模态对齐质量奠定了实证基础。
实际应用
在实际应用中,该数据集可服务于智能客服、辅助驾驶、医疗影像分析等需视觉问答能力的场景。例如,在工业质检中,模型可依据该数据集的评估框架,结合检索到的历史缺陷样本,对当前产品图像进行精准的异常描述与定位;在无障碍技术领域,它能帮助开发面向视障人士的实时场景理解系统,通过检索类似环境下的问答示例提升回答的可靠性。此外,该数据集所验证的检索增强策略可直接部署于电商图文检索、教育辅导机器人等产品中,使模型在资源受限时仍能通过动态示例获取领域知识,从而降低对海量标注数据的依赖,加速多模态AI在垂直行业的落地。
数据集最近研究
最新研究方向
在视觉问答(VQA)领域,当前前沿研究聚焦于多模态大语言模型的零样本与少样本推理能力提升,尤其是通过提示工程(如PNP、RICES)与外部知识注入(如CLIP标签、BLIP描述)增强模型对复杂场景的理解。该数据集以Google Flan-T5-XXL为基础,结合多样化视觉特征(如DETA检测、属性描述),探索模型在无需任务特定微调下的泛化性能。这一方向与近期多模态基础模型(如LLaVA、GPT-4V)的涌现能力研究紧密相关,强调通过结构化提示与跨模态对齐来弥补视觉与语言间的语义鸿沟。其意义在于为评估模型在开放域问答中的鲁棒性提供标准化基准,并推动可解释、可泛化的视觉推理系统发展,对自动驾驶、医疗影像分析等高风险应用具有重要借鉴价值。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务