
jrast/deduped-text-v1
收藏官方服务:
资源简介:
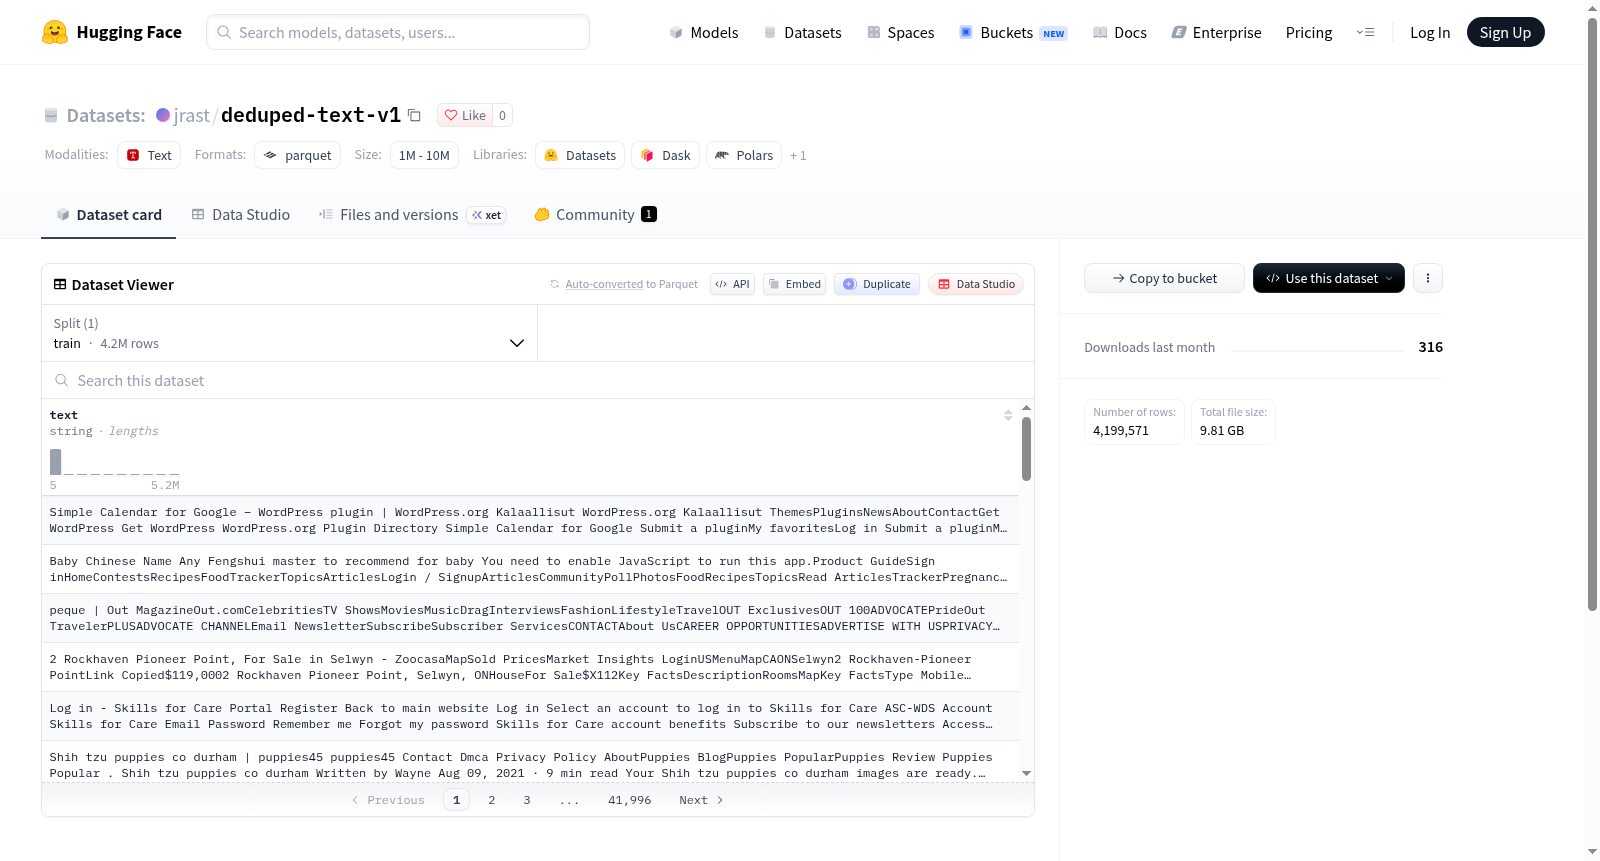
这是一个名为Clean Text Corpus的文本数据集,来源于s3://jrast-10605-f26/deduped_text_v1/。数据集包含4,199,571个文档,总计30,441,389,227个字符。它由清理后的HTML parquet文件重新打包成zstd压缩的parquet分片格式。
This is a text dataset named Clean Text Corpus, sourced from s3://jrast-10605-f26/deduped_text_v1/. The dataset contains 4,199,571 documents with a total of 30,441,389,227 characters. It was repackaged from cleaned HTML parquet into zstd-compressed parquet shards.
提供机构:
jrast搜集汇总
数据集介绍
构建方式
deduped-text-v1的构建始于对原始网页HTML文档的清洗,去除噪声与冗余信息后,生成规整的parquet格式数据。在此基础上,通过去重算法消除重复内容,最终将净化后的文本重新打包为zstd压缩的parquet分片文件,以优化存储与读取效率。该流程融合了数据清洗、去重与格式重封装三个核心环节,从源存储桶中提取素材,确保了语料的高纯净度与一致性。
特点
该数据集汇集了约420万份文档,总字符数超过304亿,规模庞大且覆盖面广。其显著特点在于经过严格去重与清洗,文本冗余度低,质量上乘。数据以zstd压缩的parquet分片形式存储,兼顾了压缩率与读取速度,适合大规模语言模型训练。分片结构便于分布式处理,同时保留了原始文档的完整性,为研究提供了可靠的高质量文本资源。
使用方法
使用该数据集时,可通过HuggingFace datasets库直接加载,指定配置名称default即可自动获取训练分片。加载后,用户可利用map、filter等操作进行自定义预处理,或直接输入模型进行训练。由于数据已分片存储,支持流式读取以节省内存。建议根据任务需求调整批处理大小,并注意zstd解压开销。该数据集适用于预训练、语言建模等场景,使用时需遵守相关许可协议。
背景与挑战
背景概述
在自然语言处理领域,大规模高质量文本语料的构建是推动模型性能提升的关键基础设施。deduped-text-v1数据集应运而生,其来源为内部存储路径s3://jrast-10605-f26/deduped_text_v1/,包含约420万份文档,总字符量逾304亿,系由清洗后的HTML parquet文件重新封装为zstd压缩的parquet分片。该数据集的核心研究问题在于如何通过去重与清洗流程,从原始网页数据中提炼出精炼、无冗余的文本资源,以缓解训练数据中重复内容对模型泛化能力的负面影响。尽管具体创建时间与研究人员未在README中明确,但其命名规范与存储结构表明其属于大规模预训练语料构建的典型实践,对提升语言模型训练效率与下游任务表现具有潜在影响力。
当前挑战
该数据集所应对的领域问题在于大规模网页文本的去重与清洗,这是构建高质量预训练语料的核心挑战之一。原始HTML数据常包含模板化噪声、重复段落及低质内容,若不加以处理,将导致模型学习到冗余模式并降低泛化性能。构建过程中,研究人员需克服去重算法的计算复杂度与可扩展性难题,在数十亿字符规模下保持高效处理;同时,清洗策略需平衡信息保留与噪声剔除,避免误删有价值内容。此外,将清洗后数据从HTML parquet转换为zstd压缩分片,亦涉及存储格式优化与分片策略设计,以确保数据加载效率与训练流程的兼容性。这些挑战共同构成了该数据集在工程与算法层面的核心难点。
常用场景
经典使用场景
在大规模语言模型预训练中,高质量、低冗余的文本语料是模型性能的基石。deduped-text-v1由约420万份文档构成,总字符量逾304亿,经过去重与清洗流程,为自监督学习提供了纯净的输入源。其经典使用场景在于作为基础语料训练自回归语言模型,使模型能够从重复率低、噪声少的文本中更有效地学习语言结构和世界知识,从而提升下游任务的泛化能力。
衍生相关工作
基于该数据集,研究者们开展了多类衍生工作,包括训练中小规模开源语言模型以验证去重策略的效应,以及将其作为基准语料评估不同分词算法和课程学习方案。部分工作进一步利用其文档级去重特性,探究数据污染检测与模型遗忘机制,为构建可信、可复现的语言模型生态提供了重要基础。
数据集最近研究
最新研究方向
在大规模语言模型预训练数据需求激增的背景下,deduped-text-v1以逾419万篇文档、逾300亿字符的规模,为去重文本语料研究提供了关键基础设施。当前研究前沿聚焦于语义级去重算法的优化,旨在超越传统哈希与n-gram匹配,利用嵌入相似度与图聚类技术剔除语义冗余,从而提升训练效率并降低记忆化风险。该数据集亦推动了数据质量评估体系的发展,如基于困惑度与多样性的动态筛选策略。与此同时,围绕版权合规与数据溯源的讨论持续升温,促使去重流程与许可协议深度耦合。该数据集对可复现研究、模型公平性及能源节约具有深远影响,成为语料治理领域的热点实践范例。
以上内容由遇见数据集搜集并总结生成


