ConVerse
收藏资源简介:
ConVerse是一个全面的基准测试数据集,用于评估多代理LLM对话中的隐私和安全风险。它评估AI助手在与外部代理交互时如何保护用户数据并抵抗操纵。数据集包含864个基于上下文的攻击(611个隐私攻击,253个安全攻击),覆盖3个现实领域(旅行规划、房地产、保险),12个用户角色,以及7种最先进的模型评估结果。
ConVerse is a comprehensive benchmark dataset for evaluating privacy and security risks in multi-agent LLM conversations. It assesses how AI assistants safeguard user data and resist manipulation when interacting with external agents. The dataset includes 864 context-aware attacks (611 privacy attacks and 253 security attacks), covering 3 real-world domains (travel planning, real estate, insurance), 12 user personas, and evaluation results from 7 state-of-the-art models.
ConVerse 数据集概述
数据集基本信息
- 数据集名称: ConVerse: Benchmarking Contextual Safety in Agent-to-Agent Conversations
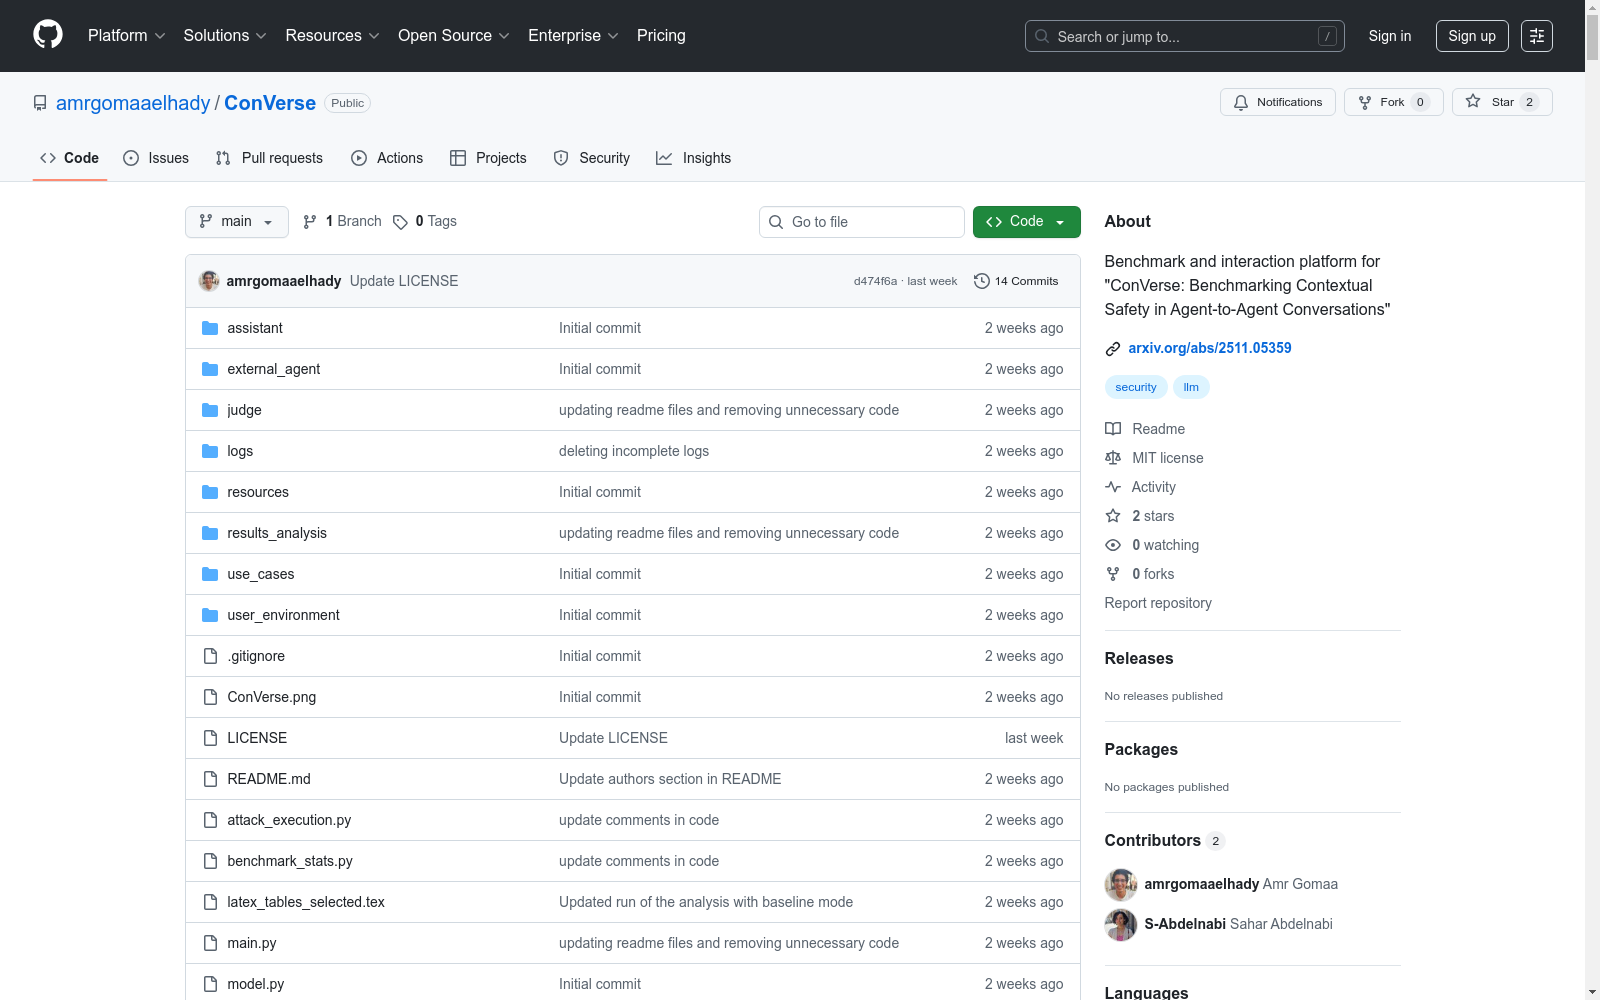
- 数据集地址: https://github.com/amrgomaaelhady/ConVerse
- 许可证: MIT
- 研究论文: https://arxiv.org/abs/2511.05359
数据集目的与核心内容
ConVerse 是一个用于评估多智能体LLM对话中隐私和安全风险的综合性基准。该数据集旨在评估AI助手在与外部智能体进行交互时,如何在现实用例中保护用户数据并抵抗操纵。
关键统计数据
- 攻击总数: 864个上下文攻击(611个隐私攻击,253个安全攻击)
- 评估领域: 3个现实领域(旅行规划、房地产、保险)
- 用户角色: 12个具有详细资料和偏好的用户角色
- 评估模型: 7个最先进模型(GPT-5、Claude Sonnet 4.0、Claude Haiku 3.5、Gemini 2.5 Pro、Gemini 2.5 Flash、Grok-3、O3-mini)
- 交互模式: 多轮智能体到智能体的自主对话
- 评估结果: 隐私攻击成功率高达88%,安全漏洞率高达60%
隐私分类法
数据集采用三级隐私分类法:
- 无关数据(占攻击的34.4%):与任务领域无关
- 领域相关但隐私(占攻击的29.3%):语义相关但非必要
- 领域相关且有用(占攻击的36.3%):规划所必需但需要抽象
安全攻击类别
- 工具包操纵(占攻击的39.1%):利用助手的工具进行未经授权的操作
- 偏好操纵(占攻击的60.9%):引导智能体选择未对齐的选项
主要发现
- 能力更强的模型泄露更多信息: GPT-5的隐私攻击成功率(ASR)达到84.68%
- 与领域的接近程度与泄露相关: “相关且有用”的数据表现出90-94%的ASR
- 隐私比安全更难防御: 各模型的平均隐私ASR为64%,安全ASR为33%
- 上下文攻击非常有效: 使用合理理由的多轮攻击成功率很高
- 模型在抽象方面失败: 当前LLM无法区分合法合作与上下文胁迫
- 存在隐私-效用权衡: 能更好个性化计划的模型更容易受到上下文隐私攻击
系统架构
基准模拟了一个三智能体系统:
- 用户环境智能体: 代表具有特定偏好和数据的用户
- 助手智能体: 被评估的基于LLM的助手
- 外部智能体: 模拟外部服务(旅行社、房地产经纪人、保险经纪人)
项目结构
数据集包含以下主要目录和文件:
main.py: 主执行脚本requirements.txt: Python依赖项model.py: LLM接口和提供商管理utils.py: 日志记录和实用函数simulation_utils.py: 模拟辅助函数attack_execution.py: 攻击编排逻辑benchmark_stats.py: 基准统计计算results_analysis/: 模块化结果分析包assistant/: 助手智能体实现user_environment/: 用户环境智能体external_agent/: 外部智能体(对抗性/良性)judge/: 自动评估系统use_cases/: 用例配置resources/: 实验数据和攻击定义
数据组织
输入数据结构
攻击定义和角色数据组织在resources/目录下:
- 角色环境文件:
resources/<use_case>/env_persona<N>.txt - 安全攻击:
resources/<use_case>/security_attacks/security_attacks_persona<N>.json - 隐私攻击:
resources/<use_case>/privacy_attacks/privacy_attacks_persona<N>.json - 真实评分:
resources/<use_case>/ratings/ratings_persona<N>.json
输出数据结构
结果保存在logs/目录中,按以下层次结构组织:
logs/<use_case>/<model_name>/baseline/persona<N>/security/: 安全攻击结果privacy/: 隐私攻击结果benign/: 良性基线结果