j-chim/pii-pile-chunk3-200000-250000-tagged
收藏资源简介:
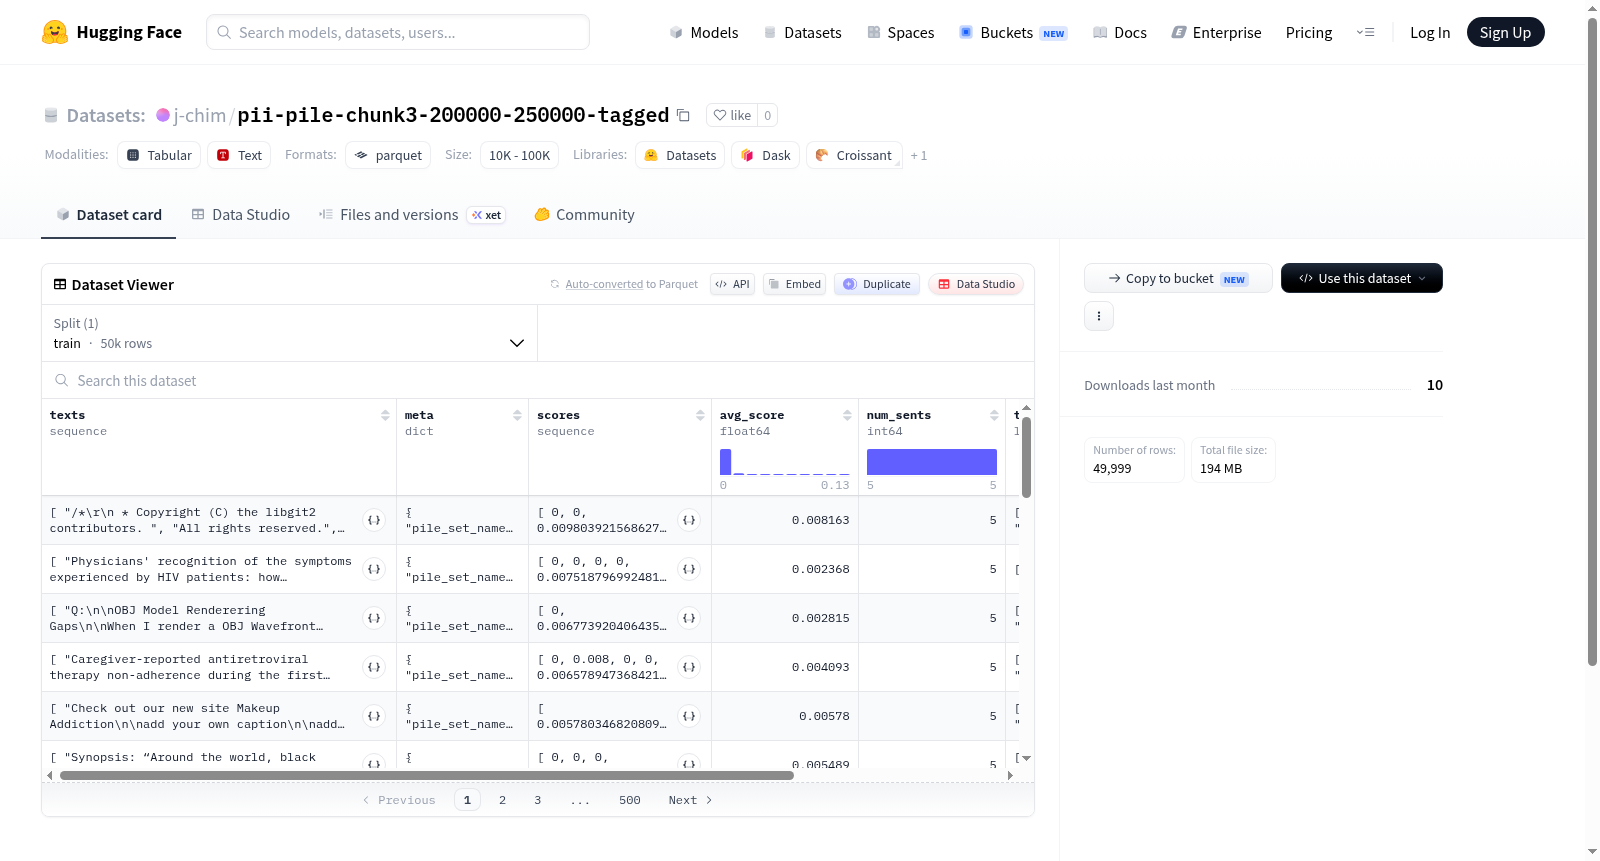
--- dataset_info: features: - name: texts sequence: string - name: meta struct: - name: pile_set_name dtype: string - name: scores sequence: float64 - name: avg_score dtype: float64 - name: num_sents dtype: int64 - name: tagged_pii_results list: - name: analysis_explanation dtype: 'null' - name: end dtype: int64 - name: entity_type dtype: string - name: recognition_metadata struct: - name: recognizer_identifier dtype: string - name: recognizer_name dtype: string - name: score dtype: float64 - name: start dtype: int64 splits: - name: train num_bytes: 508200278 num_examples: 49999 download_size: 194434096 dataset_size: 508200278 --- # Dataset Card for "pii-pile-chunk3-200000-250000-tagged" [More Information needed](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)
数据集信息: 特征字段: - 名称:文本(texts),类型:字符串序列 - 名称:元数据(meta),结构体: - 名称:语料库集合名称(pile_set_name),数据类型:字符串 - 名称:分数(scores),类型:64位浮点数序列 - 名称:平均分数(avg_score),数据类型:64位浮点数 - 名称:句子数量(num_sents),数据类型:64位整数 - 名称:已标记个人可识别信息(Personally Identifiable Information, PII)结果(tagged_pii_results),列表类型,包含字段: - 名称:分析解释(analysis_explanation),数据类型:空值 - 名称:结束位置(end),数据类型:64位整数 - 名称:实体类型(entity_type),数据类型:字符串 - 名称:识别元数据(recognition_metadata),结构体: - 名称:识别器标识符(recognizer_identifier),数据类型:字符串 - 名称:识别器名称(recognizer_name),数据类型:字符串 - 名称:置信分数(score),数据类型:64位浮点数 - 名称:起始位置(start),数据类型:64位整数 数据集划分: - 名称:训练集(train),占用字节数:508200278,样本数量:49999 下载大小:194434096 数据集总大小:508200278 # "pii-pile-chunk3-200000-250000-tagged" 数据集卡片 [需补充更多信息](https://github.com/huggingface/datasets/blob/main/CONTRIBUTING.md#how-to-contribute-to-the-dataset-cards)
数据集概述
数据集名称
- pii-pile-chunk3-200000-250000-tagged
数据集特征
- texts:字符串序列
- meta:结构化数据,包含:
- pile_set_name:字符串类型
- scores:浮点数序列(float64)
- avg_score:浮点数类型(float64)
- num_sents:整数类型(int64)
- tagged_pii_results:列表,包含:
- analysis_explanation:空值(null)
- end:整数类型(int64)
- entity_type:字符串类型
- recognition_metadata:结构化数据,包含:
- recognizer_identifier:字符串类型
- recognizer_name:字符串类型
- score:浮点数类型(float64)
- start:整数类型(int64)
数据集拆分
- train:
- num_bytes:508200278字节
- num_examples:49999个样本
数据集大小
- download_size:194434096字节
- dataset_size:508200278字节