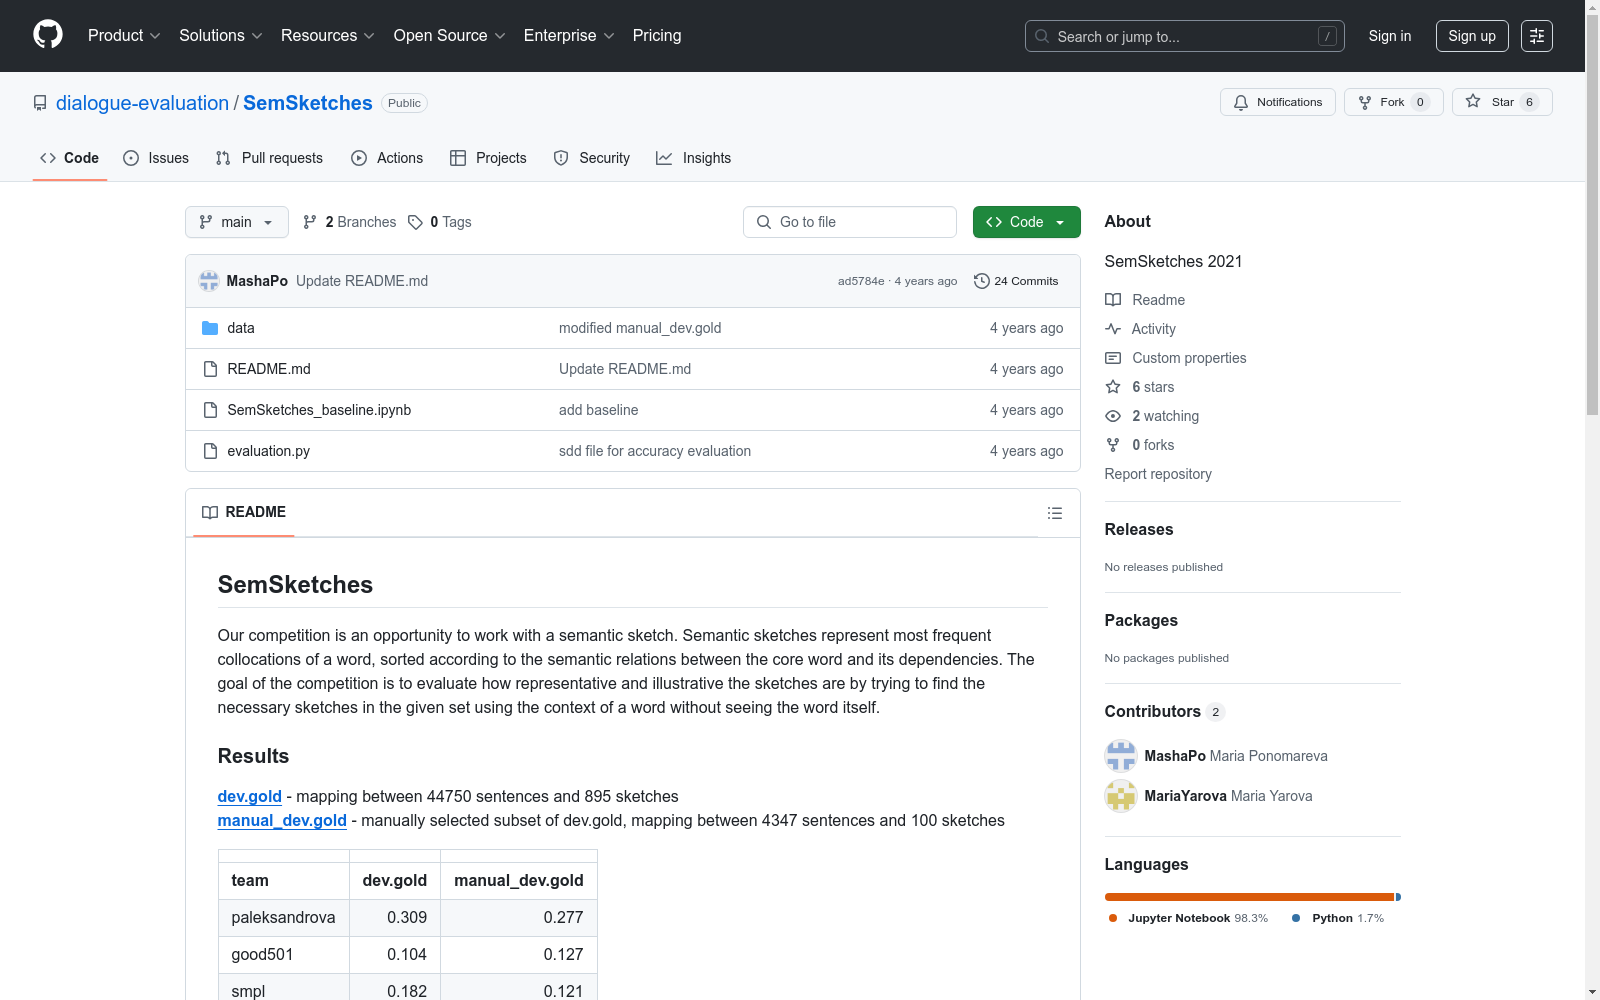
SemSketches-2021
收藏资源简介:
SemSketches-2021数据集是由ABBYY、俄罗斯国立高等经济大学等机构创建的俄语语义草图开放语料库,旨在探索语义草图的自动处理方法。数据集包含915个语义草图,每个草图都是对一个词的语义兼容性的特殊表示,包括词的所有语义链接按照它们与核心词的语义关系进行分组。该数据集通过SemSketches Shared Task进行测试,旨在评估草图的质量和代表性,并开发用于处理草图的工具。数据集可用于语义角色标注、词汇学等领域的研究。
The SemSketches-2021 dataset is an open Russian semantic sketch corpus developed by institutions including ABBYY and the National Research University Higher School of Economics, with the goal of exploring automatic processing methods for semantic sketches. It contains 915 semantic sketches, each serving as a specialized representation of a word's semantic compatibility, where all semantic links of the word are grouped based on their respective semantic relations with the core word. This dataset is evaluated via the SemSketches Shared Task, which aims to assess the quality and representativeness of semantic sketches and develop tools for sketch processing. The dataset can be applied to research in fields such as semantic role labeling and lexicology.
SemSketches 数据集概述
数据集简介
SemSketches 是一个关于语义草图的数据集,旨在通过语义草图评估其代表性和说明性。语义草图表示一个词的最常见搭配,根据核心词与其依赖项之间的语义关系进行排序。数据集的目标是在不看到核心词本身的情况下,通过上下文找到相应的语义草图。
数据集内容
数据文件
- dev.gold:包含 44750 个句子与 895 个语义草图的映射关系。
- manual_dev.gold:手动选择的 dev.gold 子集,包含 4347 个句子与 100 个语义草图的映射关系。
任务
-
任务1:匹配上下文中的谓词语义草图
- 提供不同谓词的上下文集合。
- 目标是将上下文中的谓词与匿名化的语义草图进行匹配(已知角色和搭配,但谓词本身被隐藏)。
- 在歧义谓词的情况下,可能涉及词义消歧(WSD)问题。
-
任务2:多语言语义草图映射
- 提供两种语言(俄语和英语)的语义草图集合,针对相同的意义。
- 目标是将多语言语义草图对进行匹配,实现跨语言意义链接。
- 主要指标为准确率。
组织者
- Maria Ponomareva - ABBYY, HSE
- Maria Petrova - ABBYY
- Maria Yarova - MIPT
- Julia Detkova - ABBYY
- Oleg Serikov - DeepPavlov, HSE
重要链接
- SemSketches Codalab 页面
- Telegram 讨论组:https://t.me/SemSketches
时间线
| 事件 | 日期 |
|---|---|
| 试用数据发布 | 2021年2月12日 |
| 任务1数据发布 | 2021年2月17日 |
| 任务2数据发布 | 2021年3月5日 |
| 系统提交截止 | 2021年3月27日 |
| 最终结果公布 | 2021年3月29日 |
| 论文提交截止 | 2021年4月5日 |
语义草图定义
语义草图是一种词的广义词典学画像,表示词的兼容性描述。每个词的描述包括其最常见的语义依赖项集合,并根据其语义角色(如 Agent、Object、Locative)分类。每个角色提供相关的“填充词”(单词和短语),并根据其与核心词的兼容性频率进行排序。每个草图展示一个词在特定意义下的表现。