
merged_bigvul_primevul
收藏官方服务:
资源简介:
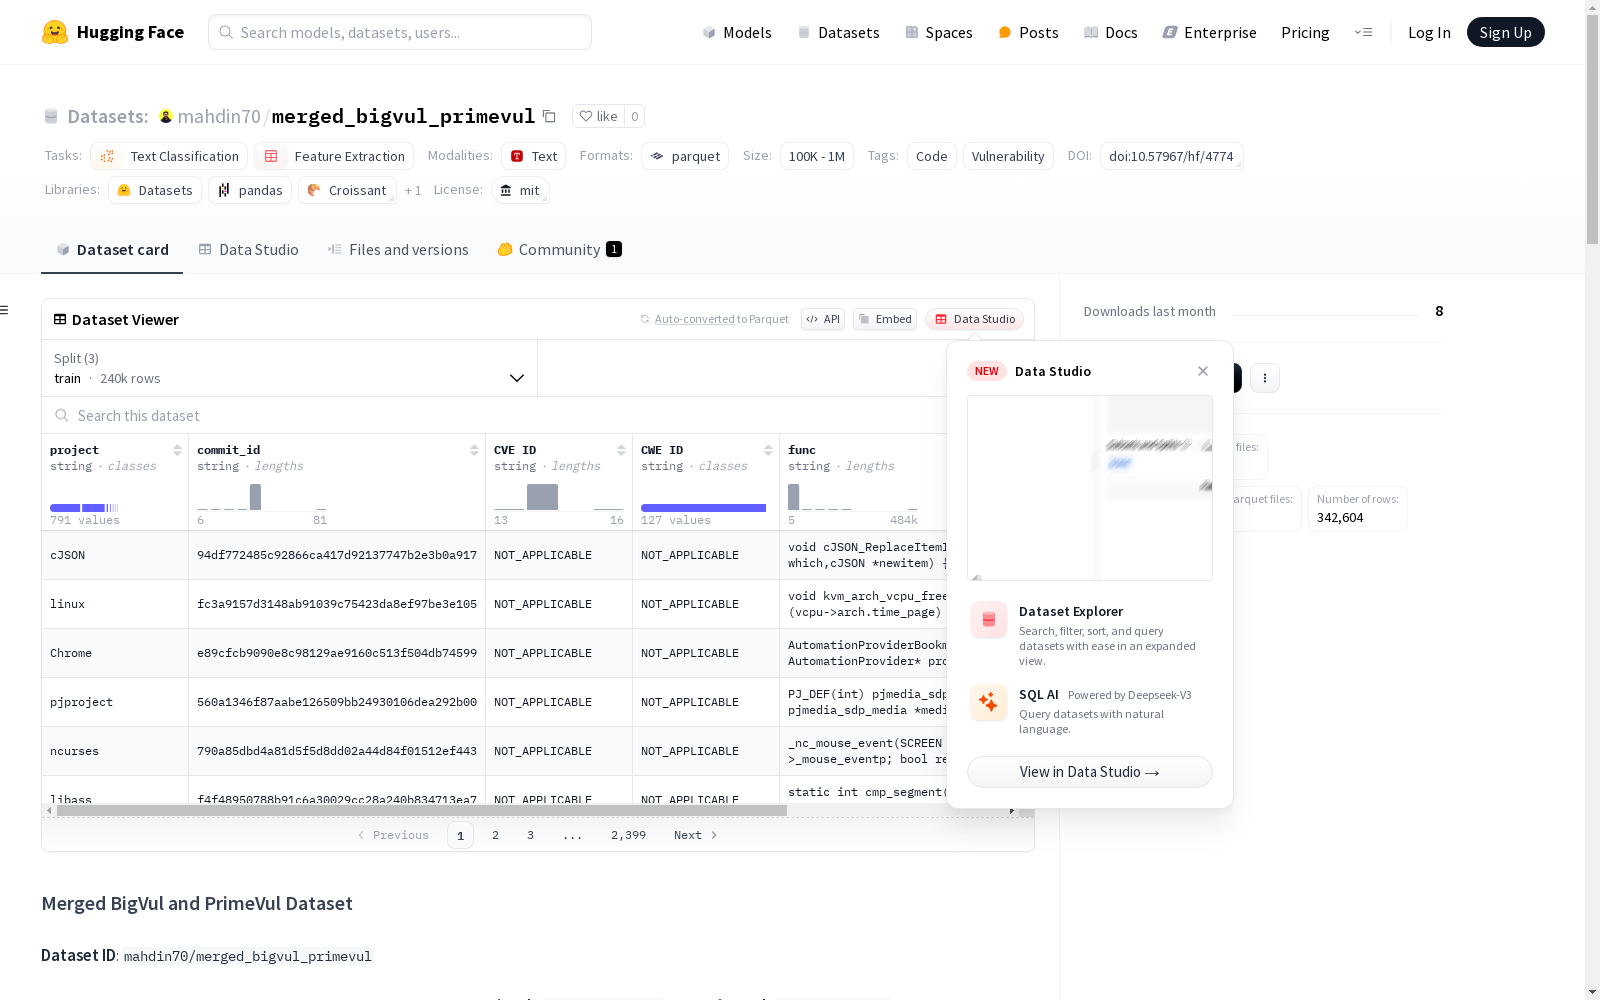
这是一个合并后的BigVul和PrimeVul数据集,包含了来自两个数据源的漏洞数据。它包含有关项目、提交、函数和漏洞的信息,适用于漏洞分析和机器学习任务。数据集经过预处理以确保列名、数据类型和格式的一致性,便于模型微调。
This is a merged dataset of BigVul and PrimeVul, which contains vulnerability data derived from these two source datasets. It includes information related to projects, commits, functions and vulnerabilities, and is suitable for vulnerability analysis and machine learning tasks. The dataset has been preprocessed to ensure consistency in column names, data types and formats, so as to facilitate model fine-tuning.
创建时间:
2025-03-09
搜集汇总
数据集介绍
构建方式
该数据集通过整合BigVul和PrimeVul两个数据源,经过预处理步骤,包括列名统一、数据类型转换、空值和重复记录的移除等,构建出一个适用于漏洞分析及机器学习任务的数据集。数据集包含了项目名称、提交ID、CVE ID、CWE ID、函数代码以及漏洞标签等字段,确保了数据的一致性和质量。
特点
本数据集的特点在于其整合了两个来源的漏洞数据,提供了更全面的漏洞信息。数据集涵盖了项目、提交、函数和漏洞等多个维度,且对CWE ID和CVE ID进行了标准化处理,便于进行特征提取和文本分类任务。此外,数据集的构建考虑了数据的多样性和平衡性,有助于模型的泛化能力。
使用方法
使用该数据集时,用户可以通过HuggingFace的datasets库加载数据集。数据集分为训练集、测试集和验证集,用户可以根据需要选择相应的数据集进行模型的训练和评估。加载后,数据集可以直接用于机器学习模型的训练,也可以进一步进行数据探索和预处理以满足特定任务的需求。
背景与挑战
背景概述
merged_bigvul_primevul数据集是由BigVul和PrimeVul两个数据集合并而成的,旨在为漏洞分析及机器学习任务提供支持。BigVul数据集搜集了来自开源C/C++项目的实际漏洞信息,其研究成果已发表在相关学术会议上。PrimeVul数据集则在此基础上增加了项目特定的详细信息。这两个数据集的合并,保留了关于项目、提交记录、函数以及漏洞的关键信息,并进行了标准化处理,以保持数据的一致性。该数据集自发布以来,在软件安全领域产生了积极的影响,推动了相关研究的进展。
当前挑战
该数据集面临的挑战主要在于:一是如何准确识别并合并两个来源的数据,确保数据的一致性和准确性;二是漏洞数据的标注问题,需要确保每一个漏洞实例都被正确标注,这对于后续的机器学习模型的训练至关重要;三是数据集的规模和多样性对于模型的泛化能力提出了挑战,需要不断扩充数据集并提高数据质量。此外,随着软件漏洞类型的不断演变,数据集的维护和更新也是一大挑战。
常用场景
经典使用场景
在软件安全研究领域,merged_bigvul_primevul数据集被广泛用于细粒度的漏洞检测任务。该数据集通过结合BigVul与PrimeVul两个数据源,提供了丰富的项目、提交记录、函数代码以及漏洞标签等信息,使得研究者能够利用机器学习方法对代码片段是否含有漏洞进行预测。
实际应用
在实际应用中,merged_bigvul_primevul数据集可以被安全工程师和开发人员用于构建自动化的漏洞扫描工具,以提前识别潜在的安全风险,保障软件的安全性。
衍生相关工作
基于该数据集,学术界已衍生出一系列相关工作,包括但不限于漏洞检测模型的构建、评估指标的研究以及代码特征提取方法的发展,这些研究进一步拓宽了软件安全领域的研究视野。
以上内容由遇见数据集搜集并总结生成


