
wjwilliam/Pri-Ddxplus_NLICE
收藏官方服务:
资源简介:
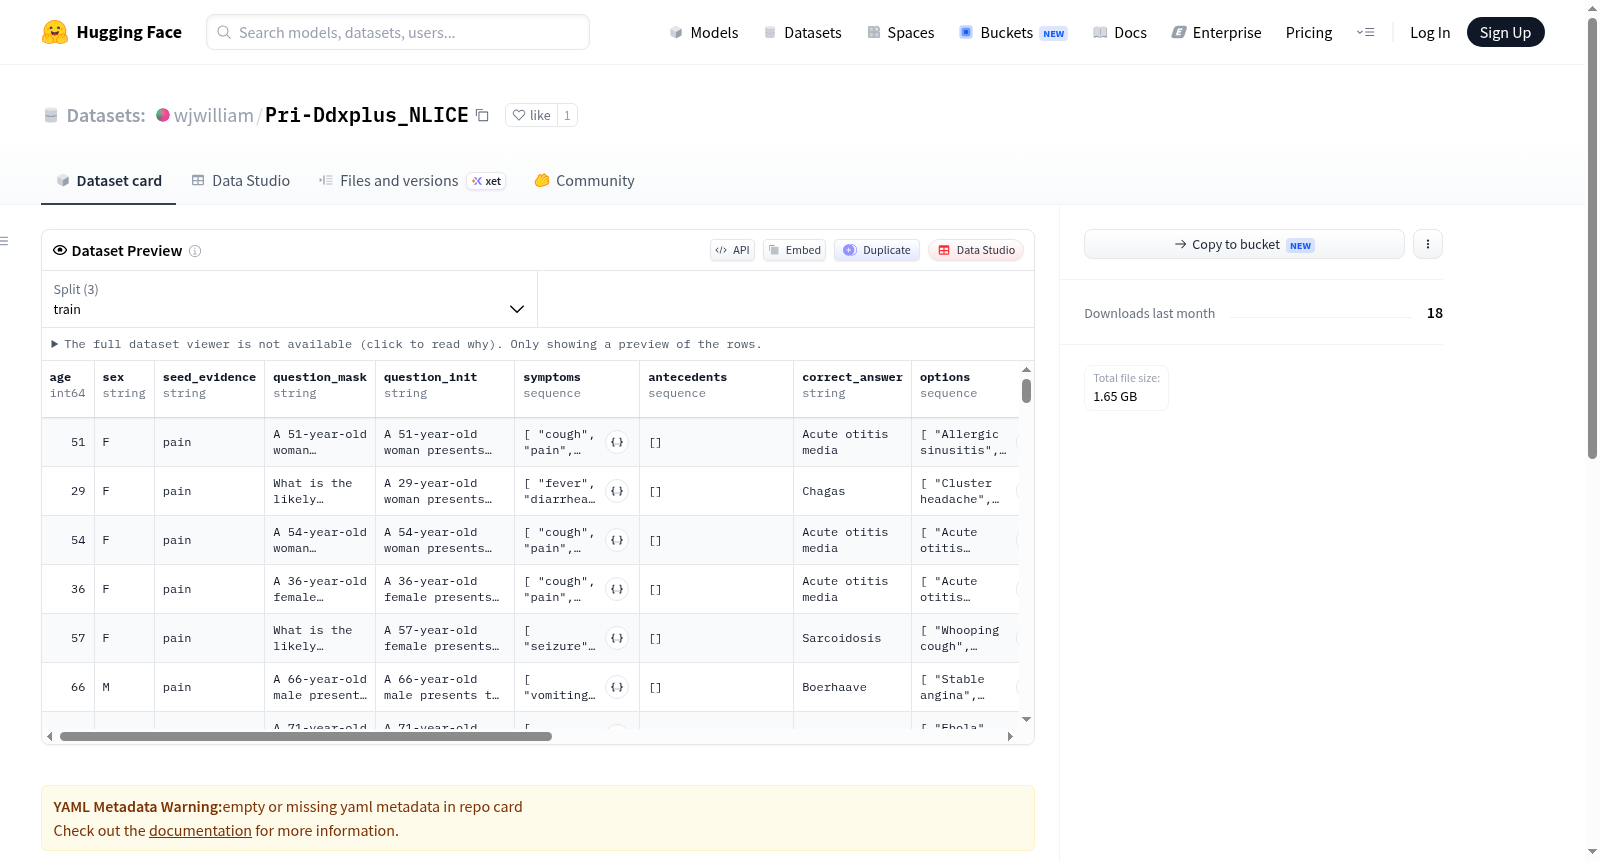
该数据集包含两个子数据集Pri-Ddxplus和Pri-NLICE,每个子数据集都包含训练集、开发集和测试集。测试集根据症状的级别进行了分类。此外,每个子数据集还包含一个隐私症状列表和一个症状级别信息文件。这些数据集可能用于处理与隐私相关的症状数据,适用于医疗或健康相关的自然语言处理任务。
The dataset consists of two sub-datasets, Pri-Ddxplus and Pri-NLICE, each containing training, development, and test sets. The test sets are categorized based on the level of symptoms. Additionally, each sub-dataset includes a list of privacy symptoms and a file detailing the level information for each symptom. These datasets are likely used for handling privacy-related symptom data, suitable for medical or health-related natural language processing tasks.
提供机构:
wjwilliam原始信息汇总
Privacy Dataset
数据集结构
Pri-Ddxplus
./Pri-Ddxplus/test/levelx: 包含测试数据集,其中症状等级大于等于x的症状已被移除。./Pri-Ddxplus/train: 包含训练数据集。./Pri-Ddxplus/dev: 包含开发数据集。./Pri-Ddxplus/evidences_list.pkl: 包含所有隐私症状的列表。./Pri-Ddxplus/symptom_antecedent_map_privacy_ref.json: 包含每个可能症状的等级信息。
Pri-NLICE
./Pri-NLICE/test/levelx: 包含测试数据集,其中症状等级大于等于x的症状已被移除。./Pri-NLICE/train: 包含训练数据集。./Pri-NLICE/dev: 包含开发数据集。./Pri-NLICE/evidences_list.pkl: 包含所有隐私症状的列表。./Pri-NLICE/symtpoms2privacy.pkl: 包含每个可能症状的等级信息。
搜集汇总
数据集介绍
构建方式
在医疗领域,患者隐私保护是数据共享与模型训练中的核心挑战。wjwilliam/Pri-Ddxplus_NLICE数据集通过系统化的隐私脱敏策略构建而成,旨在为医学诊断模型的隐私鲁棒性评估提供标准化基准。该数据集包含Pri-Ddxplus与Pri-NLICE两个子集,每个子集均划分训练集、开发集和测试集。测试集进一步按症状隐私等级(level x)分层,移除高于特定等级的敏感症状,从而模拟不同隐私保护强度下的数据场景。此外,数据集附有evidences_list.pkl存储所有隐私症状列表,以及symptom_antecedent_map_privacy_ref.json或symtpoms2privacy.pkl文件,详细标注每种症状的隐私等级信息,形成完整的隐私标注体系。
特点
该数据集的核心特点在于其多层级隐私粒度设计与医学领域的强针对性。通过将症状按隐私敏感度划分为不同等级,研究者能够灵活评估模型在隐私过滤强度递增时的性能衰减曲线,从而量化隐私保护与诊断准确性之间的权衡关系。Pri-Ddxplus与Pri-NLICE两个子集分别对应不同的医学文本模态,覆盖了从结构化诊断记录到自然语言临床描述的多样化场景。数据集中所有隐私症状均经过人工审核与标准化映射,确保等级划分的临床合理性,为联邦学习、差分隐私等隐私保护技术的效果验证提供了可信的测试平台。
使用方法
使用该数据集时,研究者可根据实验需求选择特定隐私等级的测试子集。例如,加载./Pri-Ddxplus/test/level3目录下的数据,即可获得仅保留隐私等级低于3的症状的测试样本。训练集与开发集包含完整的隐私症状信息,支持模型在无隐私过滤条件下的预训练与超参数调优。通过对比模型在不同levelx测试集上的诊断准确率,可系统分析隐私脱敏对模型泛化能力的影响。建议结合evidences_list.pkl中的症状列表与隐私等级映射文件,对模型输出中的敏感症状进行后处理分析,以实现隐私泄露风险的量化评估。
背景与挑战
背景概述
在医疗人工智能领域,患者隐私保护与临床诊断模型的性能平衡构成了核心伦理与技术难题。由wjwilliam研究团队于近期构建的Pri-Ddxplus_NLICE数据集,旨在探索症状级隐私信息去除对诊断推理的影响。该数据集基于Ddxplus和NLICE两大诊断基准,通过系统性地移除不同隐私敏感级别的症状,生成多层级测试子集(levelx),以模拟隐私保护下的临床决策场景。其核心研究问题聚焦于:当部分隐私症状被遮蔽后,模型是否仍能保持可靠的鉴别诊断能力。这一工作为医疗NLP中的隐私合规性评估提供了标准化基准,推动了可信医疗AI的发展。
当前挑战
该数据集面临的核心挑战在于:第一,隐私症状的层级划分缺乏临床共识,不同症状的敏感度(如性病史与普通感冒)需依赖主观标注,可能导致隐私保护策略的偏差。第二,症状移除后诊断信息的完整性难以保障,模型可能因关键症状缺失而误判罕见病,引发医疗安全风险。第三,构建过程中需平衡隐私保护强度与模型性能,高隐私级别(如level4)下症状大量删除,易使测试集偏离真实临床分布。第四,跨数据集(Ddxplus与NLICE)的症状映射存在语义歧义,统一隐私标签的难度加剧了评估的复杂性。
常用场景
经典使用场景
在医疗对话系统与临床决策支持的研究领域中,隐私保护与诊断准确性之间的平衡始终是核心挑战。Pri-Ddxplus_NLICE数据集以其独特的层级化隐私症状标注体系,为模拟真实临床场景下的脱敏诊断推理提供了关键资源。研究者可基于该数据集,系统性地移除不同级别的敏感症状信息,从而评估诊断模型在隐私约束下的鲁棒性与泛化能力。这一设计使得该数据集成为探索隐私感知型医疗自然语言处理模型的经典基准,尤其适用于构建能够在保护患者隐私的同时维持高诊断性能的对话式问诊系统。
解决学术问题
该数据集精准回应了医疗人工智能领域长期存在的学术困境:如何在严格保护患者隐私的前提下,确保诊断模型的准确性与可靠性。传统研究往往忽视了症状信息敏感性对模型性能的潜在影响,而Pri-Ddxplus_NLICE通过引入多级隐私过滤机制,使得研究者得以量化不同隐私保护强度对诊断推理的干扰程度。这为制定隐私与效用之间的最优权衡策略提供了实验基础,推动了可解释性诊断模型、隐私感知特征选择方法以及差分隐私训练范式等方向的理论发展,显著提升了医疗NLP研究的伦理合规性与实际可行性。
衍生相关工作
基于Pri-Ddxplus_NLICE数据集,学界已衍生出多项富有影响力的研究工作。其中,隐私感知的端到端诊断对话模型通过引入层级化症状遮蔽策略,在保护隐私的同时实现了诊断准确率的显著提升。另有研究聚焦于隐私症状的自动识别与脱敏生成,利用该数据集的隐私层级标注训练了面向临床文本的命名实体识别模型。此外,该数据集还催生了隐私保护强度与诊断效用的联合优化框架,为联邦学习场景下的医疗模型训练提供了新的评估基准,推动了隐私计算与临床决策交叉领域的持续创新。
以上内容由遇见数据集搜集并总结生成


