MikhailVyrodov/goat
收藏资源简介:
--- license: mit task_categories: - question-answering language: - ru tags: - sociology size_categories: - 1K<n<10K dataset_info: - config_name: single_choice_sociology features: - name: input dtype: string - name: A dtype: string - name: B dtype: string - name: C dtype: string - name: D dtype: string - name: answer dtype: class_label: names: '0': A '1': B '2': C '3': D - config_name: multiple_choice_sociology features: - name: input dtype: string - name: answer dtype: string - config_name: word_generation_sociology features: - name: input dtype: string - name: answer dtype: string - config_name: word_generation_literature features: - name: input dtype: string - name: answer dtype: string - config_name: matching_sociology features: - name: input dtype: string - name: answer dtype: string - config_name: matching_literature features: - name: input dtype: string - name: answer dtype: string configs: - config_name: single_choice_sociology data_files: - split: test path: "single_choice/test/sociology_test.csv" - split: dev path: "single_choice/dev/sociology_dev.csv" - config_name: multiple_choice_sociology data_files: - split: test path: "multiple_choice/test/sociology_test.csv" - split: dev path: "multiple_choice/dev/sociology_dev.csv" - config_name: word_generation_sociology data_files: - split: test path: "word_generation/test/sociology_test.csv" - split: dev path: "word_generation/dev/sociology_dev.csv" - config_name: word_generation_literature data_files: - split: test path: "word_generation/test/literature_test.csv" - split: dev path: "word_generation/dev/literature_dev.csv" - config_name: word_generation_sociology data_files: - split: test path: "word_generation/test/sociology_test.csv" - split: dev path: "word_generation/dev/sociology_dev.csv" - config_name: word_generation_literature data_files: - split: test path: "word_generation/test/literature_test.csv" - split: dev path: "word_generation/dev/literature_dev.csv" - config_name: matching_sociology data_files: - split: test path: "matching/test/sociology_test.csv" - split: dev path: "matching/dev/sociology_dev.csv" - config_name: matching_literature data_files: - split: test path: "matching/test/literature_test.csv" - split: dev path: "matching/dev/literature_dev.csv" ---
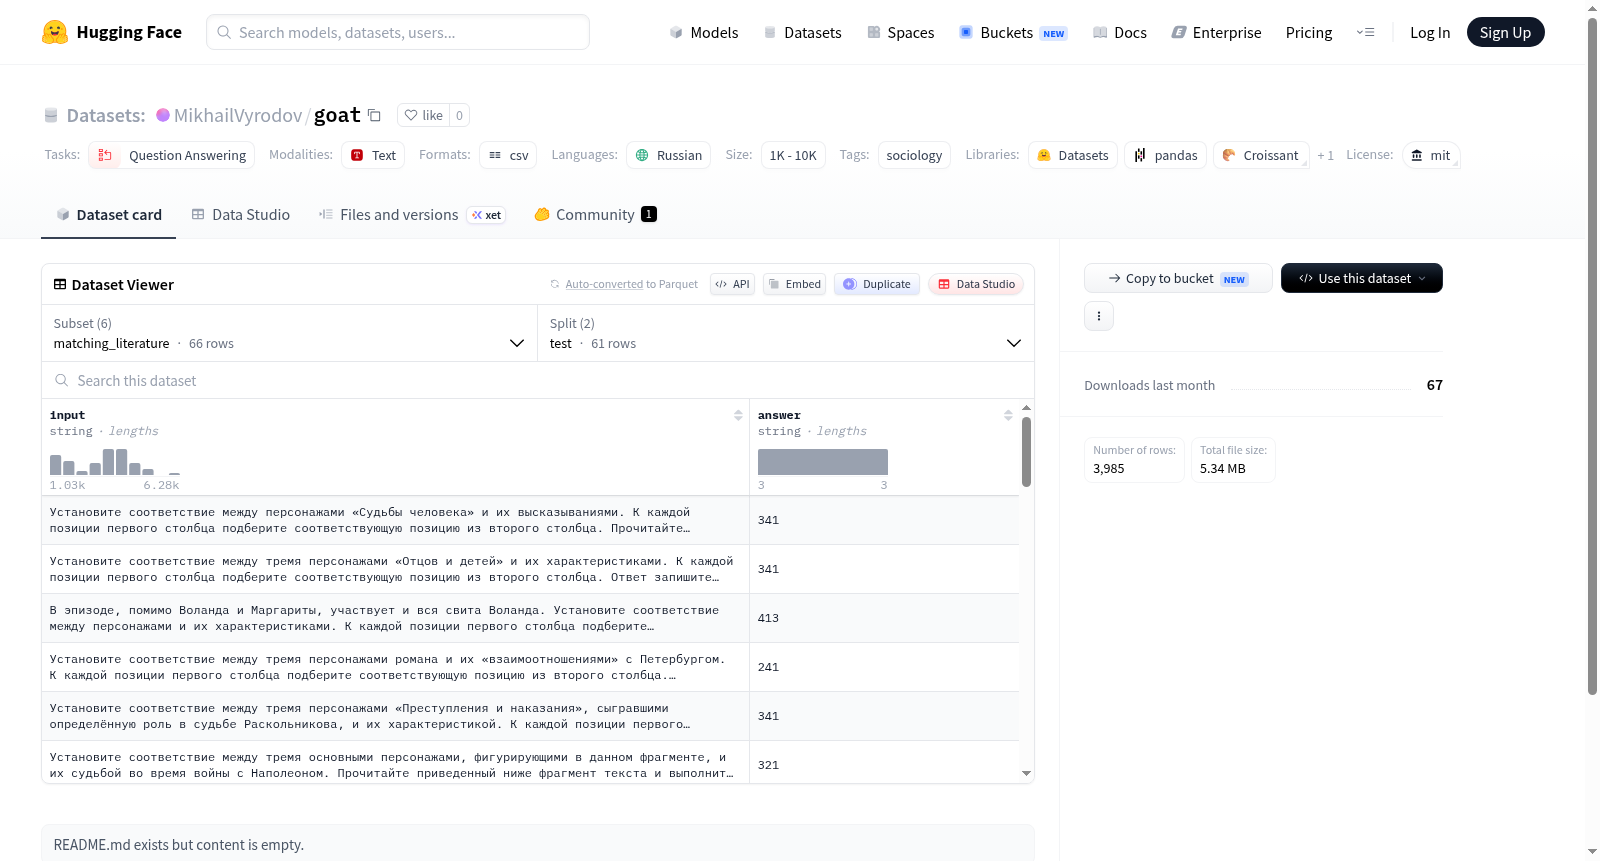
This dataset includes multiple configurations, covering question-answering tasks in the fields of sociology and literature. Specifically, it includes single-choice sociology questions, multiple-choice sociology questions, word generation for sociology and literature questions, and matching sociology and literature questions. The dataset is in Russian and has a size between 1,000 and 10,000 records.
数据集概述
基本信息
- 许可证: MIT
- 任务类别: 问答
- 语言: 俄语
- 标签: 社会学
- 数据集大小: 1K<n<10K
数据集配置
单选题 - 社会学
- 配置名称: single_choice_sociology
- 特征:
input: 字符串A: 字符串B: 字符串C: 字符串D: 字符串answer: 类别标签0: A1: B2: C3: D
- 数据文件:
test: single_choice/test/sociology_test.csvdev: single_choice/dev/sociology_dev.csv
多选题 - 社会学
- 配置名称: multiple_choice_sociology
- 特征:
input: 字符串answer: 字符串
- 数据文件:
test: multiple_choice/test/sociology_test.csvdev: multiple_choice/dev/sociology_dev.csv
词汇生成 - 社会学
- 配置名称: word_generation_sociology
- 特征:
input: 字符串answer: 字符串
- 数据文件:
test: word_generation/test/sociology_test.csvdev: word_generation/dev/sociology_dev.csv
词汇生成 - 文学
- 配置名称: word_generation_literature
- 特征:
input: 字符串answer: 字符串
- 数据文件:
test: word_generation/test/literature_test.csvdev: word_generation/dev/literature_dev.csv
匹配题 - 社会学
- 配置名称: matching_sociology
- 特征:
input: 字符串answer: 字符串
- 数据文件:
test: matching/test/sociology_test.csvdev: matching/dev/sociology_dev.csv
匹配题 - 文学
- 配置名称: matching_literature
- 特征:
input: 字符串answer: 字符串
- 数据文件:
test: matching/test/literature_test.csvdev: matching/dev/literature_dev.csv