遇见数据集

mm-eval/TableVQA-Bench

收藏
Hugging Face2026-05-26 更新2026-05-31 收录
官方服务:

资源简介:

--- dataset_info: features: - name: id dtype: string - name: media list: image - name: messages dtype: string splits: - name: vwtq num_bytes: 138699913 num_examples: 750 - name: vwtq_syn num_bytes: 50271354 num_examples: 250 - name: vtabfact num_bytes: 54083822 num_examples: 250 - name: fintabnetqa num_bytes: 34292847 num_examples: 250 download_size: 277193665 dataset_size: 277347936 configs: - config_name: default data_files: - split: vwtq path: data/vwtq-* - split: vwtq_syn path: data/vwtq_syn-* - split: vtabfact path: data/vtabfact-* - split: fintabnetqa path: data/fintabnetqa-* ---

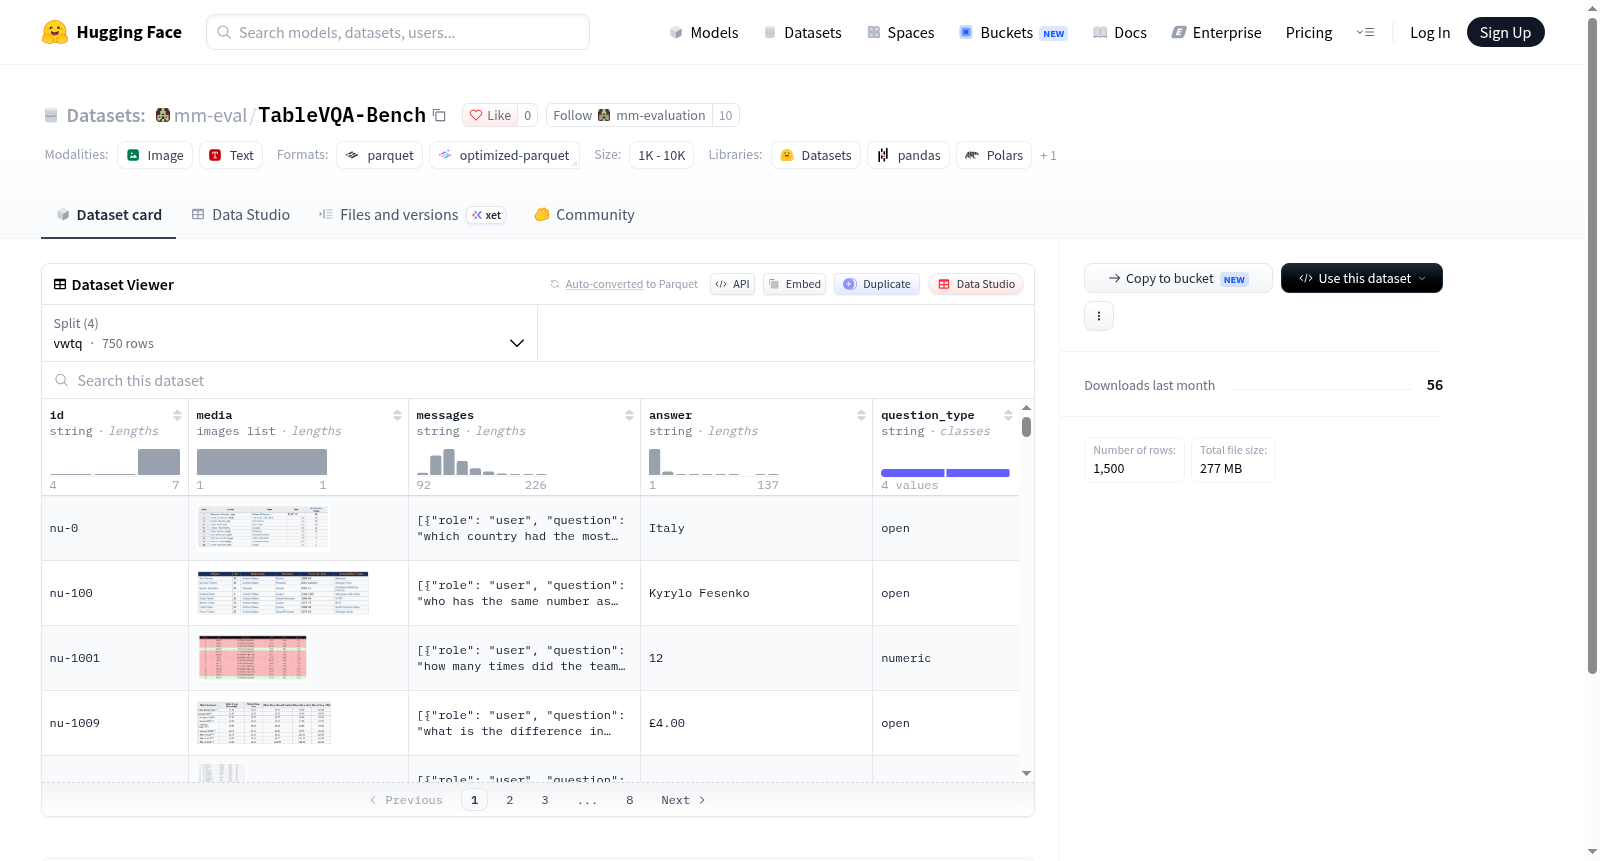
This is a multimodal dataset that includes images and text messages, designed for tasks such as visual question answering, table fact verification, and financial table question answering. The dataset is divided into four subsets: vwtq (visual question answering), vwtq_syn (synthetic visual question answering), vtabfact (table fact verification), and fintabnetqa (financial table question answering), each containing hundreds of examples, with a total data size of approximately 277MB.
提供机构:
mm-eval
搜集汇总
数据集介绍
mm-eval/TableVQA-Bench 数据集图片
构建方式
TableVQA-Bench的构建立足于表格视觉问答任务对多模态推理的迫切需求,通过整合多个已有表格理解数据集,形成统一评测基准。具体而言,该数据集从四个来源采集样本,包括vwtq、vwtq_syn、vtabfact与fintabnetqa,每个分割均保留原始表格图像及其对应问答对,并统一标注问题类型与标准答案。构建过程注重保持各子集原有分布特征,同时以图像列表形式存储表格视觉信息,确保模型可同时处理文本与视觉线索。
使用方法
使用该数据集时,研究者可通过HuggingFace datasets库直接加载默认配置,并依据split参数选择vwtq、vwtq_syn、vtabfact或fintabnetqa子集。加载后,可访问id、media、messages、answer与question_type等字段,将media中的图像与messages中的文本输入多模态模型,生成预测答案并与answer比对。该流程支持零样本评估与微调实验,适用于表格视觉问答系统的基准测试与错误分析。
背景与挑战
背景概述
表格视觉问答(TableVQA)作为多模态理解的关键任务,旨在使模型依据图像化表格回答自然语言问题,其兴起源于现实场景中表格常以图片形式嵌入文档。TableVQA-Bench由研究者于近期构建,整合了四个子集:vwtq、vwtq_syn、vtabfact与fintabnetqa,分别源自WikiTableQuestions、合成数据、TabFact及FinTabNetQA,覆盖多领域表格类型。该基准针对现有模型在表格结构解析与跨模态推理上的不足,提供标准化评估平台,推动了文档智能与视觉语言理解领域的进展,对金融、科研等场景的自动化信息提取具有重要影响力。
当前挑战
该数据集所应对的领域问题在于,表格图像中蕴含复杂的行列结构、合并单元格及多样排版,模型需同时完成视觉识别、结构还原与语义推理,而现有方法在细粒度对齐与数值推理上仍显薄弱。构建过程中的挑战亦不容忽视:从原始表格问答数据转化至图像形式时,需保证问题与答案的视觉可解性,避免因渲染失真导致歧义;各子集来源异构,需统一评估标准并平衡问题类型分布,如vwtq_syn的合成数据与真实场景差异需审慎处理;此外,金融表格的专业术语与密集数值对标注质量提出更高要求,确保答案准确且无歧义。
常用场景
经典使用场景
在多模态表格理解与问答领域,TableVQA-Bench作为一项综合性基准数据集,其经典使用场景聚焦于评估模型对表格图像中结构化信息的解析与推理能力。该数据集汇集了来自维基表格、事实核查及金融报表等多源异构数据,通过图文交织的问答形式,要求模型不仅识别表格中的数值与文本,还需理解行列语义关联及跨模态对齐。典型任务包括基于表格的数值计算、事实性判断与逻辑推理,为视觉语言模型在复杂表格场景下的性能提供了标准化测试平台。
解决学术问题
该数据集有效回应了现有学术研究中表格问答任务模态单一、领域受限的痛点,解决了模型在真实场景下对扫描表格、异构图表的语义理解与推理难题。通过引入多类型表格与多样化问题,它弥合了纯文本表格问答与图像表格理解之间的鸿沟,推动了跨模态表格推理研究的发展。其意义在于为学术界提供了可复现的评测基准,促进了模型在结构化数据理解上的鲁棒性与泛化能力提升。
实际应用
在实际应用层面,TableVQA-Bench为金融报表分析、商业智能文档处理及自动化事实核查等场景提供了技术验证手段。例如,在金融领域,模型可借助该数据集训练对财务报表图像的问答能力,辅助投资者快速提取关键指标;在事实核查中,模型能基于表格图像判断陈述真伪。这些应用显著降低了人工处理表格数据的成本,提升了信息抽取与决策支持的效率。
数据集最近研究
最新研究方向
在表格理解与视觉问答交叉领域,TableVQA-Bench的推出为多模态推理研究注入了新的活力。该数据集整合了VWTQ、VWTQ-Syn、VTABFACT和FinTabNetQA四个子集,覆盖了从合成到真实、从通用到金融的多元化表格场景,推动了模型在跨领域表格问答中的泛化能力研究。近期方向聚焦于利用大规模预训练视觉语言模型进行表格结构解析与语义对齐,特别是在处理复杂表格布局和数值推理任务时,研究者尝试引入符号推理与神经网络的混合架构。同时,该基准与金融文档分析、科学图表理解等热点事件紧密关联,其构建意义在于为评估模型在真实应用中的鲁棒性提供了标准化平台,促进了可解释性与准确性并重的表格问答系统发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务