遇见数据集

SJJ0854/FSFR

收藏
Hugging Face2026-05-11 更新2026-05-31 收录
官方服务:

资源简介:

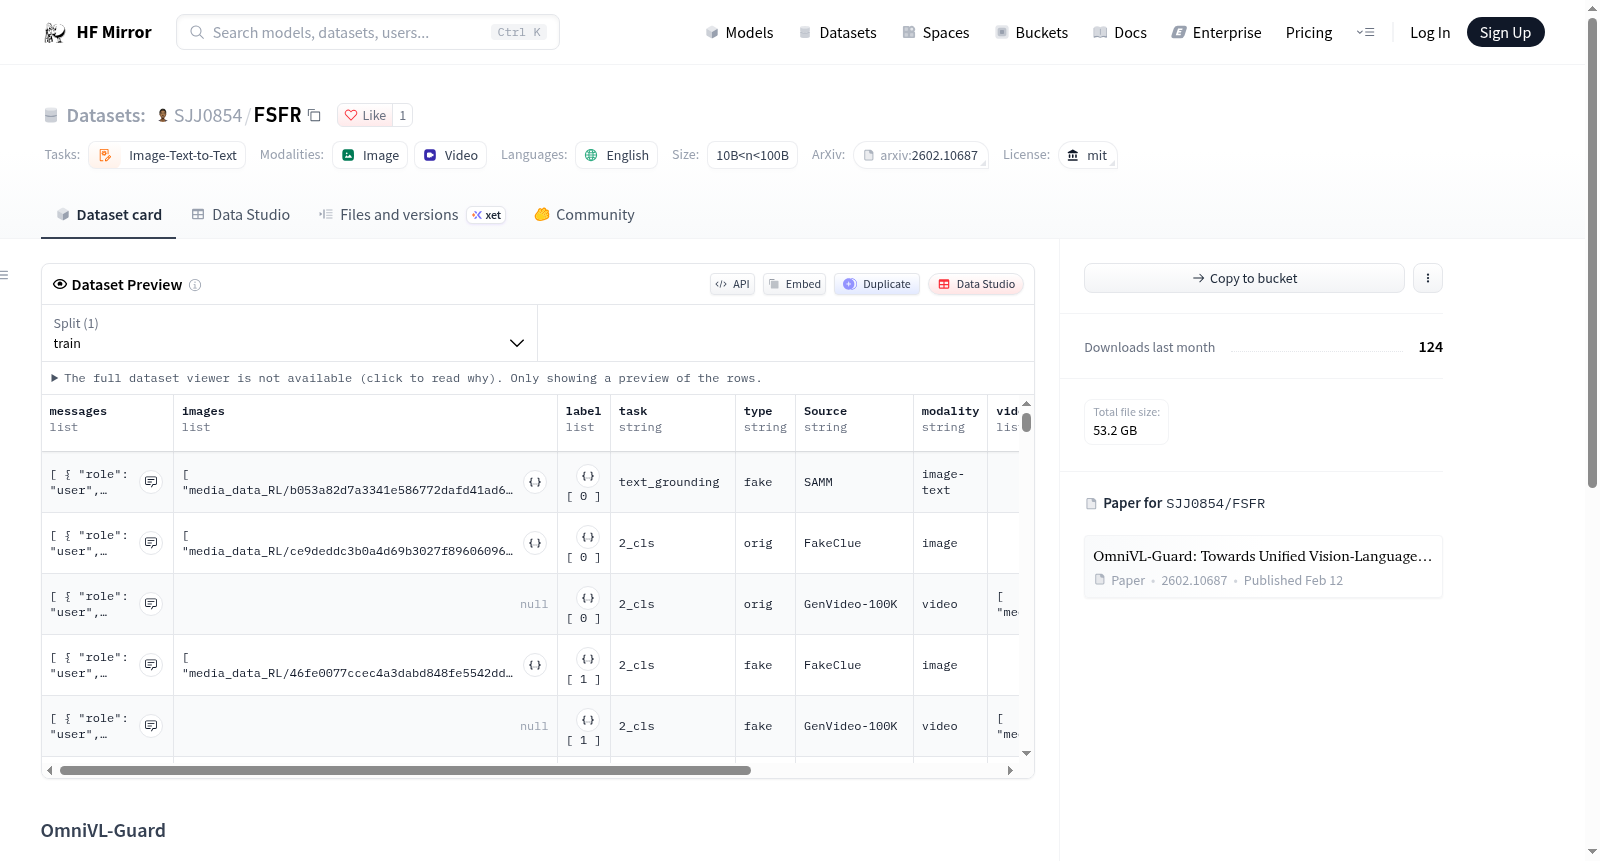
--- license: mit task_categories: - image-text-to-text language: - en pretty_name: OmniVL-Guard Training Data size_categories: - 10B<n<100B --- # OmniVL-Guard <div align="center"> <!-- Keep this line empty for spacing --> [![Paper](https://img.shields.io/badge/Paper-arXiv%3A2602.10687-B31B1B?logo=arxiv&logoColor=white&style=flat-square)](https://arxiv.org/abs/2602.10687) [![Code](https://img.shields.io/badge/Code-GitHub-181717?logo=github&logoColor=white&style=flat-square)](https://github.com/shen8424/OmniVL-Guard) [![Model](https://img.shields.io/badge/Model-OmniVL%E2%80%93Guard%E2%80%932B-FF6F00?logo=huggingface&logoColor=white&style=flat-square)](https://huggingface.co/SJJ0854/OmniVL-Guard-2B) [![Conference](https://img.shields.io/badge/Venue-ICML%202026-4B44CE?logo=academia&logoColor=white&style=flat-square)](https://icml.cc) [![License](https://img.shields.io/badge/License-MIT-green?style=flat-square)](./) </div> ## FSFR — Training Data Training datasets for the OmniVL-Guard safety guard model, accepted at **ICML 2026**. ## Contents | File | Size | Description | |------|------|-------------| | `media_data_RL.zip` | 27.3 GB | Multi-modal RL training data | | `media_data.zip` | 22.1 GB | Multi-modal training data | | `Refined-SFT.jsonl` | 105 MB | Refined SFT examples | | `RL.jsonl` | 38 MB | RL training examples |

This dataset is the training data for the OmniVL-Guard safety guard model, accepted at ICML 2026. It includes multi-modal RL training data, multi-modal training data, refined SFT examples, and RL training examples, designed for image-text-to-text tasks, with a size between 10B and 100B, and in English language.
提供机构:
SJJ0854
搜集汇总
数据集介绍
SJJ0854/FSFR 数据集图片
构建方式
面向视觉语言模型安全防护这一前沿议题,FSFR 数据集以 OmniVL-Guard 安全守卫模型的训练需求为依归,其构建方式体现为多源训练语料的系统聚合。该数据集由多模态训练数据、多模态强化学习训练数据以及精炼监督微调样本和强化学习样本共同组成,分别以 media_data.zip、media_data_RL.zip、Refined-SFT.jsonl 与 RL.jsonl 四种文件形态承载。整体规模落入 10B 至 100B 的区间,任务类别归为 image-text-to-text,语言以英文为主。此种组织方式将不同训练阶段所需的数据资源区分存储,便于按阶段取用与复现,并服务于安全守卫模型从监督微调到强化学习优化的训练流程。
使用方法
围绕 OmniVL-Guard 安全守卫模型的训练与评估,FSFR 的使用方式可沿多阶段学习范式展开。使用者可自 Hugging Face 获取该数据集,解压 media_data.zip 与 media_data_RL.zip 以取得多模态训练数据和多模态强化学习数据,并读取 Refined-SFT.jsonl 与 RL.jsonl 作为结构化训练示例。在 image-text-to-text 任务框架下,Refined-SFT.jsonl 适用于监督微调,RL.jsonl 与 media_data_RL.zip 可用于强化学习优化,media_data.zip 可支撑多模态基础训练或联合训练。MIT 许可为后续研究与工程实践提供开放使用条件,整体流程强调阶段区分与格式适配。
背景与挑战
背景概述
伴随多模态大模型在图文理解与生成任务中的迅速渗透,安全防护数据集的构建成为可信人工智能的重要基石。FSFR作为OmniVL-Guard安全防护模型的训练数据,相关成果被ICML 2026接收,任务类别标注为图文到文本,语料以英文为主,规模处于10B至100B区间。其文件涵盖多模态强化学习训练数据、多模态训练数据、精炼SFT样本与RL样本,并采用MIT许可。详情页未披露具体研究团队与机构,仅提供arXiv论文、GitHub代码及2B模型链接。该数据集的核心研究问题在于为多模态安全防护模型提供规模化、精炼化训练语料,以提升图文到文本的安全判别与风险响应能力,对多模态内容审核与可信AI研究具有基础性支撑意义。
当前挑战
多模态安全防护所面对的核心难题,在于语义风险常潜伏于图文交织的隐式表达、跨模态指代与对抗扰动之中。FSFR需应对的领域问题包括安全审核中低误报与低漏报的权衡、英文语料之外的多语言泛化不足、文化语境差异、隐式违规识别与动态风险演化。构建过程中,多模态数据的采集、清洗与跨模态对齐成本高昂,安全标签的精炼与一致性校验依赖专家知识,SFT与RL样本的配比、负样本与对抗样本构造亦影响模型鲁棒性。规模标注达10B至100B,对存储、算力、隐私合规与版权治理构成持续挑战。
常用场景
经典使用场景
置身于多模态大模型安全治理与可信学习领域,FSFR 数据集面向 OmniVL-Guard 安全护栏模型的训练,汇集多模态强化学习数据、通用多模态训练数据、精炼监督微调示例与强化学习示例。其经典用途在于以图文交织输入为对象,执行图像—文本到文本的安全判别与安全响应生成,用于训练和评估模型识别违规视觉内容、恶意指令、跨模态越狱等风险。依托监督微调与强化学习联合范式,该数据集支撑构建兼具风险识别、拒答边界控制与安全回复能力的护栏模型,服务于多模态内容安全研究的标准流程。
解决学术问题
立足于多模态安全对齐中标注稀缺、风险分布不均衡、图文联合风险难以建模等学术难题,FSFR 提供十亿至百亿词元规模的多模态训练语料,兼容监督微调与强化学习两类范式。它缓解了跨模态安全数据不足对模型训练的制约,促进有害内容检测、安全拒答策略学习、跨模态风险归因与策略优化等研究。其意义在于把文本安全护栏的研究边界拓展至视觉—语言场景,为多模态安全基准构建、对齐算法比较和可复现实验提供规模化数据基础,并推动安全护栏从单一模态向全模态治理演进。
实际应用
在内容平台、生成式人工智能服务与企业级大模型部署场景中,FSFR 可支撑构建前置或后置的多模态安全过滤器。平台能够借助其训练 OmniVL-Guard 类模型,对用户上传的图像与文本组合进行实时审核,识别暴力、色情、仇恨、隐私泄露及越狱提示等风险,并用于模型输出安全复核、风险分级与人机协同审核。该数据集的实用价值体现在降低多模态内容风控成本、提升审核一致性,并为合规部署、内容生态治理和可信人工智能服务提供可扩展的安全防护能力。
数据集最近研究
最新研究方向
伴随多模态大模型加速落地,安全护栏研究正从文本审核迈向图文联合理解与生成场景。FSFR作为OmniVL-Guard的训练数据,汇聚多模态强化学习、精炼监督微调与RL样本,支撑图像—文本到文本任务中的跨模态安全对齐。近期方向聚焦视觉提示注入、图文协同越狱、隐式有害语义检测与拒答,并借偏好优化和可验证奖励提升鲁棒性。该数据集与OmniVL-Guard-2B模型形成数据—模型协同,为多模态红队评测、内容治理及部署风险控制提供训练基底,对推动安全评测标准化和跨模态防御具有基础意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务