遇见数据集

etri-lirs/KoTSQA-v.2.0

收藏
Hugging Face2026-05-29 更新2026-06-21 收录
官方服务:

资源简介:

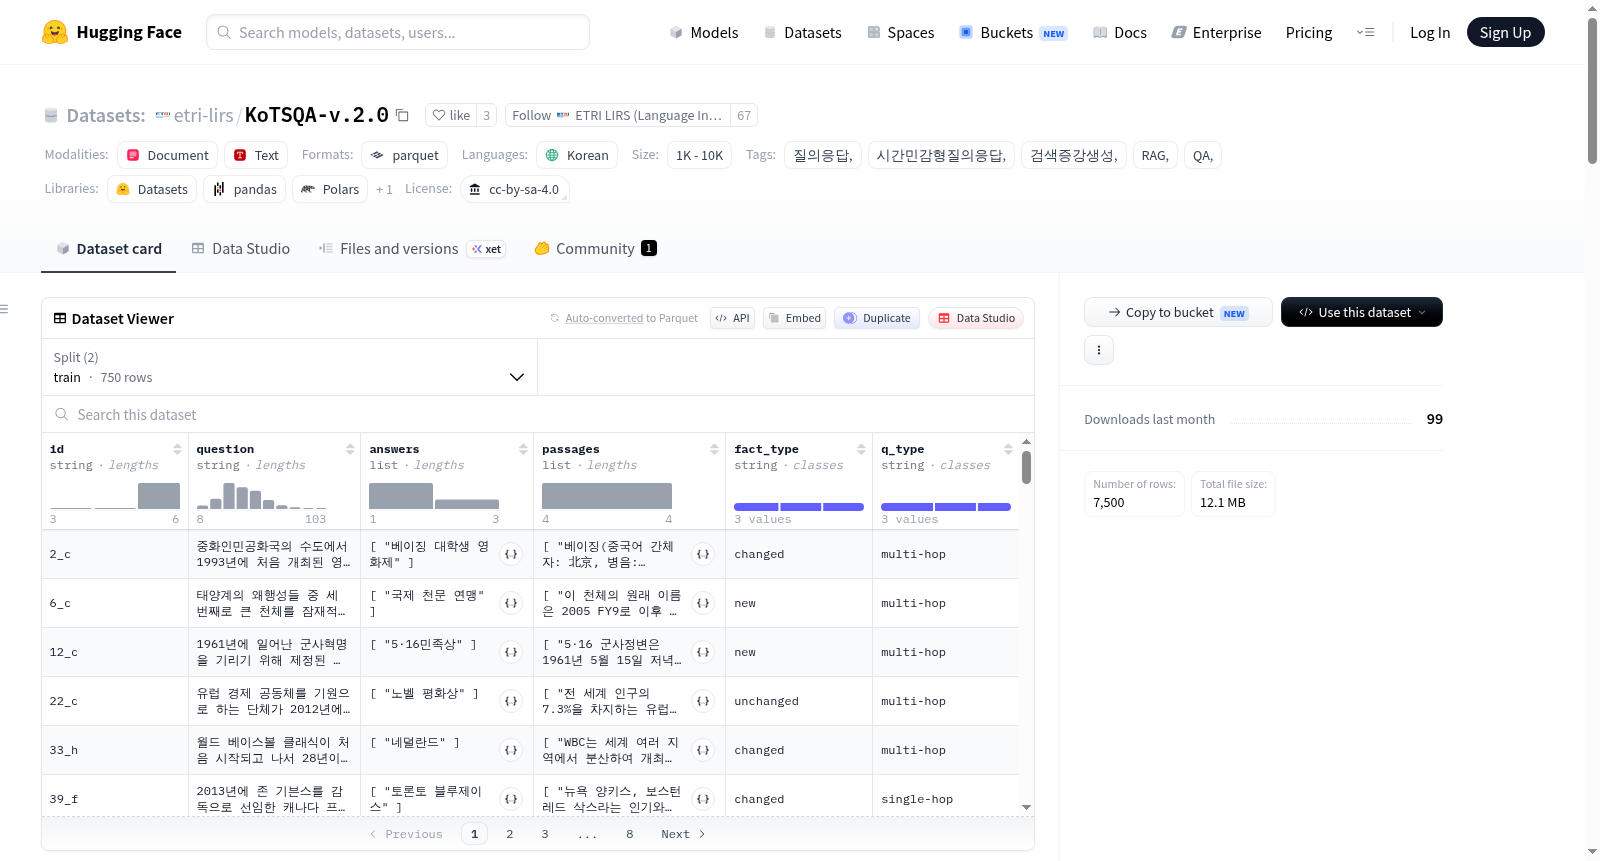
KoTSQA(韩语时间敏感型问答)是一个基准测试数据集,旨在评估大型语言模型(LLM)的内置参数知识与外部检索知识之间的知识冲突问题。该数据集不受LLM数据污染的影响,专注于时间敏感的问答任务,支持对检索增强生成(RAG)等技术的客观评估。它基于韩语维基百科构建,包含多种问题类型(如单跳、多跳、错误前提),并提供了训练和测试部分,其中训练集750条(用于强化学习),测试集6,750条。数据集由韩国电子通信研究院语言智能实验室和Minds Solutions共同策划,语言为韩语,采用CC BY-SA 4.0许可证。

KoTSQA (Korean Time-Sensitive Q&A) is a benchmark that is free from LLM data contamination and can evaluate the knowledge conflict between LLMs internal knowledge and external knowledge. It is a time-sensitive question-answering dataset based on Korean Wikipedia, designed to assess issues like knowledge collision in retrieval-augmented generation (RAG). The dataset includes various question types (e.g., single-hop, multi-hop, false-premise) and is split into train (750 samples) and test (6,750 samples) parts. It was curated by ETRI LIRS and Minds Solutions, funded by a government project, and is licensed under CC BY-SA 4.0.
提供机构:
etri-lirs
搜集汇总
数据集介绍
etri-lirs/KoTSQA-v.2.0 数据集图片
构建方式
KoTSQA-v.2.0 数据集由韩国电子通信研究院语言智能研究室构建,旨在填补时间敏感型问答基准在韩语领域的空白。该数据集基于韩语维基百科语料,通过精心设计的流程从四个相关段落中生成问题,涵盖事实型问答、多跳推理及虚假前提等多样场景。数据集分为训练集和测试集,其中训练集包含750个样本,测试集包含6750个样本,每个样本均标注了知识类型(不变、变化、新增)与问题类型(单跳、多跳、虚假前提),并采用独特的ID体系标识数据来源与结构。
使用方法
该数据集适用于训练与评估韩语大语言模型在时间敏感型问答任务上的表现,尤其擅长检验检索增强生成框架中参数知识与外部知识的冲突解决能力。用户可将数据加载为JSON格式,按ID、问题、答案列表、依据段落等字段解析,结合事实类型与问题类型进行细分实验。推荐用于模型的时间泛化性测试、知识编辑效果验证及持续学习性能评估,亦可作为强化学习训练数据(如利用750条训练样本)来提升模型的时效性响应质量。
背景与挑战
背景概述
KoTSQA-v.2.0是由韩国电子通信研究院语言智能研究室主导,于2025年构建的韩语时间敏感型问答基准数据集。旨在解决大型语言模型在知识更新方面的固有缺陷——由于模型训练存在截止日期,其后产生的全新知识无法被参数化存储。该数据集聚焦于评估检索增强生成(RAG)技术中参数化知识与检索所得外部知识之间的冲突问题,填补了韩语领域在时间敏感型问答评估方面的空白。其影响力主要体现在为RAG、知识编辑及持续学习等前沿技术提供了标准化的评测平台,尤其关注数据污染对模型评估的干扰,为语言模型在动态知识环境下的鲁棒性研究奠定了重要基础。
当前挑战
该数据集面临的核心挑战包括:领域问题层面,需解决大语言模型因训练数据时间滞后而产生的知识时效性难题,以及参数化知识(如模型内嵌常识)与检索引入的外部知识(如维基百科实时条目)之间的冲突评估。现有基准多聚焦英语且易受数据污染影响,韩语环境下的同类评测几乎空白。构建过程中,研究团队需克服数据生成的复杂性——需基于维基百科构建多类型事实知识(不变、变迁、新增),并设计单跳、多跳及错误前提三种问题类型,确保测试集(6750条)与训练集(750条)的分布均衡与场景覆盖,同时严格规避模型在训练阶段可能接触过的数据,以保持基准的客观性与可信度。
常用场景
经典使用场景
在大型语言模型(LLM)飞速演进的背景下,知识的时效性成为制约其实际应用的关键瓶颈。KoTSQA-v.2.0作为一种专为韩语设计的时间敏感型问答基准数据集,凭借其独特的构造逻辑,精准聚焦于LLM在时间推移下面临的知识更新困境。该数据集由韩国电子通信研究院精心打造,通过区分‘未变’、‘已变’与‘新增’三种知识类型,并引入单跳、多跳及虚假前提等多样化问题形态,为评估模型在实时信息检索与融合过程中的表现提供了标准化的测试平台。研究者可借助此数据集,系统性地检验模型在应对动态知识变化时的适应能力与推理稳健性。
解决学术问题
KoTSQA-v.2.0的诞生,旨在填补现有学术研究中两个关键空白:其一,多数时间敏感型问答数据集局限于英文环境,缺乏对非英语语言模型的普适性覆盖;其二,现有基准难以甄别LLM因训练数据污染而产生的知识偏倚。该数据集通过严格基于韩语维基百科构建,并刻意避免与主流LLM训练语料的重叠,从而有效规避数据泄露问题。它深入解构了参数化知识(模型内置)与非参数化知识(外部检索)之间的冲突现象,为检索增强生成(RAG)、知识编辑与持续学习等前沿技术提供了客观、无偏的评估基准,推动了多语言时间敏感问答研究的理论深化。
实际应用
在实际产业应用中,KoTSQA-v.2.0展现出巨大的部署价值,尤其适用于需要实时更新知识的韩语智能服务场景。例如,在新闻摘要生成、法律条文动态解读、金融政策问答以及医疗信息更新等领域,该数据集可帮助开发者精准评测LLM是否能有效整合最新外部信息,避免输出过时或矛盾的答案。通过模拟用户在时间断层后提出的新问题,KoTSQA-v.2.0成为检验RAG系统在真实世界知识演化中鲁棒性的关键工具,进而助力企业构建更加可靠、可信的对话式人工智能产品。
数据集最近研究
最新研究方向
KoTSQA-v.2.0作为首个韩语时间敏感型问答基准,聚焦于评估大语言模型在时间维度上的知识更新能力与内外部知识冲突问题。其核心创新在于通过细致划分'不变、变化、新增'三种知识事实类型,并引入虚假前提问题,系统性地检测模型对知识时效性的敏感度。该数据集在检索增强生成(RAG)研究范式下具有重要价值,不仅为韩语NLP领域提供了对抗数据污染的评估工具,更通过递归RAG等前沿方法验证了知识冲突解决策略的有效性,推动了多语言时间敏感问答评估体系的完善。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务