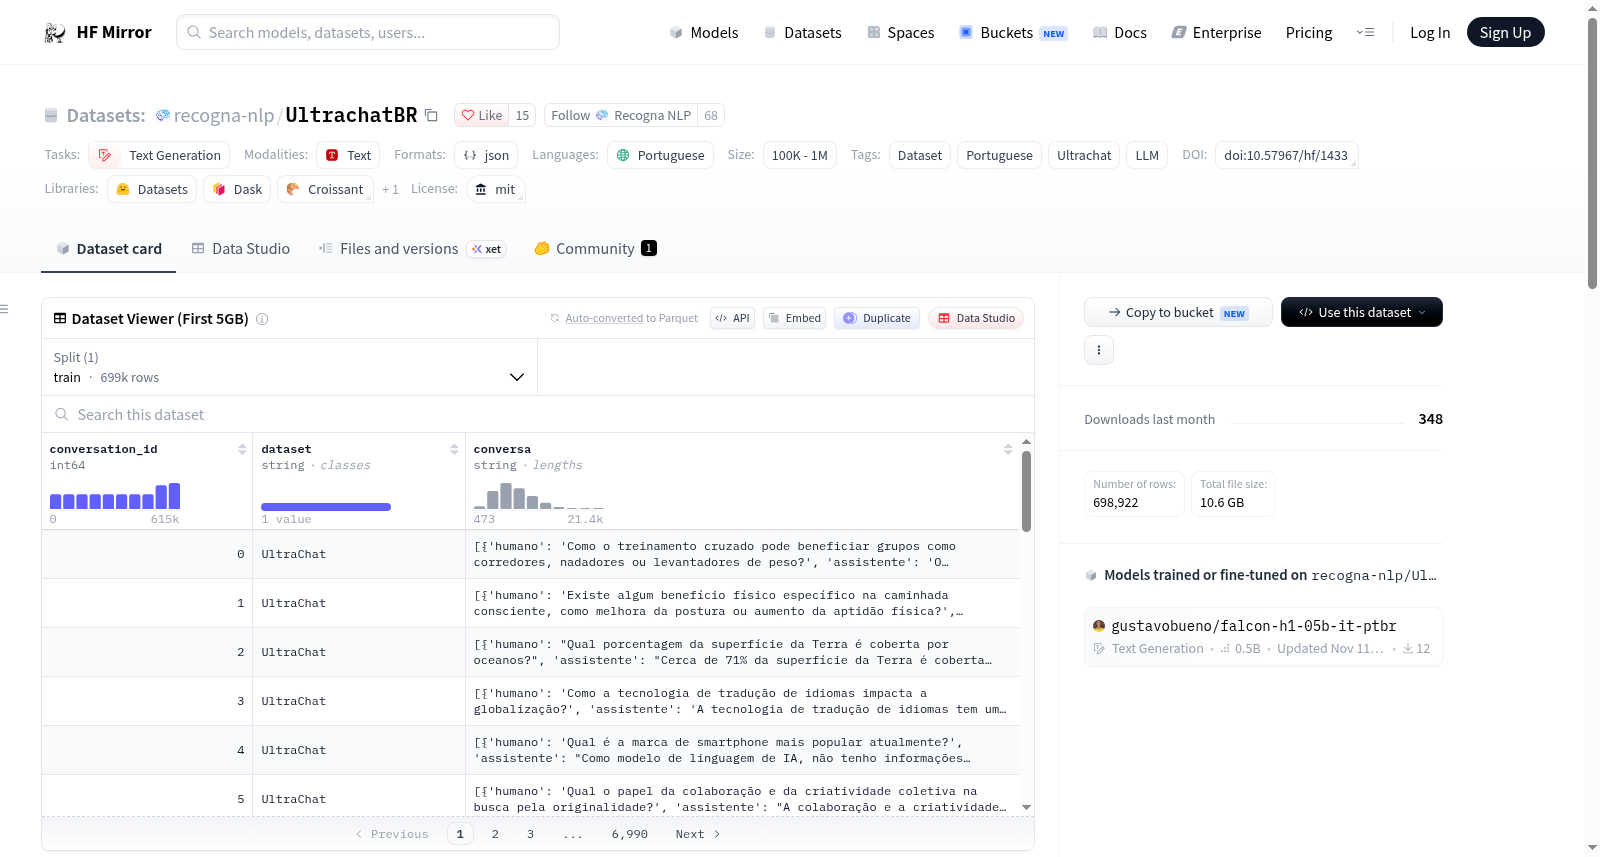
recogna-nlp/UltrachatBR
收藏资源简介:
--- license: mit language: - pt task_categories: - conversational - text-generation tags: - Dataset - Portuguese - Ultrachat - LLM size_categories: - 1M<n<10M --- # UltrachatBR: Um Dataset em Português baseado no Ultrachat O UltrachatBR é uma versão em português do conhecido dataset [Ultrachat](https://huggingface.co/datasets/stingning/ultrachat), originalmente desenvolvido para o idioma inglês. Este projeto visa disponibilizar uma vasta coleção de diálogos traduzidos para o português, ampliando assim o acesso a recursos de processamento de linguagem natural para a comunidade de língua portuguesa. ## Processo de Tradução O processo de tradução foi realizado utilizando a API do Google Tradutor, uma ferramenta poderosa para a tradução automática. Ao aplicar essa tecnologia, conseguimos traduzir mais de 1.4 milhão de amostras de diálogos do Ultrachat original para o português. Este passo foi crucial para garantir que os modelos de processamento de linguagem natural tenham um conjunto de dados significativo no idioma português. ## Desafios Enfrentados Durante a tradução, identificamos algumas palavras-chave essenciais, como 'human' e 'assistant', que não foram traduzidas, pois são termos específicos do dataset Ultrachat. Para garantir a coesão e consistência, realizamos um pré-processamento adicional, substituindo essas palavras por suas equivalentes em português, resultando em "humano" e "assistente". ## Pré-processamento Além da tradução, realizamos um cuidadoso pré-processamento dos dados para garantir a qualidade e a consistência. Isso incluiu a limpeza de dados irrelevantes, tratamento de valores nulos e a normalização de termos específicos. ## Tamanho do Dataset O UltrachatBR abrange um impressionante conjunto de 1.453.026 amostras de diálogos em português. Essa riqueza de dados oferece uma base sólida para o treinamento e avaliação de modelos de processamento de linguagem natural voltados para o público de língua portuguesa. ## Como Citar Se você utilizar o UltrachatBR em suas pesquisas, por favor, cite o dataset da seguinte maneira: ``` @misc{ultrachatBr, author = {Garcia, Gabriel Lino and Paiola, Pedro Henrique and Frediani, João Otávio and Morelli, Luis Henrique and Correia, João Vitor Mariano and Jodas, Danilo Samuel and Junior, Arnaldo Candido and Penteado, Bruno Elias and Guilherme, Ivan Rizzo and Papa, João Paulo}, title = {UltrachatBR: Um Dataset em Português baseado no Ultrachat}, year = {2023}, doi = {10.57967/hf/1433}, publisher = {Hugging Face}, url = {https://huggingface.co/datasets/recogna-nlp/UltrachatBR} } ``` Esperamos que o UltrachatBR seja uma valiosa contribuição para a comunidade de processamento de linguagem natural em língua portuguesa. Fique à vontade para explorar e utilizar este recurso em seus projetos!
UltrachatBR: Um Dataset em Português baseado no Ultrachat
O UltrachatBR é uma versão em português do dataset Ultrachat, originalmente desenvolvido para o idioma inglês. Este projeto visa disponibilizar uma vasta coleção de diálogos traduzidos para o português, ampliando o acesso a recursos de processamento de linguagem natural para a comunidade de língua portuguesa.
Processo de Tradução
O processo de tradução foi realizado utilizando a API do Google Tradutor, traduzindo mais de 1.4 milhão de amostras de diálogos do Ultrachat original para o português.
Desafios Enfrentados
Durante a tradução, algumas palavras-chave essenciais, como human e assistant, não foram traduzidas e foram substituídas por suas equivalentes em português, resultando em "humano" e "assistente".
Pré-processamento
Além da tradução, realizamos um cuidadoso pré-processamento dos dados, incluindo a limpeza de dados irrelevantes, tratamento de valores nulos e normalização de termos específicos.
Tamanho do Dataset
O UltrachatBR abrange 1.453.026 amostras de diálogos em português, oferecendo uma base sólida para o treinamento e avaliação de modelos de processamento de linguagem natural voltados para o público de língua portuguesa.
Como Citar
Se você utilizar o UltrachatBR em suas pesquisas, por favor, cite o dataset da seguinte maneira:
@misc{ultrachatBr, author = {Garcia, Gabriel Lino and Paiola, Pedro Henrique and Frediani, João Otávio and Morelli, Luis Henrique and Correia, João Vitor Mariano and Jodas, Danilo Samuel and Junior, Arnaldo Candido and Penteado, Bruno Elias and Guilherme, Ivan Rizzo and Papa, João Paulo}, title = {UltrachatBR: Um Dataset em Português baseado no Ultrachat}, year = {2023}, doi = {10.57967/hf/1433}, publisher = {Hugging Face}, url = {https://huggingface.co/datasets/recogna-nlp/UltrachatBR} }