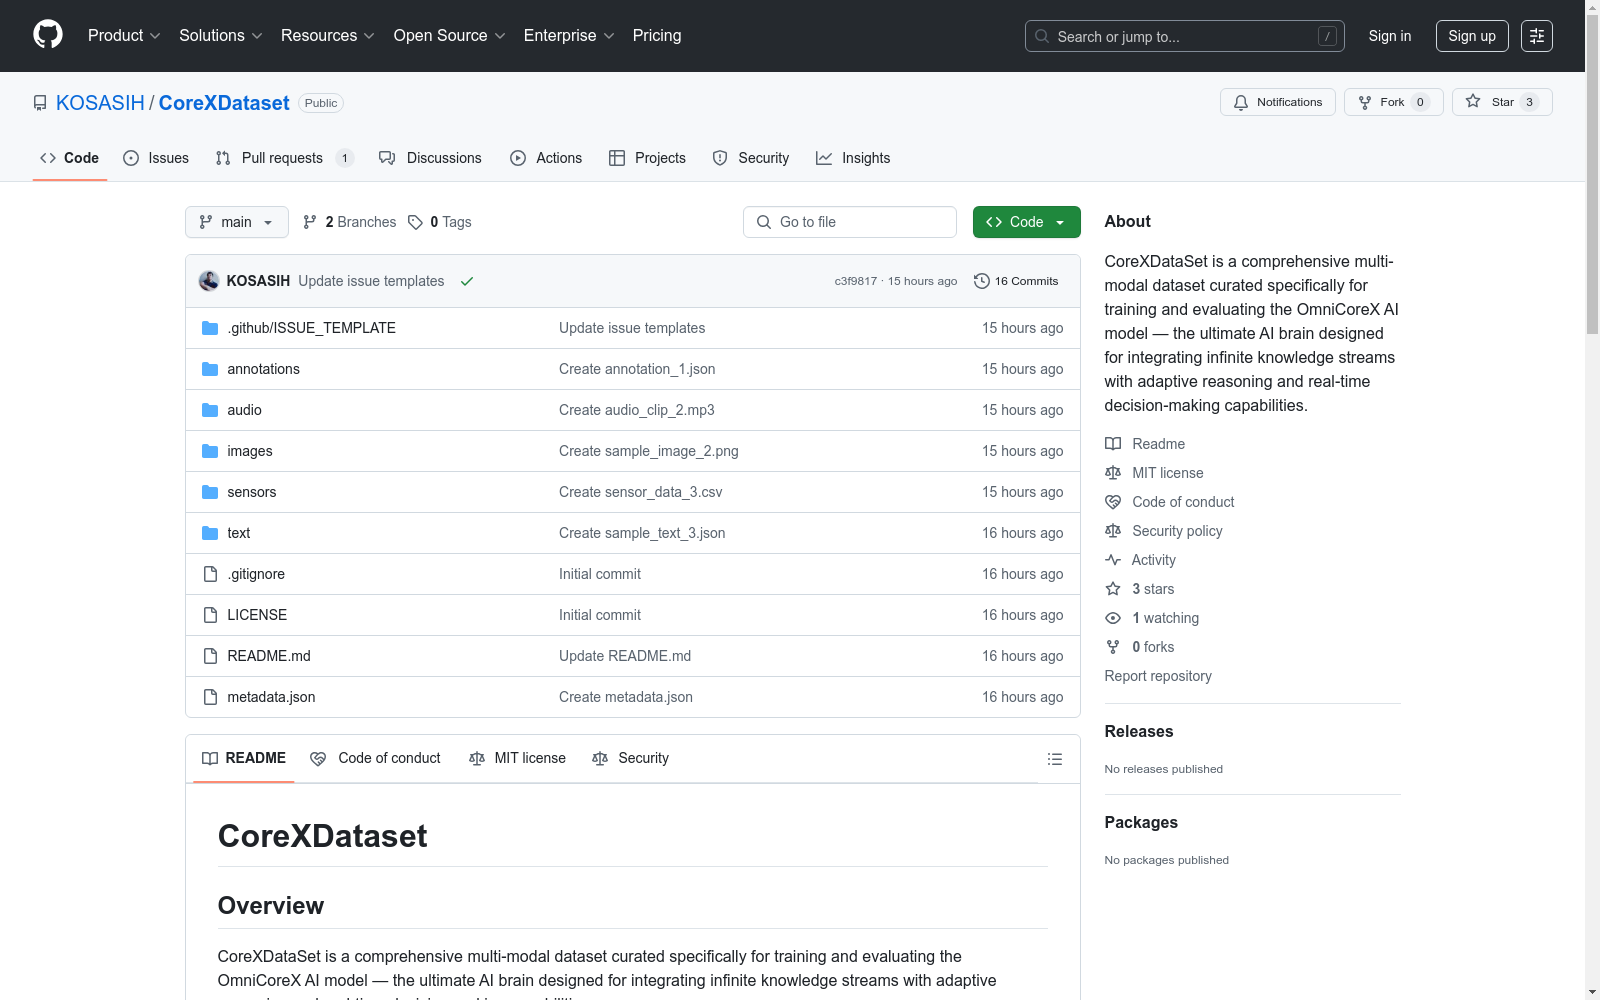
CoreXDataset
收藏资源简介:
CoreXDataSet是一个全面的多模态数据集,专门用于训练和评估OmniCoreX AI模型——一个旨在整合无限知识流、具有自适应推理和实时决策能力的终极AI大脑。该数据集包括文本、图像、传感器读数、音频等多种数据模态,使OmniCoreX能够学习跨模态表示,并在各种现实场景中进行高级多流推理。
CoreXDataSet is a comprehensive multimodal dataset specifically designed for training and evaluating the OmniCoreX AI model—an ultimate AI brain aimed at integrating infinite knowledge streams and equipped with adaptive reasoning and real-time decision-making capabilities. This dataset comprises multiple data modalities including text, images, sensor readings, audio and more, enabling OmniCoreX to learn cross-modal representations and perform advanced multi-stream reasoning across various real-world scenarios.
CoreXDataset 数据集概述
数据集简介
CoreXDataSet 是一个专为训练和评估 OmniCoreX AI 模型而设计的综合性多模态数据集。该数据集旨在支持无限知识流的集成,具备自适应推理和实时决策能力。
数据内容
- 文本:包含百科全书知识、技术文档和对话数据等丰富语料。
- 图像:涵盖自然、城市景观和技术等多个领域的高分辨率图像。
- 传感器数据:来自物联网设备、机器人和移动平台的时间序列传感器记录。
- 音频:用于音频模式理解和集成的语音和环境音频片段。
- 标签/注释:监督学习任务所需的元数据和注释。
数据集结构
CoreXDataSet/ ├── metadata.json # 数据集样本的描述和引用 ├── text/ # 包含文本文件或JSON文档的目录 ├── images/ # 包含JPEG/PNG格式图像的目录 ├── sensors/ # 传感器数据序列的CSV或二进制文件 ├── audio/ # WAV/MP3格式的音频片段 └── annotations/ # 监督任务的可选注释
许可证
CoreXDataSet 采用 Creative Commons Attribution-NonCommercial 4.0 International License (CC BY-NC 4.0) 发布。
使用方法
数据访问
下载并解压 CoreXDataSet 存档文件。使用提供的元数据文件通过 OmniCoreX 数据加载工具高效索引和加载样本。
集成
CoreXDataSet 设计用于与 OmniCoreX 训练流程和模型架构无缝集成。可使用 OmniCoreX 存储库中包含的数据集模块和数据加载器。
引用
如需在研究中引用 CoreXDataSet,请使用以下格式:
@dataset{corexdataset2024, title={CoreXDataSet: Multi-Modal Dataset for OmniCoreX AI}, author={Kosasih, Team}, year={2024}, publisher={OmniCoreX Initiative}, url={https://github.com/KOSASIH/CoreXDataSet} }
贡献
欢迎通过新增模态、扩展注释和改进质量等方式为 CoreXDataSet 做出贡献。请参阅数据集存储库中的 CONTRIBUTING.md 文件了解指南。
联系方式
如有关于 CoreXDataSet 的咨询、问题或支持需求,请联系:
- 电子邮件:support@omnicorex.ai
- GitHub:https://github.com/KOSASIH/CoreXDataSet