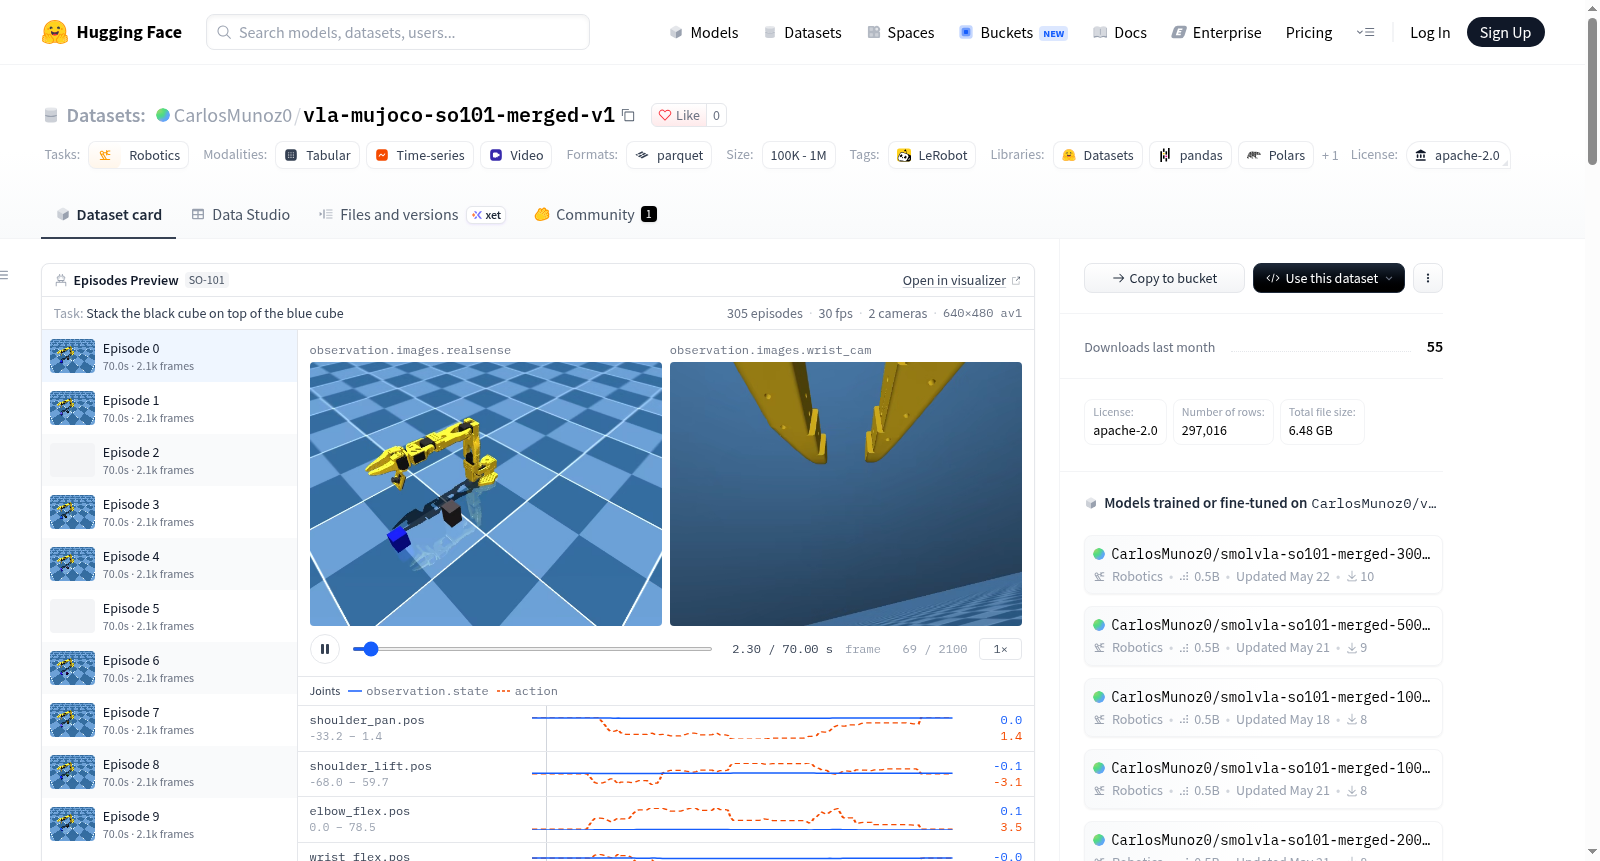
CarlosMunoz0/vla-mujoco-so101-merged-v1
收藏资源简介:
--- license: apache-2.0 task_categories: - robotics tags: - LeRobot configs: - config_name: default data_files: data/*/*.parquet --- This dataset was created using [LeRobot](https://github.com/huggingface/lerobot). <a class="flex" href="https://huggingface.co/spaces/lerobot/visualize_dataset?path=CarlosMunoz0/vla-mujoco-so101-merged-v1"> <img class="block dark:hidden" src="https://huggingface.co/datasets/huggingface/badges/resolve/main/visualize-this-dataset-xl.svg"/> <img class="hidden dark:block" src="https://huggingface.co/datasets/huggingface/badges/resolve/main/visualize-this-dataset-xl-dark.svg"/> </a> ## Dataset Description - **Homepage:** [More Information Needed] - **Paper:** [More Information Needed] - **License:** apache-2.0 ## Dataset Structure [meta/info.json](meta/info.json): ```json { "codebase_version": "v3.0", "robot_type": "so101_mujoco", "total_episodes": 305, "total_frames": 297016, "total_tasks": 4, "chunks_size": 1000, "data_files_size_in_mb": 100, "video_files_size_in_mb": 200, "fps": 30, "splits": { "train": "0:305" }, "data_path": "data/chunk-{chunk_index:03d}/file-{file_index:03d}.parquet", "video_path": "videos/{video_key}/chunk-{chunk_index:03d}/file-{file_index:03d}.mp4", "features": { "action": { "dtype": "float32", "shape": [ 6 ], "names": [ "shoulder_pan.pos", "shoulder_lift.pos", "elbow_flex.pos", "wrist_flex.pos", "wrist_roll.pos", "gripper.pos" ] }, "observation.state": { "dtype": "float32", "shape": [ 6 ], "names": [ "shoulder_pan.pos", "shoulder_lift.pos", "elbow_flex.pos", "wrist_flex.pos", "wrist_roll.pos", "gripper.pos" ] }, "observation.images.realsense": { "dtype": "video", "shape": [ 480, 640, 3 ], "names": [ "height", "width", "channels" ], "info": { "video.height": 480, "video.width": 640, "video.codec": "av1", "video.pix_fmt": "yuv420p", "video.is_depth_map": false, "video.fps": 30, "video.channels": 3, "has_audio": false } }, "observation.images.wrist_cam": { "dtype": "video", "shape": [ 480, 640, 3 ], "names": [ "height", "width", "channels" ], "info": { "video.height": 480, "video.width": 640, "video.codec": "av1", "video.pix_fmt": "yuv420p", "video.is_depth_map": false, "video.fps": 30, "video.channels": 3, "has_audio": false } }, "timestamp": { "dtype": "float32", "shape": [ 1 ], "names": null }, "frame_index": { "dtype": "int64", "shape": [ 1 ], "names": null }, "episode_index": { "dtype": "int64", "shape": [ 1 ], "names": null }, "index": { "dtype": "int64", "shape": [ 1 ], "names": null }, "task_index": { "dtype": "int64", "shape": [ 1 ], "names": null } } } ``` ## Citation **BibTeX:** ```bibtex [More Information Needed] ```
This dataset is created using the LeRobot framework in the robotics domain, specifically for the so101_mujoco robot type. It contains 305 episodes with a total of 297016 frames, covering 4 distinct tasks. The data is stored in parquet format, with a total data file size of 100MB and video file size of 200MB. Dataset features include: action as a 6-dimensional float32 array representing robot joint positions (e.g., shoulder pan, shoulder lift, elbow flex, wrist flex, wrist roll, and gripper positions); observation.state as a 6-dimensional float32 array reflecting real-time joint positions; image observations from two cameras: realsense and wrist_cam, both providing RGB video at 480x640 resolution with 3 channels, a frame rate of 30fps, using AV1 codec; additionally, metadata such as timestamp, frame index, episode index, index, and task index are included. All data is allocated for training splits, suitable for research tasks like robot control and vision-language-action (VLA) applications.