hsila/chem-nq
收藏资源简介:
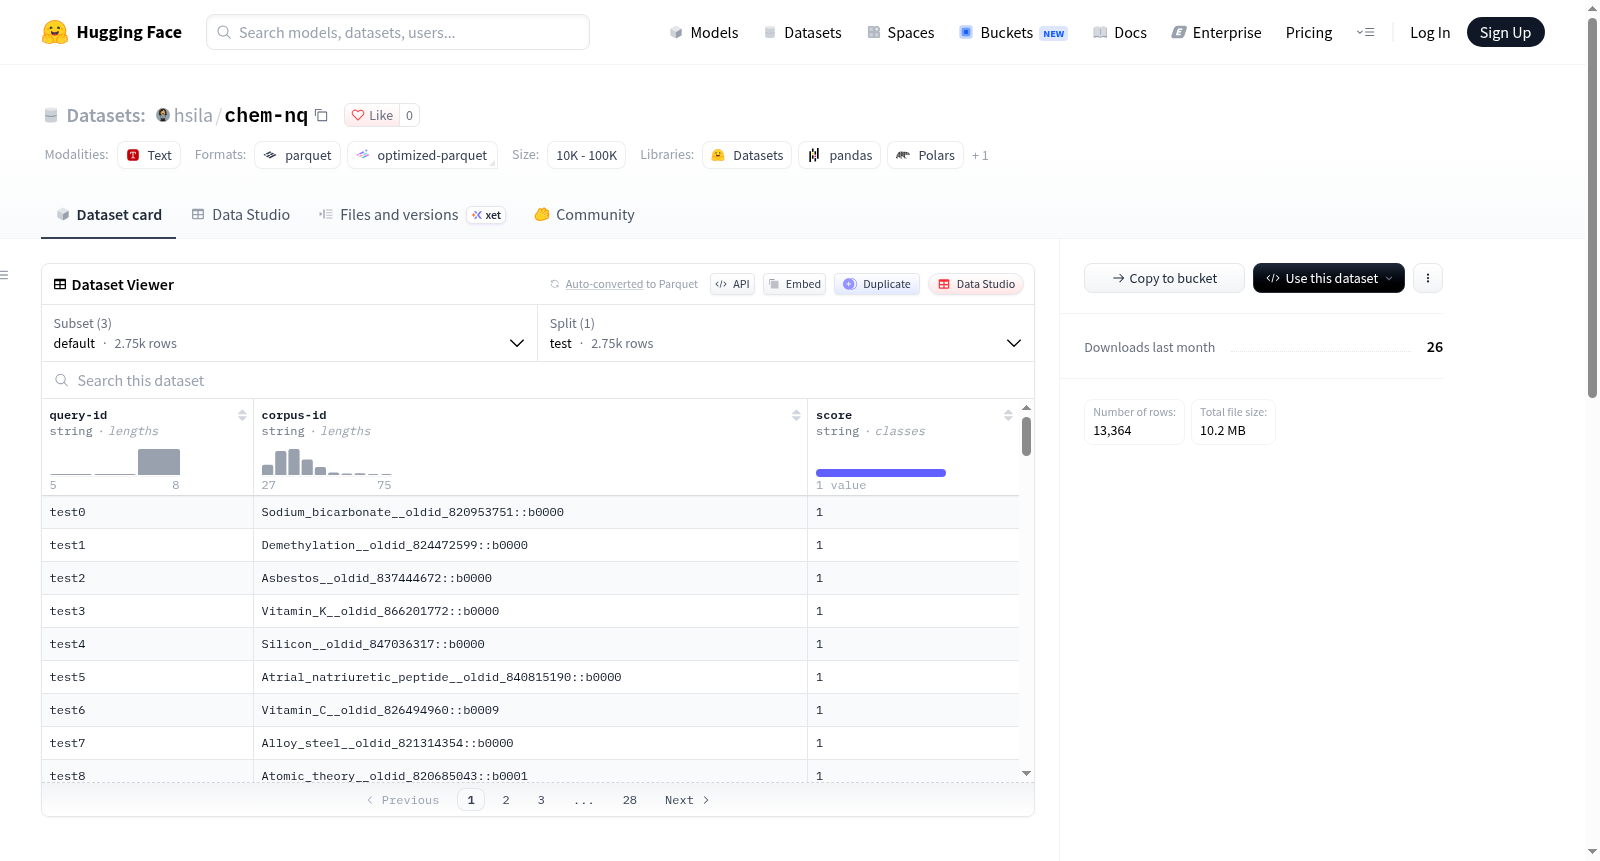
--- configs: - config_name: corpus data_files: - split: corpus path: corpus/corpus-* - config_name: queries data_files: - split: test path: queries/test-* - config_name: default data_files: - split: test path: data/test-* --- # chem-nq Chemistry-filtered subset of Google Natural Questions for MTEB/BEIR-style retrieval benchmarking. ## Data - Source: `rongzhangibm/NaturalQuestionsV2`. - Filtering: Wikipedia chemistry article-title match, followed by LLM topic classification. - Corpus granularity: one row per retained Wikipedia H2 section. - Lead sections use `section: "summary"`. - H3-H6 headings are merged into the parent H2 text block and are not embedded as headings in `text`. - Table-only, gallery-only, references, further reading, external links, and see-also sections are dropped. ## Configs - `corpus` / `corpus`: 7,874 rows. - Columns: `_id`, `title`, `section`, `text`. - `queries` / `test`: 2,745 rows. - Columns: `_id`, `text`. - `default` / `test`: 2,745 rows. - Columns: `query-id`, `corpus-id`, `score`. ## Notes The `section` column is intentionally kept as corpus metadata instead of prefixing headings into `text`. This preserves clean retrieval text while allowing analysis of which Wikipedia section answered a query.
The chem-nq dataset is a chemistry-filtered subset of Google Natural Questions for MTEB/BEIR-style retrieval benchmarking. The data is sourced from rongzhangibm/NaturalQuestionsV2 and filtered through Wikipedia chemistry article-title matching and LLM topic classification. The corpus granularity is one row per retained Wikipedia H2 section, with lead sections using section: "summary". H3-H6 headings are merged into the parent H2 text block and are not embedded as headings in text. Table-only, gallery-only, references, further reading, external links, and see-also sections are dropped. The dataset includes three configs: corpus with 7,874 rows and columns _id, title, section, text; queries with 2,745 rows and columns _id, text; default with 2,745 rows and columns query-id, corpus-id, score. The section column is intentionally kept as corpus metadata to preserve clean retrieval text while allowing analysis of which Wikipedia section answered a query.