gimmy256/adaption-primary-six-curriculum-samples
收藏资源简介:
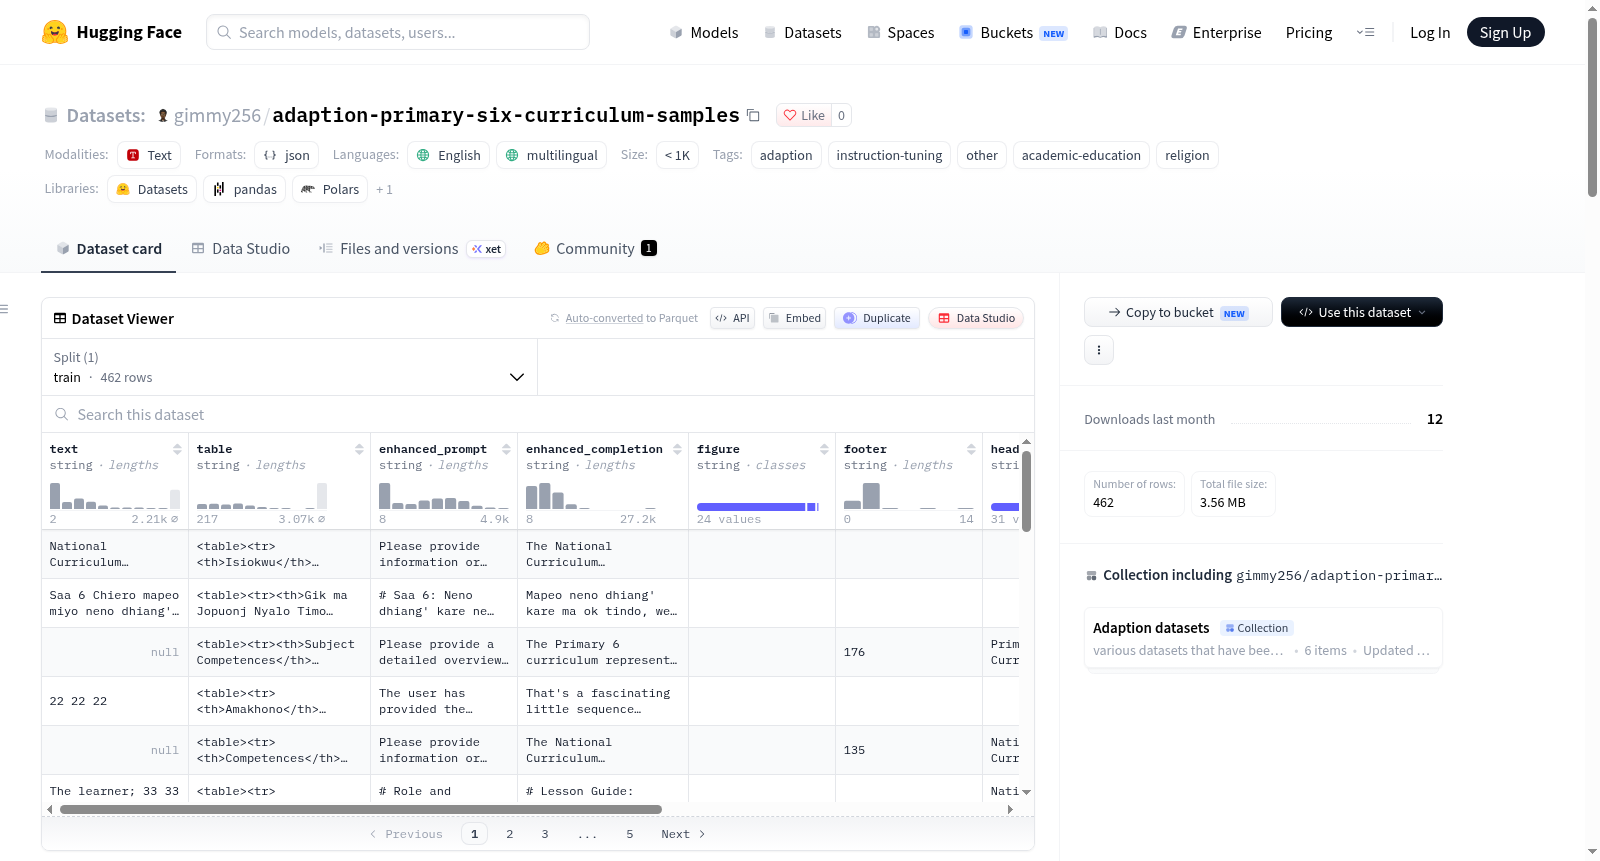
--- annotations_creators: [] language: - en - multilingual language_creators: [] license: [] multilinguality: - multilingual pretty_name: 'adaption-primary_six_curriculum_samples' size_categories: - n<1K source_datasets: - 'original' tags: - adaption - instruction-tuning - other - academic-education - religion task_categories: [] task_ids: [] ---  This dataset is a remastered version prepared using [Adaption's](https://adaptionlabs.ai/app/auth) Adaptive Data platform. # adaption-primary_six_curriculum_samples This dataset contains excerpts from a Primary Six curriculum guide, featuring instructional prompts and structured tables detailing competences, content, and suggested activities. The samples cover diverse subjects including language arts, science, religious education, and vocational skills like carpentry. Data entries often pair teaching guidelines with specific learning outcomes or indicate missing completions with 'None'. ### Dataset size There are 462 data points in this dataset. This is an instruction tuning dataset. ### Quality of Remastered Dataset The final quality is B, with a relative quality improvement of 170.0%. ### Domain - Other (50%) - Academic-education (42%) - Religion (4%) ### Language - English (66%) - Unknown (34%) ### Tone - Educational (42%) - Clear (24%) - Helpful (14%) ### Evaluation Results - **Quality Gains:** <img src="https://proteus-prod-public.s3.us-east-1.amazonaws.com/temp/86fef5b1-f05f-486a-9fac-0b86f7131653.png" alt="QualityGains" style="max-width: 50%; display: block; margin-left: auto; margin-right: auto;" /> - **Grade Improvement:** <img src="https://proteus-prod-public.s3.us-east-1.amazonaws.com/temp/2ad24252-487d-48f5-a3ac-13c83f3524d2.png" alt="Grade" style="max-width: 50%; display: block; margin-left: auto; margin-right: auto;" /> - **Percentile Chart:** <img src="https://proteus-prod-public.s3.us-east-1.amazonaws.com/temp/ac362d8b-894c-488c-bdf7-9530b6e5f113.png" alt="Percentile Chart" style="max-width: 50%; display: block; margin-left: auto; margin-right: auto;" />
This dataset is a remastered version prepared using Adaptions Adaptive Data platform. It contains excerpts from a Primary Six curriculum guide, featuring instructional prompts and structured tables detailing competences, content, and suggested activities. The samples cover diverse subjects including language arts, science, religious education, and vocational skills like carpentry. Data entries often pair teaching guidelines with specific learning outcomes or indicate missing completions with None. There are 462 data points in this dataset, and it is an instruction tuning dataset. The final quality is B, with a relative quality improvement of 170.0%. Domain distribution: Other (50%), Academic-education (42%), Religion (4%). Language distribution: English (66%), Unknown (34%). Tone distribution: Educational (42%), Clear (24%), Helpful (14%).